AlloyDB AI propose en prévisualisation deux fonctions SQL, ai.classify et ai.extract, pour traiter le texte non structuré sans quitter la base. Un smart batching regroupe les requêtes vers Gemini Enterprise Agent afin d’accélérer l’inférence et d’optimiser les tokens.
Smart batching pour accélérer et réduire les tokens
AlloyDB applique un smart batching aux fonctions d’IA, qui regroupe automatiquement les entrées lorsqu’elles apparaissent dans des expressions de clause WHERE. Ces micro-batchs sont ensuite envoyés aux modèles via la plateforme Gemini Enterprise Agent. Ce dispositif permet une exécution plus rapide qu’une évaluation ligne par ligne et réduit les dépenses totales en tokens en optimisant les surcharges d’entrée. Le smart batching portait auparavant le nom d’AI Function Acceleration. En rapprochant le traitement des données, cette approche limite aussi la complexité applicative et les risques liés au transfert d’informations sensibles.
Des cas d’usage opérationnels dans plusieurs secteurs
Les fonctions ont été développées pour répondre à des besoins pratiques dans le domaine de la santé, notamment la transformation de notes cliniques en enregistrements structurés tout en maintenant les données dans la base. Dans le secteur des services financiers, elles servent à extraire des éléments comme les informations fournisseurs, les dates de facturation et les montants des lignes à partir de documents numérisés. Dans le domaine juridique, elles permettent d’identifier la législation applicable, les limites de responsabilité et les délais de préavis de résiliation dans des contrats. Pour l’immobilier, elles rendent possible l’extraction de catégories de biens, du nombre de chambres et des plages de prix à partir de descriptions d’annonces. Elles sont aussi capables de renseigner des graphes de connaissances en entités et relations dans PostgreSQL Property Graph.
ai.classify classe le texte sans prompts sur mesure
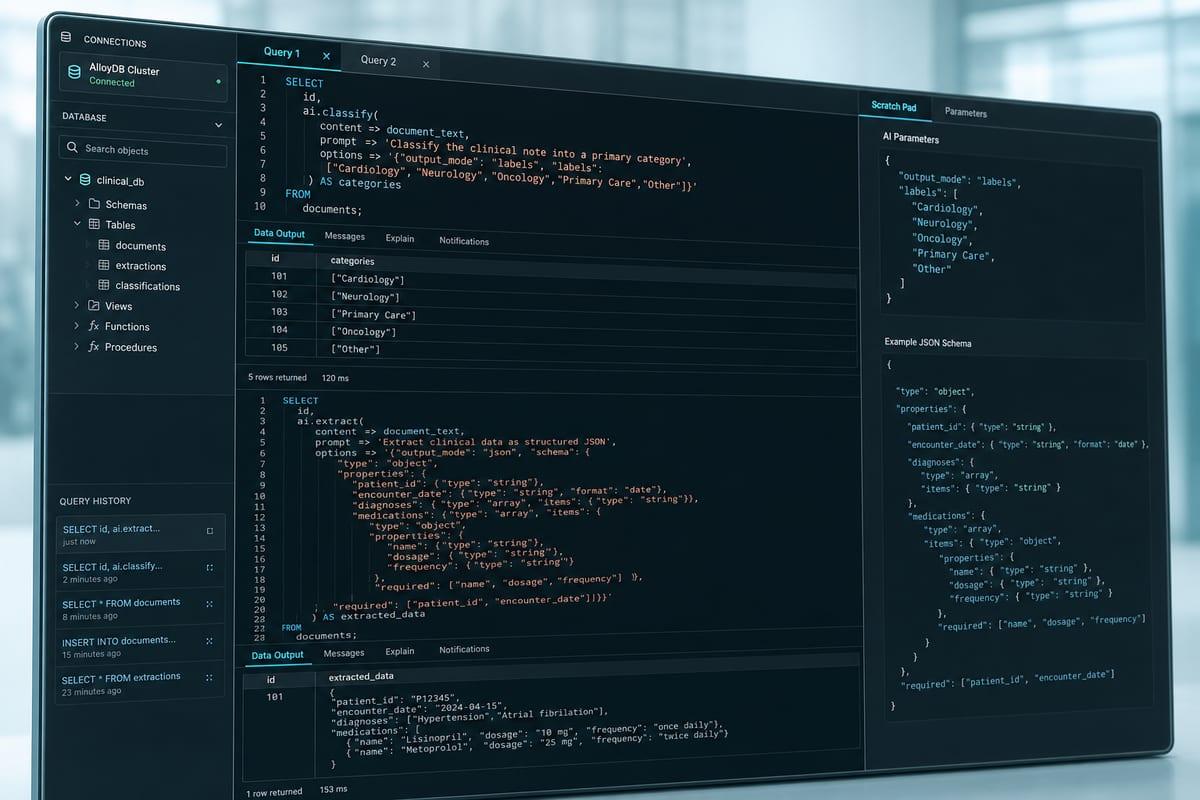
La fonction ai.classify permet de catégoriser du texte selon des classes définies par l’utilisateur, sans nécessiter d’ingénierie de prompt. Les catégories peuvent être transmises sous forme d’étiquettes simples ou enrichies de descriptions pour préciser le contexte. Elle propose un mode étiquette unique via output_mode = 'single' et un mode multi-étiquettes via output_mode = 'multi'. Les descriptions de catégories peuvent être structurées en tableaux 2D, et il est possible de fournir des exemples en ligne pour le few-shot prompting. L’exécution accepte des entrées de type TEXT, des tableaux TEXT[] et des curseurs REFCURSOR, avec la possibilité de spécifier un batch_size lors d’appels en tableau. Ces fonctions permettent de réaliser des classifications et des extractions structurées directement en SQL standard dans la base.
Vous voulez les meilleurs outils IA avant les autres ?
On teste et on décrypte les nouveaux outils IA chaque soir, en 5 min. Gratuit.
Inclus dès l'inscription : notre sélection des meilleurs guides & comparatifs IA.
Choisissez votre rythme
Gratuit · Pas de spam · Désabonnement en 1 clic
ai.extract produit un JSON conforme à un schéma fourni
La fonction ai.extract convertit du texte libre en un JSON structuré conforme à un schéma cible. Ce schéma peut être défini en JSON standard ou comme une liste de champs en texte. Les instructions système sont gérées en interne, ce qui évite d’écrire des prompts ou des parseurs de réponse. Plusieurs signatures sont proposées pour traiter une ligne, des tableaux ou des curseurs en batching. Un exemple d’extraction montre la récupération de champs cliniques comme le nom du patient, l’âge, les symptômes et les médicaments à partir d’une note médicale.
Disponibilité, intégration et feuille de route
Les fonctions ai.classify et ai.extract sont proposées en prévisualisation dans AlloyDB AI. Elles sont accessibles via l’extension google_ml_integration à partir de la version 1.6.1 et sont compatibles avec PostgreSQL 18. Les capacités de Gemini sont directement embarquées dans le moteur de la base de données, sans recours à un service externe. Selon la feuille de route, plusieurs évolutions sont prévues, parmi lesquelles une gestion avancée des coûts, une traçabilité de la provenance au niveau des lignes et la possibilité d’effectuer des pushdowns de requêtes dépassant les clauses WHERE. Pour accéder aux fonctions en prévisualisation, il suffit de définir un paramètre de session spécifique. La documentation du moteur AlloyDB AI et les notes de version constituent les ressources de démarrage recommandées. Cette intégration vise à simplifier des chaînes applicatives historiquement complexes, qui impliquaient export, appels à des endpoints de modèles, gestion de prompts et de réessais, et mises à jour en base, avec des effets de latence et des enjeux de conformité liés aux transferts de données.