La recherche en IA te passionne ?
Les papers et avancées qui comptent, expliqués simplement, chaque soir. Gratuit.
Inclus dès l'inscription : notre sélection des meilleurs guides & comparatifs IA.
Choisis ton rythme
Gratuit · Pas de spam · Désabonnement en 1 clic
Un petit réseau de neurones, parfait sur l’entraînement mais médiocre en test après 1 000 étapes, a fini par résoudre presque parfaitement de nouveaux problèmes vers 20 000 étapes, sans données ni réglages supplémentaires. Des analyses internes ont montré une représentation circulaire des nombres, découverte par descente de gradient, et une bascule tardive d’une solution mémorisée vers une méthode générale. Le phénomène, baptisé « grokking », interroge l’usage de l’arrêt précoce et la lecture de métriques plates.
Des métriques trompeuses et l’arrêt précoce en question
Observé uniquement via l’exactitude en entraînement et en test, le grokking ressemble à une longue phase plate suivie d’une bascule soudaine. Une règle d’arrêt précoce standard aurait presque interrompu ce basculement, ces règles visant précisément à couper l’entraînement lorsqu’aucune amélioration n’apparaît. Cette situation pose la question de sa fréquence dans des modèles plus vastes et importants, éventuellement arrêtés avant l’émergence d’une solution générale ; il n’existe pas encore de réponse complète. On ignore si un mécanisme similaire se produit de façon invisible dans les grands modèles actuels. De l’extérieur, mémorisation et compréhension peuvent paraître identiques jusqu’au point de divergence, et une formation en apparence « immobile » peut précéder un changement décisif.
Une bascule tardive quantifiée sur une tâche simple
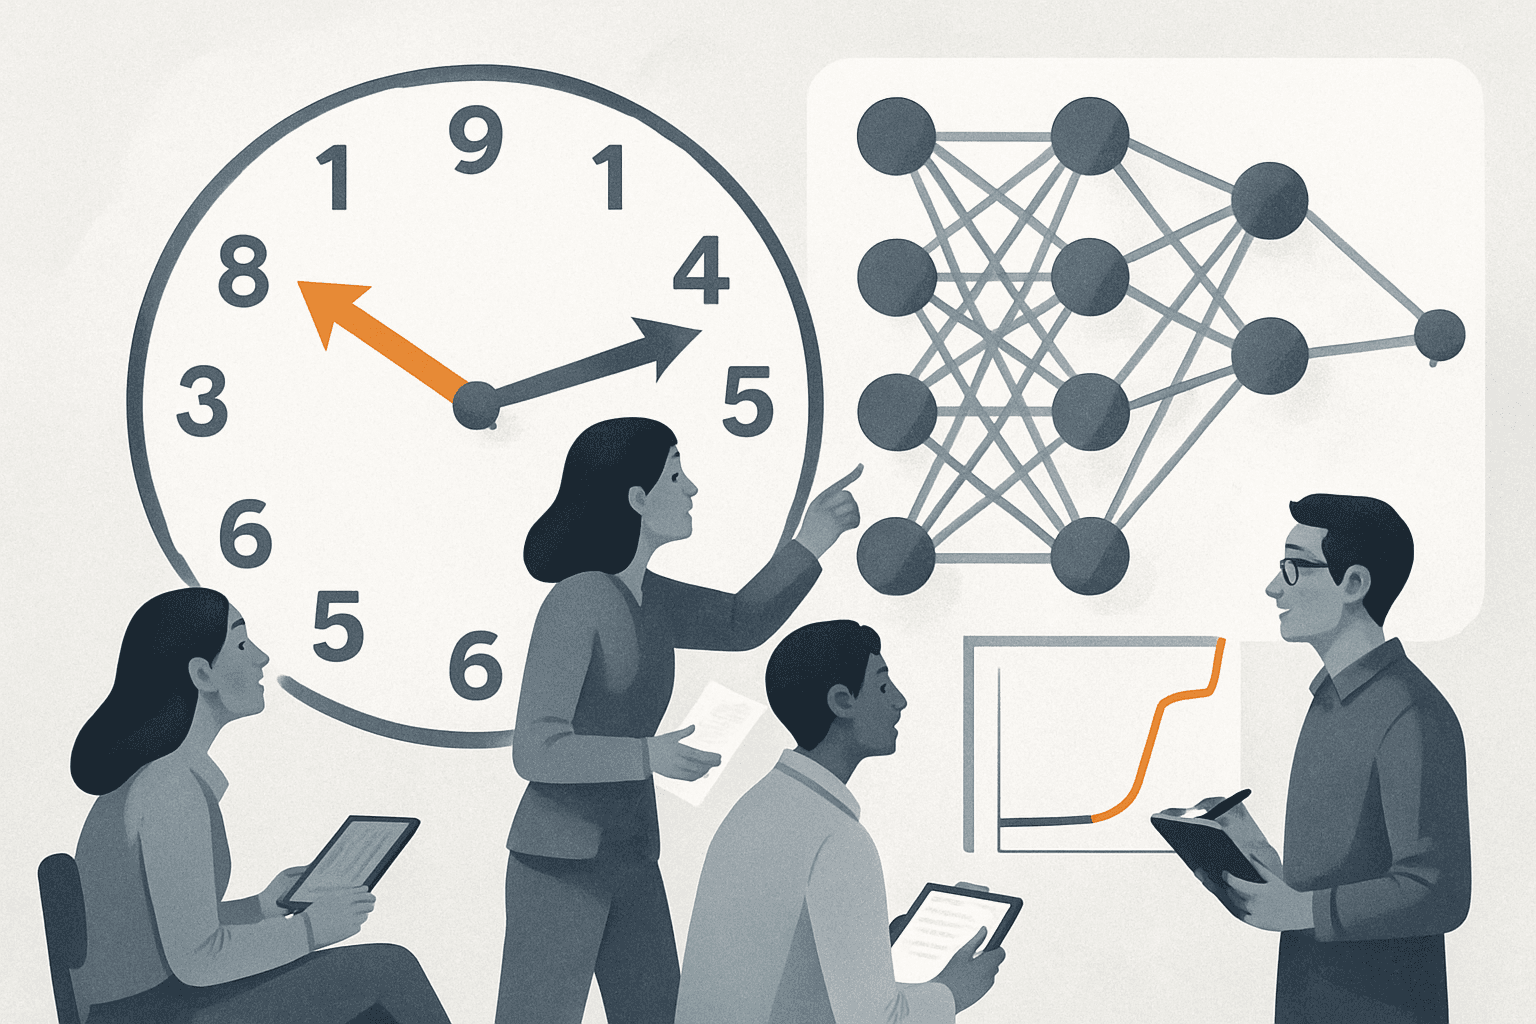
Sur l’addition modulaire, le réseau a atteint en moins de 1 000 étapes un score parfait sur les données d’entraînement, tout en restant à environ 10 % sur des problèmes inédits. Les chercheurs ont poursuivi l’entraînement, ajoutant des milliers puis des dizaines de milliers d’étapes sans modifier la procédure ni introduire de nouvelles données. À un moment donné, la performance sur des questions non vues a bondi pour approcher 100 %, et vers 20 000 étapes, l’exactitude était proche de 100 % à la fois en entraînement et en test. Ce décalage marqué entre réussite immédiate sur l’entraînement et généralisation tardive a été nommé « grokking ».
Ce que le réseau a construit à l’intérieur, pièce par pièce
L’examen interne du modèle, poursuivi jusqu’à une étude de suivi en 2023, a montré l’émergence d’une représentation circulaire des nombres et l’usage de rotations pour les combiner, redécouvrant la trigonométrie sans supervision explicite. La descente de gradient a élaboré cette méthode, où chaque nombre occupe un point du cercle et l’addition correspond à deux rotations successives avant lecture de la position finale. La construction de cette structure a pris du temps, coexistant avec une solution mémorisée limitée aux exemples familiers. La méthode générale a pris le dessus lorsqu’elle a été assez complète pour surpasser la mémorisation. Vue de l’extérieur, la phase de construction semblait nulle ; à l’intérieur, c’était le cœur du processus.
Cadre de l’expérience et échec initial de généralisation
En 2022, une petite équipe a entraîné un réseau de neurones minuscule sur l’addition modulaire, illustrée par 8 plus 7 égalant 3 sur une horloge à 12. Le réseau a très vite maîtrisé les réponses d’entraînement, mais a d’abord échoué à généraliser, un schéma classique de mémorisation plutôt que d’apprentissage de la règle. Le dispositif expérimental n’impliquait ni grands modèles ni architectures spécifiques à ce stade.
Un mot de science-fiction pour nommer la bascule
Le terme « grokking » vient du roman de Robert Heinlein, Stranger in a Strange Land, où il désigne une compréhension si profonde qu’elle devient intuitive. Dans l’expérience, le modèle n’a pas progressé progressivement en simulant la bonne réponse : à un moment caché, il a cessé de simuler et a commencé à « savoir ». La leçon avancée ne porte pas en particulier sur des transformers ni sur l’arithmétique modulaire.
Une analogie scolaire pour situer le phénomène
L’analogie proposée est celle d’un étudiant qui, après avoir bachoté et mémorisé des réponses, continue de revoir le même contenu. Des semaines plus tard, survient un déclic : il comprend réellement le sujet et réussit des problèmes nouveaux. Ce déclic intervient longtemps après que l’étudiant semblait avoir terminé ses révisions.