Servir un LLM en production ne se résume pas à charger des poids dans une bibliothèque. Huit cadres spécialisés couvrent la gestion du cache, le regroupement des requêtes et les API, du datacenter aux machines locales. Leur point commun : augmenter la concurrence et baisser la latence sans toucher aux modèles.
Exécuter localement ou en périphérie : trois voies concrètes
Sur des postes ou des dispositifs contraints, llama.cpp propose un runtime en C/C++ sans dépendances externes, capable de tourner sur des GPU grand public comme sur des machines uniquement CPU. Son faible encombrement facilite les déploiements, et le composant llama-server offre un serveur HTTP compatible OpenAI avec décodage parallèle et regroupement continu, utile pour des réponses à faible latence sur une requête à la fois. La mise en route locale se fait en quelques minutes via son dépôt. Ollama vise une expérience prête à l’emploi en local, en regroupant téléchargement des modèles, versioning et service derrière une CLI et une API. Il accepte des requêtes parallèles par modèle via OLLAMA_NUM_PARALLEL, met les suivantes en file d’attente jusqu’à OLLAMA_MAX_QUEUE et alloue la mémoire en emplacements parallèles fixes, l’usage croissant avec le parallélisme et la longueur de contexte. Il cible des usages d’utilisateur unique ou de petite équipe, tandis que des pointes de simultanéité nombreuses bénéficient des mécanismes de vLLM ou SGLang. Sa documentation couvre installation, catalogue de modèles et paramètres de concurrence. Pour des cibles hétérogènes, MLC-LLM s’appuie sur Apache TVM pour compiler les bibliothèques de modèles à la volée ou en amont pour le web, iOS et Android. Le même outil couvre Linux, Windows, macOS, iOS, Android et les navigateurs, et prend en charge des GPU AMD, NVIDIA, Apple et Intel. Un serveur REST compatible OpenAI propose un mode serveur qui accroît la concurrence des requêtes sur GPU dédiés. Les guides détaillent conversion de poids et compilation nécessaires aux déploiements mobiles et web.
Maximiser la vitesse sur GPU NVIDIA et la quantification
Dans des configurations exclusivement NVIDIA, TensorRT-LLM propose une bibliothèque d’inférence spécifique reposant sur l’écosystème TensorRT, conçu pour réduire la latence. Cette solution gère le regroupement dynamique, un cache KV paginé exploitant la réutilisation de blocs, ainsi que diverses quantifications basse précision, parmi lesquelles FP8 pour les H100 et générations suivantes, FP4 pour les GPU Blackwell et AWQ en INT4. L’intégration au Triton Inference Server s’effectue à l’aide d’un backend spécifique, et le dépôt fournit la documentation sur la construction ainsi que la matrice de compatibilité des modèles. Cette spécialisation tend à se traduire par un gain de vitesse sur une flotte entièrement NVIDIA. Pour conjuguer débit de décodage et compression mémoire, LMDeploy réunit deux moteurs, TurboMind en C++/CUDA et un moteur PyTorch. Il met en œuvre un lot persistant et un cache KV bloqué pour la simultanéité, prend en charge des quantifications des seuls poids comme AWQ 4 bits, ainsi que la quantification du cache KV en INT8/INT4. La mise en cache automatique des préfixes peut s’activer en parallèle de la quantification. Deux API, hors ligne et serveur, permettent des comparaisons sur un même modèle et matériel, et les guides recensent modèles pris en charge et options.
Vous codez avec l’IA ?
Outils, agents et nouveautés dev IA décryptés, chaque soir en 5 min. Gratuit.
Inclus dès l'inscription : notre sélection des meilleurs guides & comparatifs IA.
Choisissez votre rythme
Gratuit · Pas de spam · Désabonnement en 1 clic
Orchestration des flux à grande échelle et compatibilités API
Pour un service à fort trafic, vLLM est un choix fréquent. Son mécanisme PagedAttention segmente le cache KV en petits blocs, ce qui augmente le nombre de requêtes regroupées par GPU. Le regroupement continu autorise l’arrivée de nouvelles requêtes dans un lot en cours, et un serveur compatible OpenAI limite les modifications côté client. vLLM fonctionne à la fois comme bibliothèque pour des traitements hors ligne et comme serveur autonome, sur GPU NVIDIA, AMD et Intel, ainsi que sur CPU et TPU. La documentation couvre aussi le découpage de modèles via le parallélisme tensoriel. SGLang combine un backend rapide et un langage de description des interactions avec le modèle, utile pour des enchaînements de prompts complexes avec branches. La co-conception backend/frontend donne un contrôle fin sur des générations multi-étapes, tandis que RadixAttention réutilise le cache KV pour des requêtes partageant un préfixe. Le système prend en charge des sorties structurées et le décodage contraint pour, par exemple, des retours JSON ou des appels d’outils. Outre le service des LLM, SGLang sert des modèles de diffusion pour l’image et la vidéo et offre un mode serveur ainsi qu’un moteur embarqué.
Ce que ces cadres apportent face aux bibliothèques génériques
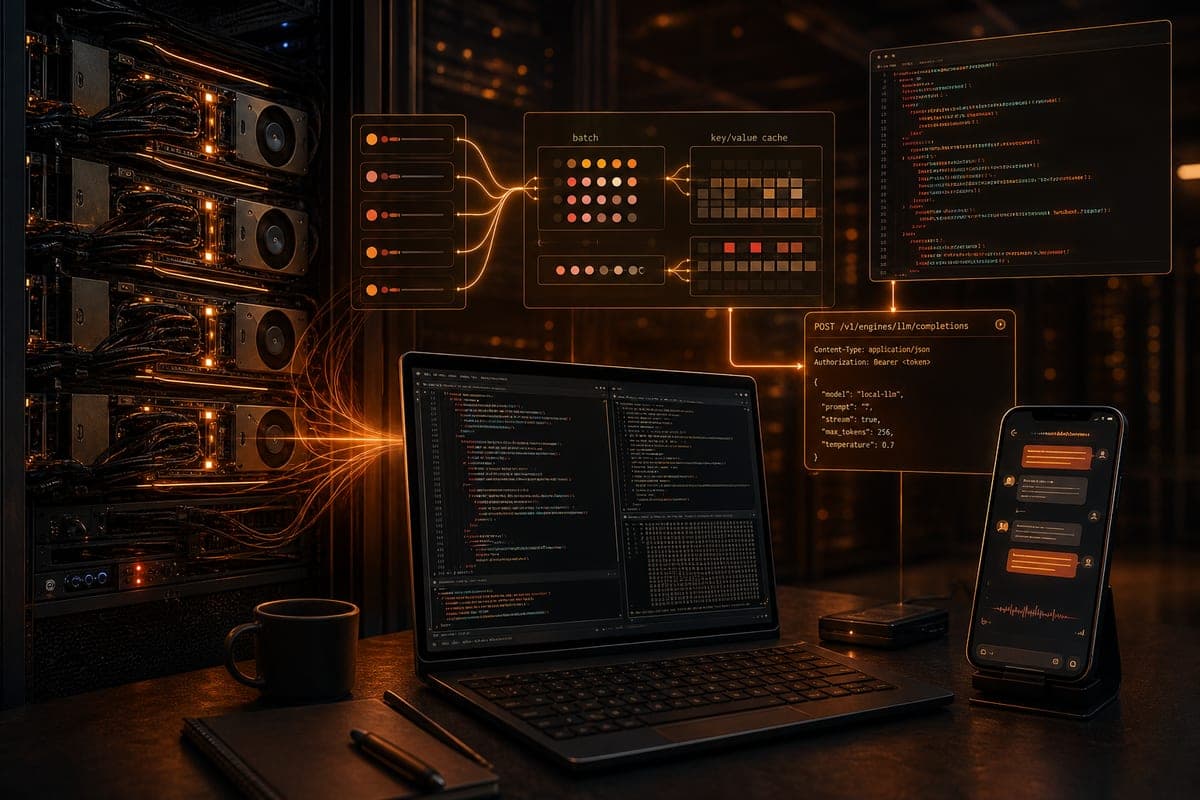
Une application de production reçoit des flots de requêtes, chacune requérant mémoire pour le cache KV, une place dans un lot et un flux de sortie. Si PyTorch ou Transformers suffisent à servir un modèle, la file d’attente, le cache et l’API restent à construire. Les cadres d’inférence encapsulent ces couches : génération de tokens, gestion du cache et du lot, et interface API. À la clé, davantage de requêtes simultanées et une latence plus faible, sans modifier les poids. L’offre couvre aussi bien des déploiements à haut débit en centre de données que des contextes locaux, périphériques ou à ressources limitées.
Personnalisation bas niveau et critères de choix
Certaines équipes recherchent un contrôle plus profond. MAX, le cadre de Modular, fonctionne sur CPU et GPU, permet des personnalisations au niveau du modèle et des noyaux, et sert aussi des modèles de diffusion. Les options de service — taille de lot, usage mémoire, longueur de séquence — sont exposées via la commande max serve, avec une correspondance explicite aux capacités matérielles dans la documentation. Pour répartir un modèle sur plusieurs GPU, le parallélisme tensoriel documenté par vLLM est une autre brique utile. Le choix dépend du profil de trafic, du matériel disponible et des cibles de déploiement. Des charges d’utilisateurs uniques ou de petites équipes s’accommodent d’Ollama, tandis que des environnements avec de nombreux utilisateurs simultanés profitent des mécanismes de mise en lot et de cache paginé de moteurs comme vLLM ou SGLang. Des besoins multi-plateformes peuvent orienter vers MLC-LLM, pensé pour couvrir différentes classes d’appareils avec un même runtime.