À l'occasion de SC26 à Chicago, HyperAccel entend faire valoir une architecture LPU dédiée à l'inférence LLM. L'entreprise met en avant des gains d'efficacité par watt et par dollar et prépare une démonstration à distance depuis la Corée, tout en cherchant des partenaires pour déployer sa technologie en data centers.
HyperAccel vise des partenariats et l’adoption mondiale de sa LPU
HyperAccel souhaite renforcer sa présence internationale et accélérer l'adoption d'infrastructures d'inférence reposant sur sa LPU. L'entreprise cible des partenariats avec des fabricants de serveurs, des fournisseurs de services cloud et des acteurs de l'infrastructure AI. Les priorités annoncées portent sur l'intégration de plateformes serveur, la validation technique et le développement commercial sur les marchés mondiaux des centres de données. Selon son CEO Joo-Young Kim, l'industrie se tourne désormais vers l'efficacité et l'économie de l'inférence AI à grande échelle, au-delà de la seule performance brute. Il affirme que l'architecture LPU permet une efficacité des jetons supérieure au niveau serveur, réduisant coûts et consommation d'énergie, et souhaite collaborer avec des partenaires d'infrastructure mondiaux pour commercialiser des solutions AI plus efficaces et évolutives.
Des performances revendiquées supérieures à des GPU Blackwell
Les tests internes réalisés par HyperAccel indiquent qu’un serveur doté de cartes LPU consommant 250 W chacune délivrerait un débit de jetons supérieur de plus de 3,5 fois par watt et par dollar, comparé à une configuration équivalente équipée de GPU NVIDIA RTX PRO 6000 Blackwell Server Edition de 600 W par carte, lors de l’utilisation des modèles Qwen3-32B et Llama3-70B. HyperAccel indique aussi que ses LPU sont compatibles avec des modèles LLM de taille supérieure, tels que Kimi et GLM. Sur le plan technique, la LPU associe une mémoire LPDDR5X à faible consommation et l’architecture Streamlined Dataflow. Selon l’entreprise, cette solution permet d’atteindre environ 90 % d’utilisation de la bande passante mémoire, alors que les GPU se situent entre 50 et 60 %, ce qui, d’après elle, aide à diminuer la consommation énergétique et les frais d’exploitation dans les environnements d’inférence à grande échelle.
Vous suivez la course aux modèles IA ?
Chaque sortie (GPT, Claude, Gemini, Mistral…) décryptée le soir même, en 5 min. Gratuit.
Inclus dès l'inscription : notre sélection des meilleurs guides & comparatifs IA.
Choisissez votre rythme
Gratuit · Pas de spam · Désabonnement en 1 clic
Une démonstration à distance et un serveur à huit LPU sur le salon
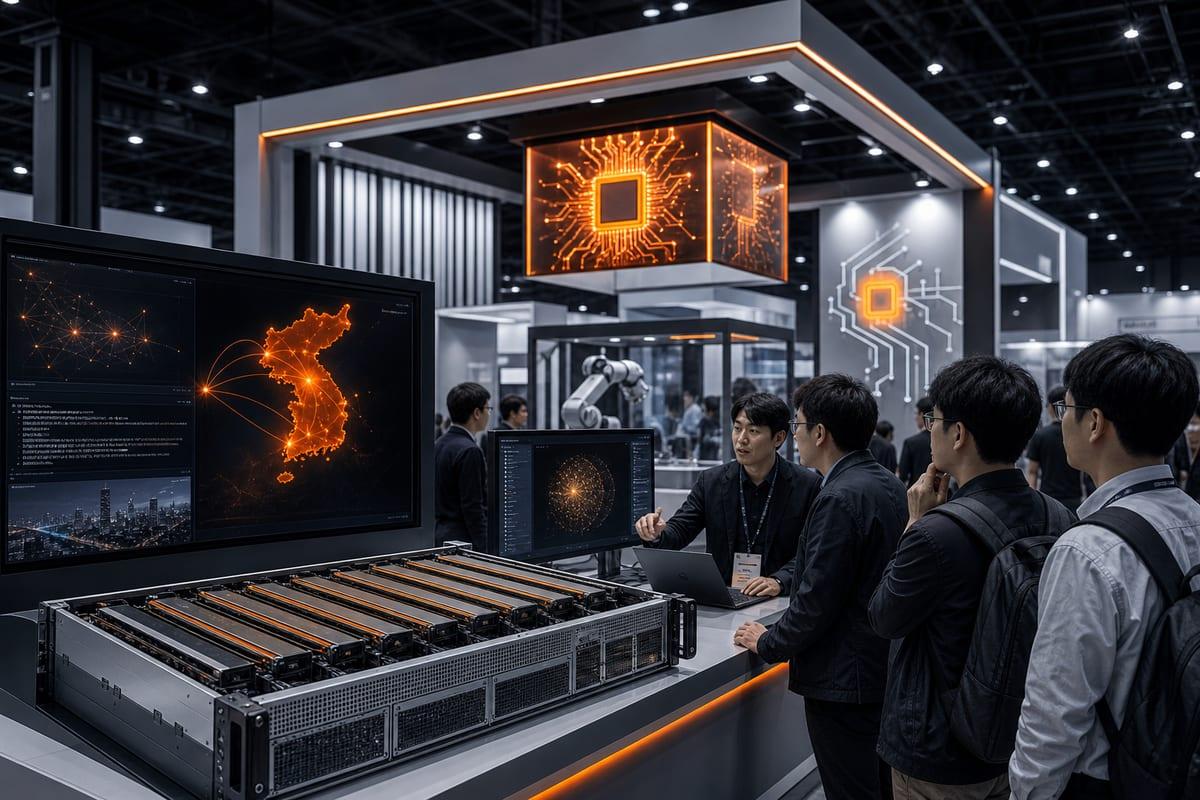
HyperAccel présentera sur place un système serveur intégrant huit LPU. Une démonstration à distance, en direct, doit montrer l'inférence LLM exécutée sur des serveurs opérationnels déployés en Corée. L'exposition vise à illustrer le fonctionnement de la LPU à l'échelle d'un serveur, au-delà du composant individuel, pour constituer une infrastructure AI exploitable. Les visiteurs pourront se renseigner sur la technologie, explorer le serveur à huit LPU et assister à la démonstration à distance afin d'observer l'inférence sur du matériel en production et d'évaluer le potentiel pour des déploiements en entreprise et en centres de données.
SC26 à Chicago : dates, lieux et prises de parole
La présentation de la technologie LPU par HyperAccel est prévue à SC26, organisé au McCormick Place à Chicago. L'événement se tiendra du 17 au 19 novembre 2026. L'équipe accueillera les visiteurs au Pavillon AI Semiconductor Korea, stand #1411. Par ailleurs, Joonyeon Kim, CFO de la société, interviendra le 18 novembre de 14h30 à 14h45 (heure centrale) sur le stand #4630 de Lablup Inc., avec une session intitulée « Redéfinir l'infrastructure AI grâce à l'efficacité des jetons ».
Profil de l’entreprise et lignes de produits
Fondée en 2023, HyperAccel est une entreprise sud-coréenne de semi-conducteurs AI sans usine, basée à Séoul et présente dans la Silicon Valley. Elle développe des LPU, des accélérateurs conçus pour l'inférence de grands modèles de langage. Sa gamme de produits inclut Bertha, destiné aux centres de données et aux entreprises, ainsi que Bertha-Edge, conçu pour l’intelligence artificielle embarquée. HyperAccel applique aussi sa technologie à des cas d’usage relevant de l’edge computing et de l’intelligence artificielle physique. L’entreprise a obtenu l’IEEE Micro Best Paper Award en 2025 et figure dans la liste Forbes Asia 100 To Watch 2026. Un communiqué est daté de Chicago, le 13 novembre 2026.