Une équipe de recherche mesure un avantage de 8,4 points de pourcentage pour les interfaces qu'un modèle d'IA génère à partir d'une synthèse assortie de recommandations, plutôt que de commentaires utilisateurs bruts. La comparaison porte sur un formulaire aérien et un parcours de paiement.
Les chercheurs explorent encore plusieurs limites
L'effet propre de chaque composante du contexte reste à préciser : l'équipe cherche à distinguer ce qui vient du regroupement des observations et ce qui tient aux recommandations de conception explicites. Elle examine aussi si l'amélioration dépasse les problèmes directement ciblés par les recommandations, pour toucher d'autres aspects des interfaces.
La portée des résultats au-delà de courts commentaires clients demeure également à explorer, qu'il s'agisse de la nature des données ou de leur volume. Leur reproduction avec d'autres modèles fait partie des questions ouvertes. Les recherches se poursuivent aussi sur l'influence du format transmis, notamment Markdown, PNG ou PDF, dans un programme consacré au contexte d'expérience utilisateur fourni à l'IA.
Un chercheur choisit les recommandations à transmettre
Dans l'expérience, chaque tâche dispose d'environ 100 commentaires. Les synthèses sont préparées à partir de ces mêmes retours : un chercheur s'aide d'un outil d'IA pour les analyser, mais conserve la décision finale sur les constats retenus et les recommandations transmises au modèle.
L'équipe avance une explication à l'avantage observé : une observation ne prescrit pas nécessairement une réponse. Signaler la disparition d'articles d'un panier décrit une difficulté, sans indiquer quelle interface construire. Une synthèse apporte une interprétation ; avec les seules données brutes, le modèle doit lui-même hiérarchiser les informations et choisir les modifications. Les chercheurs estiment ces arbitrages difficiles sans orientation humaine, les retours clients ne constituant qu'une donnée parmi d'autres.
Vous voulez les meilleurs outils IA avant les autres ?
On teste et on décrypte les nouveaux outils IA chaque soir, en 5 min. Gratuit.
Inclus dès l'inscription : notre sélection des meilleurs guides & comparatifs IA.
Choisissez votre rythme
Gratuit · Pas de spam · Désabonnement en 1 clic
Alors que les prototypes issus de l'IA entrent dans les pratiques quotidiennes, les outils peuvent déjà enchaîner analyse des retours, recommandations et génération d'interfaces. Leur capacité à absorber beaucoup de données ne garantit toutefois pas, avertit l'équipe, une sélection pertinente ni une exploitation correcte dans la conception. Elle préconise donc des supports destinés aux outils, en complément de ceux préparés pour les collègues.
La conception de contexte UX désigne précisément la sélection, l'organisation et l'entretien des connaissances d'expérience utilisateur qui orientent ces générations. Pour les chercheurs, identifier les problèmes importants pour un produit puis les traduire en recommandations reste un apport essentiel des professionnels concernés, que la réalisation soit humaine ou automatisée.
Les scores progressent sur les tâches évaluées
Les interfaces nourries par les synthèses accompagnées de recommandations remplissent en moyenne 77,9 % des critères d'évaluation, contre 69,5 % avec les retours bruts. L'écart est statistiquement significatif, avec p < 0,001. L'amélioration concerne les deux exercices, mais atteint 11,4 points de pourcentage pour le vol, contre 5,5 pour le paiement.
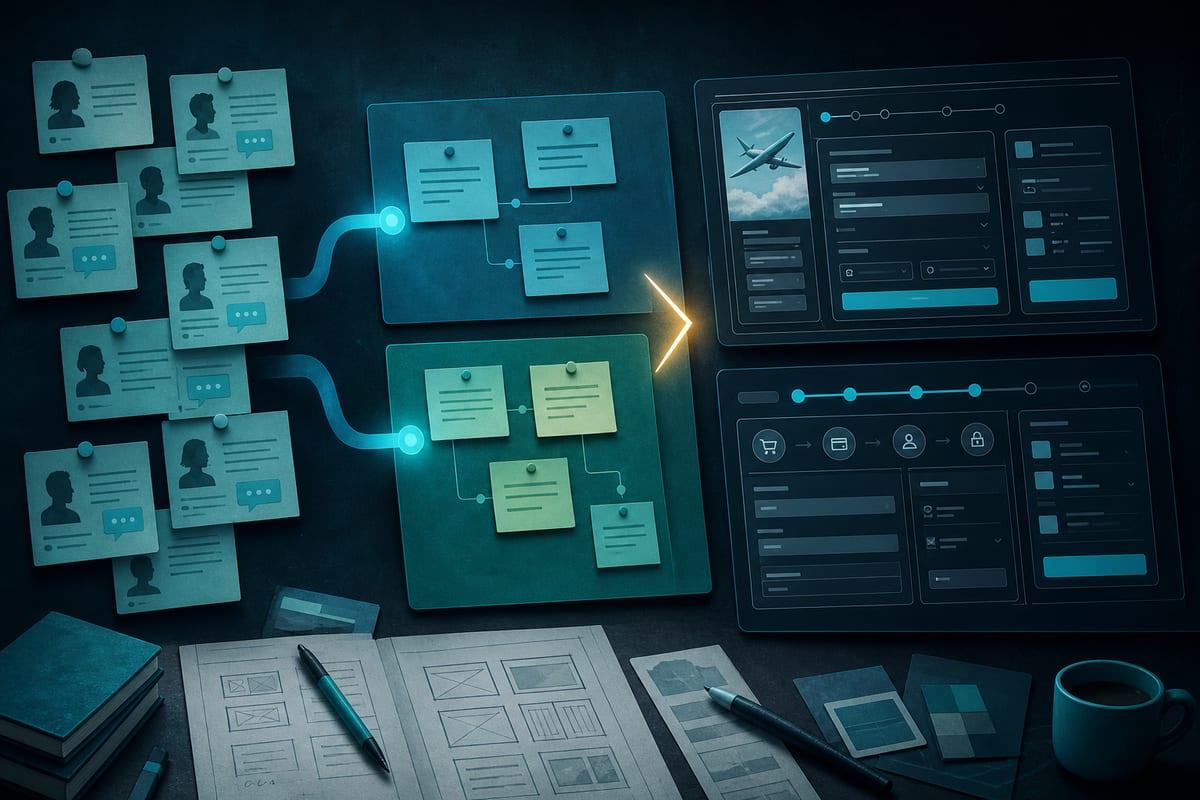
Dans le premier exercice, il faut créer un formulaire d'une page permettant de reprogrammer un vol annulé ; dans le second, un parcours de paiement en plusieurs étapes destiné à une boutique en ligne. Seul le contexte de recherche change pour chaque exercice, tandis que la consigne et les éléments du système de design demeurent inchangés. Le protocole complet est plus complexe que cette comparaison entre deux contextes.
Pour tenir compte du caractère non déterministe des outils, 8 interfaces sont produites pour chaque tâche et chaque condition. Un évaluateur humain ainsi qu'un modèle de langage les notent à l'aveugle selon des critères définis auparavant. Le score mesure la proportion de critères respectés, par exemple la présence des articles achetés à chacune des étapes du paiement.
Les chiffres retenus sont ceux de l'évaluation humaine. Le modèle de langage effectue une notation indépendante utilisée comme contrôle. Après calibration, les décisions des évaluateurs concordent dans environ 96 % des cas sur les deux exercices.