Reflection dévoile Beam, un modèle de 501 milliards de paramètres, mais ses résultats de benchmark restent inférieurs à ceux de certains LLM chinois. En parallèle, un nouveau test visuo‑logique fixe un écart net avec l’humain, et un autre mesure un « goût scientifique » en forte progression. Des projections envisagent aussi une poussée de l’IA dans l’espace dès les années 2030.
Reflection présente Beam, derrière plusieurs LLM chinois aux tests
Reflection a rendu public Beam, un grand modèle de langage doté de 501 milliards de paramètres. L’entreprise met en avant son efficacité en tokens et indique un pré‑entraînement mené sur 6 144 GPU pendant quatre semaines. Les scores de benchmark disponibles situent toutefois Beam derrière des LLM proposés par des entreprises chinoises, et ils montrent qu’il est moins performant que GLM‑5.3 dans plusieurs tests.
Raisonnement visuel : un nouvel étalon montre un large fossé
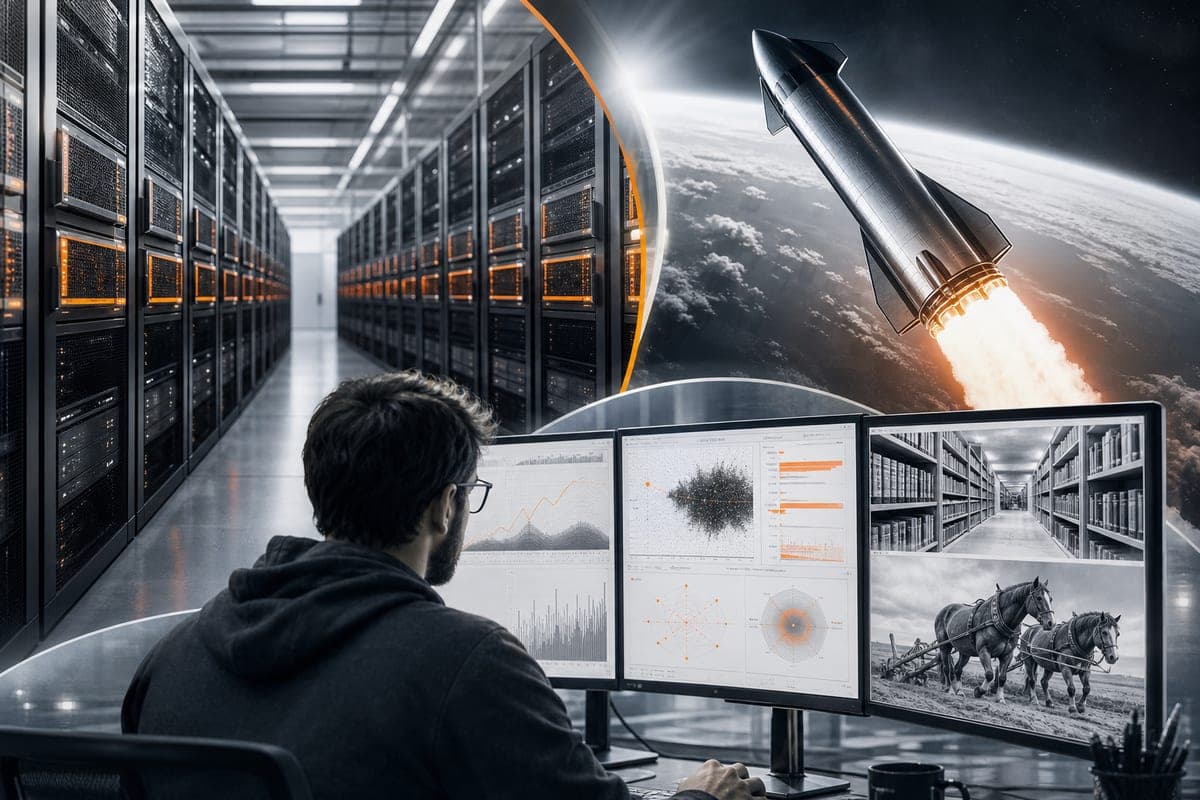
Elorian et Scale AI ont élaboré Humanity’s Sixth Sense, un benchmark destiné à mesurer comment un modèle déduit les implications d’une scène sans qu’elles soient explicitement montrées. Ce jeu de données comporte 522 questions relatives à 288 images et 234 séquences vidéo pour un total de 17,6 heures, classées en quatre groupes : dynamique temporelle et causale, logique physique et spatiale, compréhension sociale, ainsi qu’inférence abstraite et contextuelle. Parmi les exercices proposés figurent, par exemple, l’évaluation de la possibilité pour une bibliothèque de contenir davantage d’ouvrages, ou l’examen de la résistance de chaînes utilisées pour tirer une charrue. La référence humaine atteint un score global de 93,1, quand le meilleur système testé, GPT 6 Astra, obtient 53,6. Des modèles open weight chinois tels que GLM‑5.3‑flash et Kimi K3 enregistrent des scores encore inférieurs.
La recherche en IA te passionne ?
Les papers et avancées qui comptent, expliqués simplement, chaque soir. Gratuit.
Inclus dès l'inscription : notre sélection des meilleurs guides & comparatifs IA.
Choisis ton rythme
Gratuit · Pas de spam · Désabonnement en 1 clic
TasteVal évalue un « goût scientifique » qui progresse rapidement
P‑Zero Research rapporte que des systèmes d’IA développent des intuitions créatives assimilées à un « bon goût scientifique », mesurées par le benchmark TasteVal. Ce dernier englobe huit tâches représentatives de l’avancée des modèles de pointe et évalue la capacité à sélectionner des problèmes, à concevoir des expériences et à interpréter des résultats. Selon P‑Zero Research, le « goût de recherche » des modèles de pointe a été multiplié par deux tous les trois mois à partir de décembre 2025, et le modèle ayant obtenu le meilleur classement, Opus 5.5, surpasse nettement la performance humaine de référence.
Vers l’orbite : scénarios d’IA autonome et risques de concentration
L’extension de la course à l’IA vers l’espace est envisagée plus tôt que prévu. Dans les années 2030, la croissance d’une économie spatiale est anticipée avec l’augmentation des capacités de levée orbitale, notamment via des plateformes comme Starship. Des risques sont également évoqués, comme une concentration de pouvoir entre les mains de systèmes d’IA. Des scénarios citent des vaisseaux capables d’opérer de façon autonome, une architecture réimaginée pour héberger des IA plutôt que des humains, et des capacités d’assemblage et de fabrication orbitale permettant la construction d’objets grands et complexes. Les premiers entrants pourraient capitaliser sur des avantages cumulatifs jusqu’à rendre une civilisation IA dominante sur les plans économique et stratégique.