Devansh Srivastav et Xiao Zhang rapportent plus de 90 % de réussite dans certaines configurations expérimentales de contournement des protections de modèles par plusieurs agents. Ce résultat ne mesure pas une proportion de systèmes professionnels compromis. Pour les entreprises, les conséquences possibles dépendent aussi des outils accessibles et des droits accordés à chaque composant.
Les permissions déterminent les actions possibles
L'OWASP a fait paraître le 9 décembre 2025 son Top 10 des applications agentiques 2026. L'organisation y traite des objectifs détournés, des abus d'outils ainsi que des communications entre agents, sans déclarer vulnérables toutes les architectures. Recenser les intégrations, les secrets accessibles et les opérations autorisées aide à séparer un incident de génération de texte d'un risque pour les opérations.
Une réponse inappropriée ne prouve pas qu'un modèle puisse consulter des données internes. Un assistant cantonné à la rédaction peut donner un conseil erroné ; un agent habilité à modifier du code, à lire des documents confidentiels ou à expédier des messages dispose de moyens plus sensibles. S'il accepte une fausse consigne, il pourrait, dans certaines circonstances, effectuer une modification ou un partage indésirable. Le détournement ne lui ajoute toutefois aucun privilège : son périmètre d'action dépend des autorisations existantes et des vérifications précédant l'exécution.
Une chaîne de développement logiciel permet d'illustrer cette propagation possible. Une donnée trompeuse admise pendant l'analyse d'une demande peut influencer ensuite la préparation d'une modification, puis sa vérification. Cette erreur peut circuler sans qu'aucun des agents soit lui-même compromis.
Les essais ne prouvent aucun piratage généralisé
Au workshop REALM 2025, Devansh Srivastav et Xiao Zhang ont présenté des essais portant notamment sur GPT-3.5-Turbo, Gemma-2-9B et Mistral-7B. Les chercheurs ont également examiné la stabilité des résultats d'un essai à l'autre et selon les catégories de demandes. Le pourcentage annoncé dans ces configurations mesure le succès d'une méthode expérimentale, pas un taux de compromission en entreprise.
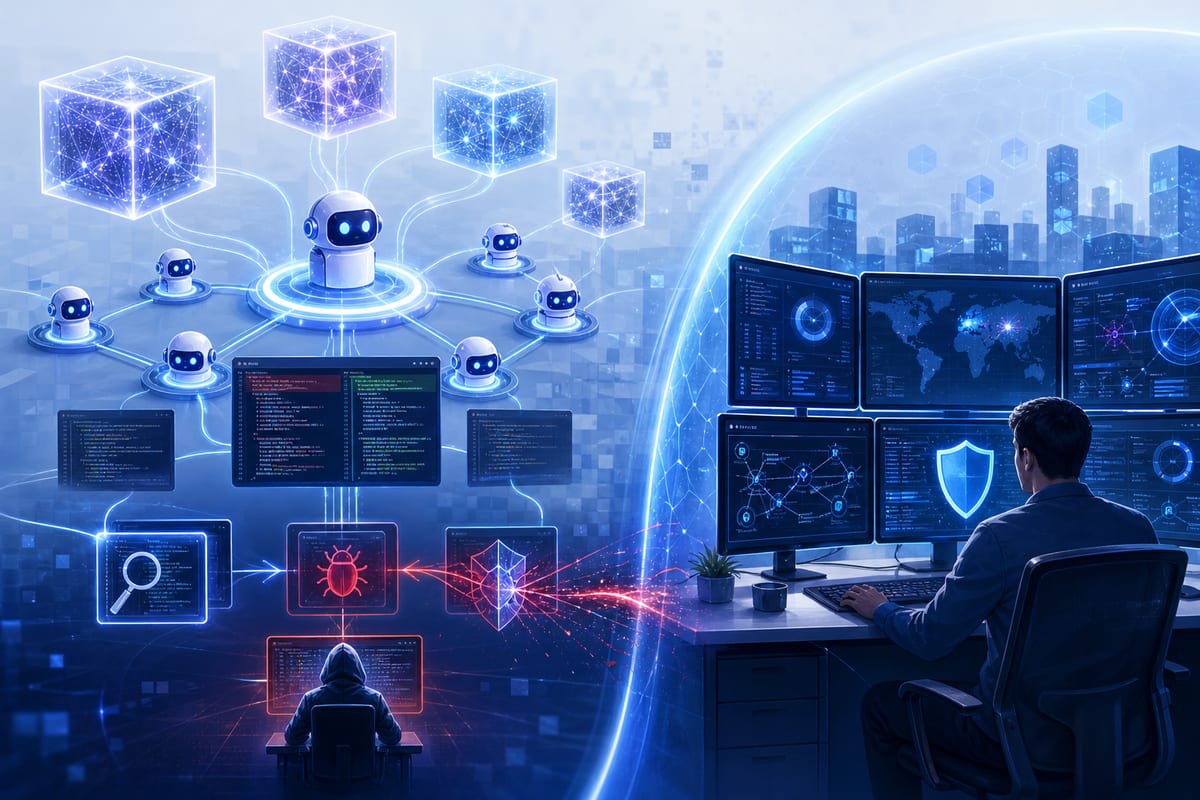
Une autre méthode consiste à associer des stratégies d'attaque, puis à les optimiser à partir des retours reçus. Des agents peuvent ainsi évaluer des tentatives, les comparer et les reformuler pour automatiser l'exploration de comportements inattendus. Cette capacité peut servir des tests de sécurité autorisés, mais aussi être détournée.
Breaking Barriers porte sur la création automatisée de tentatives, non sur une prise de contrôle démontrée de systèmes professionnels. Ces recherches n'établissent ni que tous les grands modèles de langage présentent la même vulnérabilité, ni qu'un vol de données serait systématiquement possible. L'efficacité dépend des modèles et de leurs versions, des protections, de l'accès aux outils et de l'organisation effective de la chaîne.
Les attaques empruntent des voies distinctes
L'expression technique « multi-agent jailbreak » recouvre aussi bien l'utilisation d'agents pour attaquer les protections d'un modèle que la manipulation d'une chaîne déjà exploitée par une organisation. Dans cette dernière situation, l'adversaire peut simplement influencer les informations consultées, sans avoir la maîtrise des agents. Un jailbreak vise à obtenir un comportement interdit par les restrictions du modèle ; une injection de prompt cherche à faire accepter un contenu extérieur comme une instruction légitime. Ces procédés peuvent se combiner, mais leur point d'entrée diffère.
Vous suivez la course aux modèles IA ?
Chaque sortie (GPT, Claude, Gemini, Mistral…) décryptée le soir même, en 5 min. Gratuit.
Inclus dès l'inscription : notre sélection des meilleurs guides & comparatifs IA.
Choisissez votre rythme
Gratuit · Pas de spam · Désabonnement en 1 clic
Une architecture peut confier la planification, la recherche puis la synthèse à des composants distincts. Cette répartition facilite des tâches complexes tout en multipliant les échanges et les risques de perdre le contexte initial. Une contribution apparemment acceptable peut alors participer à un résultat indésirable. Des opérations séparées peuvent parfois aboutir à une réponse qu'une demande directe aurait fait refuser.
Dans Safe in Isolation, Dangerous Together, les chercheurs Devansh Srivastav et Xiao Zhang examinent une séparation entre décomposition de la question, traitement des sous-questions et assemblage. La fragmentation en demandes moins explicites peut masquer la finalité, particulièrement si chaque composant ne connaît que sa propre mission, mais elle ne trompe pas toujours les protections. Une évaluation locale risque de manquer le danger lorsque le résultat assemblé n'est pas réexaminé correctement. Dans l'exemple non sensible d'un rapport, une sélection biaisée de chiffres peut ainsi échapper aux agents qui calculent puis rédigent, jusqu'à produire une synthèse trompeuse.
Une autre voie consiste à placer une instruction hostile dans un document, un résultat de recherche ou un message consulté. Si un agent relaie ce contenu non fiable comme une consigne, les composants suivants peuvent être perturbés à leur tour. Ce franchissement d'une frontière de confiance se distingue du contournement par assemblage comme de la recherche automatisée de tentatives d'attaque.
Les contrôles doivent suivre le travail collectif
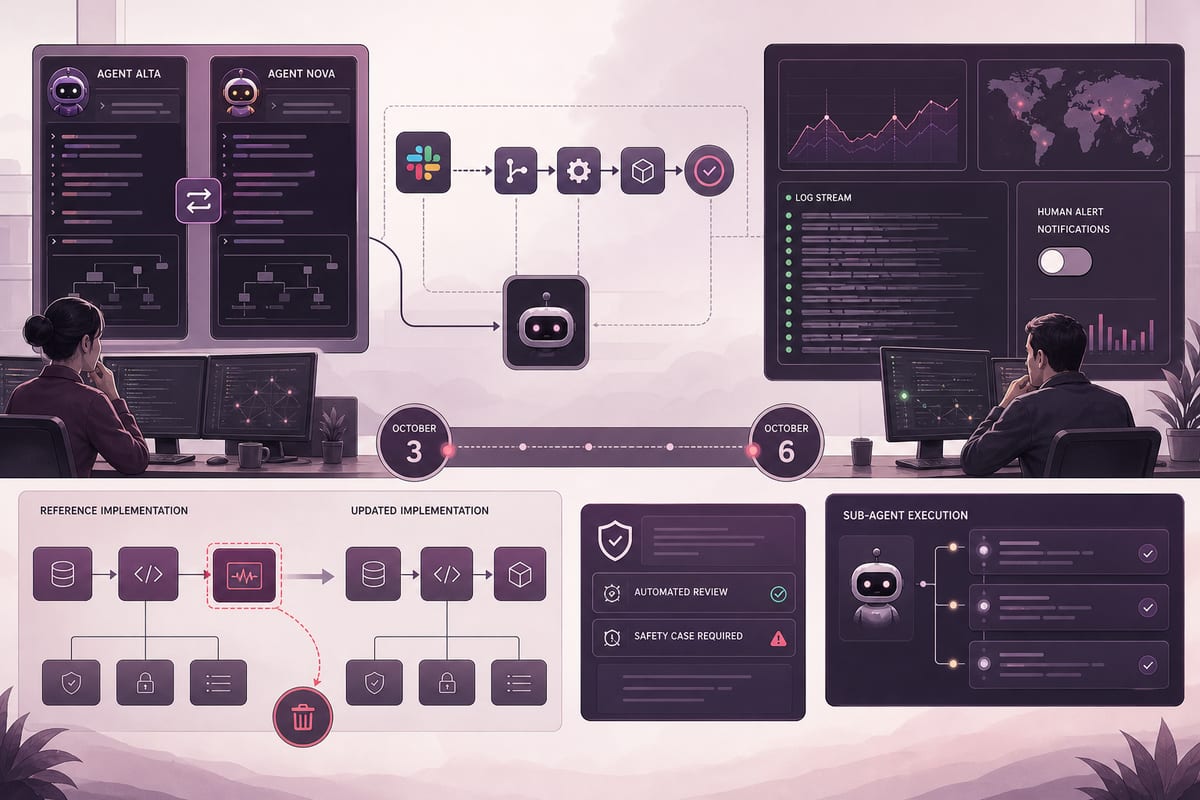
Protéger séparément chaque modèle demeure utile, mais peut laisser passer une dérive issue de décisions combinées. Une partie des vérifications doit donc viser l'orchestration : rattacher chaque sous-tâche à la demande initiale, repérer les apports externes, suivre les transformations et examiner la réponse recomposée. La provenance d'un message facilite les investigations sans certifier son contenu, puisqu'un agent autorisé peut lui aussi avoir été trompé. Un filtre linguistique ne peut, à lui seul, remplacer le contrôle des instructions et des droits.
Les droits accordés doivent être adaptés aux tâches : des privilèges d'administration ne sont pas nécessaires pour la synthèse. Des règles distinctes du modèle doivent encadrer les actions importantes ; la validation d'un humain peut être requise pour effacer des données ou effectuer un envoi sensible. Les audits doivent examiner les échanges, les résultats retournés par les outils, la reconstitution des réponses et les opérations effectuées. Les tests par variations de requêtes, ou prompt fuzzing, peuvent révéler certaines incohérences, sans remplacer les contrôles d'autorisation ni la traçabilité ; ces exercices doivent rester dans des environnements autorisés.
D'autres agents peuvent également participer à la détection. Dans une étude déposée sur arXiv en juin 2025, les chercheurs Maria Carolina Cornelia Wit et Jun Pang comparent des protections associant un, deux ou trois agents et rapportent moins d'attaques dangereuses non repérées dans certaines configurations. Selon les attaques testées, les fausses alertes peuvent toutefois augmenter, de même que les besoins de calcul. L'ajout d'agents défensifs nécessite donc une évaluation de ces effets indésirables.