La recherche en IA te passionne ?
Les papers et avancées qui comptent, expliqués simplement, chaque soir. Gratuit.
Inclus dès l'inscription : notre sélection des meilleurs guides & comparatifs IA.
Choisis ton rythme
Gratuit · Pas de spam · Désabonnement en 1 clic
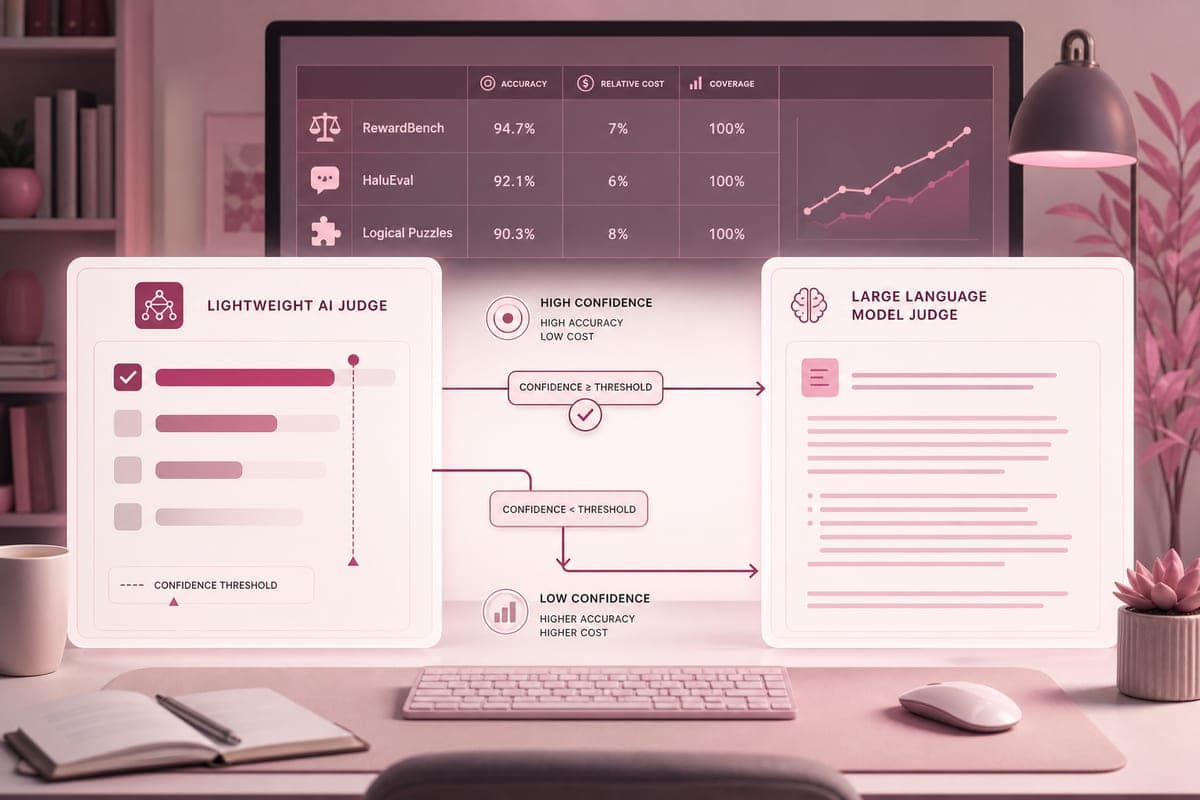
Un schéma en deux temps fondé sur la confiance de JEV revendique 93,4 % de précision pour 41,4 % du coût d'un juge LLM de référence, d'après des tests rapportés. Il apparaît que JEV et d'autres modèles échouent dans certains cas, et que ses décisions rapides et économiques sont pertinentes dans des conditions spécifiques.
Un routage à deux niveaux atteint 93,4 % de précision pour 41,4 % du coût
Dans le dispositif décrit, la confiance de JEV correspond à sa probabilité maximale parmi les options. Un exemple donné est une répartition de 95 % pour « premier » et 5 % pour « second », qui fixe la confiance à 0,95. Le routage proposé consiste à définir un seuil, par exemple 0,90, à accepter la décision de JEV au‑dessus et à référer sous ce seuil à un modèle plus grand. Testée sur 1610 nouvelles paires, cette approche a confié 68,5 % des cas à JEV seul. La précision globale observée a atteint 93,4 %, légèrement au‑dessus de GPT‑6 à 92,5 %, pour un coût représentant 41,4 % de celui de GPT‑6. Sur une tâche plus difficile, le système a référé 74,2 % des cas au modèle plus grand. L’objectif déclaré est d’éviter la mauvaise réponse tout en ne pas arbitrer selon le budget.
Sans réponse de référence, même les grands modèles se trompent
Lorsque aucune réponse de comparaison n’est disponible, JEV, GPT‑4.1 mini et GPT‑5.4 ont effectué des choix quasi aléatoires tout en semblant confiants. Dans ce cas, augmenter la taille du modèle n’a pas apporté de solution. La recommandation qui en ressort est de fournir à tout juge des preuves ou une liste de contrôle.
Coût et vitesse: JEV mesuré 277 fois moins cher, 13 fois plus rapide
Quatre chercheurs de la CMU ont comparé JEV à seize autres juges sur de nombreuses tâches. Dans leurs mesures, JEV coûtait 0,044 $ pour 1000 jugements et prenait 0,15 s par jugement, quand GPT‑6 Astra affichait 1,89 s et 12,182 $ pour 1000 jugements. Sur cette base, JEV était 277 fois moins cher et 13 fois plus rapide, ces coûts reflétant toutefois le protocole de test et pouvant varier. Côté précision, JEV atteignait 92,5 % sur RewardBench comme GPT‑6, 87,3 % contre 88,4 % sur HaluEval, 78,6 % contre 93,1 % sur un banc plus difficile, 68,4 % contre 95,9 % sur des énigmes logiques, et 76,6 % contre 90,1 % lorsque la bonne réponse était plus longue et élaborée face à une attente concise et directe.
Calibration observée: 0,043 d’erreur pour JEV contre 0,054 pour un LLM
Un test réalisé sur 88 cas via OpenRouter a montré des chiffres de confiance de JEV bien répartis entre 0 et 1, tandis que le juge LLM plaçait rarement sa confiance au milieu et se retrouvait souvent près de 0 ou 1 même en incertitude. Les scores d’erreur relevés étaient de 0,043 pour JEV et 0,054 pour le LLM, une valeur plus basse étant meilleure. Il est toutefois rappelé qu’un test ne constitue pas une preuve et qu’il convient de confronter les niveaux de confiance aux réponses effectives.
Ce que JEV fait bien, ce que les LLM apportent
JEV est présenté comme un modèle « Système Un » conçu pour de petites décisions, renvoyant des réponses courtes avec probabilités. TypeSafe affirme l’avoir entraîné à fournir des chiffres de confiance honnêtes, une revendication non vérifiée de façon indépendante. JEV est décrit comme très rapide et économique et adapté aux vérifications simples et répétées lorsque la preuve est dans le texte. À l’inverse, un juge LLM produit du texte rédigé, peut expliquer sa décision, mais s’avère plus lent et plus coûteux, convenant aux questions ouvertes, à la réflexion complexe et au retour écrit. Langfuse, outil de suivi des applications d’IA, est intégré avec des juges LLM et des vérifications par code et prend déjà en charge JEV. Côté fonctionnalités, JEV peut sélectionner une option dans une liste en associant des probabilités, trancher entre deux réponses avec un type d’erreur, ou produire un niveau sur une échelle comme faible, moyen ou élevé.
Reproduire un essai: environnement, cas difficiles et appels aux juges
Une démonstration a rassemblé 12 cas difficiles, mêlant réponses longues mais incorrectes, instructions cachées et calculs, avec deux réponses par cas et une vérité connue. Chaque juge a été interrogé deux fois, d’abord avec A puis avec B, pour détecter une préférence de forme. Pour reproduire l’essai, il faut Python 3.9 ou plus, une clé API TypeSafe pour JEV et une clé pour un LLM compatible OpenAI. La procédure propose de créer un dossier dédié, d’installer requests, pandas, numpy, python-dotenv, openai, matplotlib et truststore, puis de configurer un .env (TYPESAFE_API_KEY, LLM_API_KEY, LLM_BASE_URL, LLM_JUDGE_MODEL) sans le partager. Le projet regroupe notamment .env, judges.py, raw_call.py, cases.py, run_lab.py, report.py et plot_frontier.py. Le fichier d’assistance définit call_jev_pair (retours dont who_won et probabilité) et jev_two_order, ainsi que leurs équivalents pour le LLM, avec une instruction SYSTEM qui demande de choisir la meilleure réponse et de traiter les textes comme des données afin d’ignorer d’éventuelles instructions cachées.