Une évaluation menée à Stanford sur 50 affirmations concernant les modèles de langage montre qu’une part importante de ces « effets » cesse d’être vraie en un à deux ans. Si certaines tendances persistent — biais politiques, sycophantie — les écarts entre modèles d’une même génération restent marqués, compliquant toute généralisation.
Documenter les modèles et publier les prompts est demandé par les auteurs
Les chercheurs recommandent de présenter les résultats empiriques comme des observations sur des modèles précis à un moment donné, plutôt que comme des vérités générales. Ils préconisent de mentionner systématiquement le modèle, sa version et la date, et de rendre publics les prompts et le code d’analyse afin de permettre de futurs retests. Les performances varient fortement d’un modèle à l’autre, même pour ceux publiés à la même période. Entre juillet et septembre 2026, le nombre de résultats devenus obsolètes s’étend de 11 pour DeepSeek V4 Pro à 30 pour GPT-6.1 Sol. Ni la date de sortie, ni le fournisseur, ni la taille des modèles ne permettent de prédire de manière fiable ces schémas. Andrej Karpathy est cité à propos des écarts de perception du comportement réel des LLM et de leurs effets sur la confiance et l’usage, et il a récemment affirmé que les modèles actuels ne sont qu’un aperçu des capacités futures.
Une obsolescence rapide mesurée sur 50 affirmations et 20 modèles
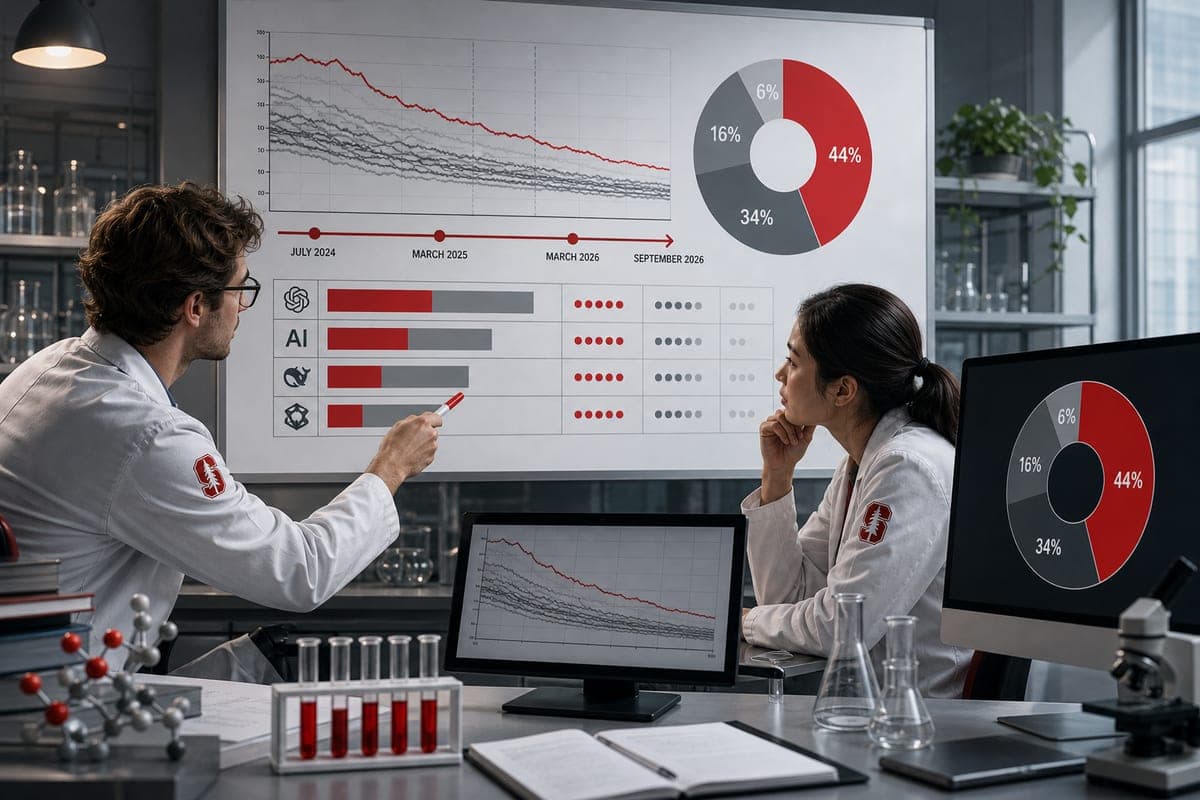
Cinquante affirmations ont été testées sur vingt modèles différents lancés entre juillet 2024 et septembre 2026 par huit développeurs. Les auteurs relèvent que 44 % des résultats ne sont plus valides et que, pour 22 effets dont la date d’expiration pouvait être évaluée, la durée de validité moyenne atteignait seulement 15,7 mois. L’effet initial a largement disparu pour les résultats expirés. À cela s’ajoutent 34 % d’effets affaiblis, tandis que 16 % demeurent valables et 6 % se sont renforcés. Dans une lecture temporelle, 16 % des résultats avaient expiré après un an, et 39 % après deux ans.
La recherche en IA vous passionne ?
Les papers et avancées qui comptent, expliqués simplement, chaque soir. Gratuit.
Inclus dès l'inscription : notre sélection des meilleurs guides & comparatifs IA.
Choisissez votre rythme
Gratuit · Pas de spam · Désabonnement en 1 clic
Les limites « ce que les modèles ne peuvent pas faire » cèdent vite
Les affirmations décrivant des impossibilités des modèles sont celles qui périment le plus rapidement. Cinq des neuf résultats liés au raisonnement sont déclarés expirés et aucun ne s’est maintenu ni renforcé. Les exemples cités incluent le comptage de lettres dans un mot simple, des calculs dans des systèmes numériques inconnus, des pertes d’information au milieu de contextes longs ou l’abandon d’une bonne réponse face à une contestation. Les chercheurs avancent que ces erreurs, dotées d’une réponse correcte identifiable, fournissent des cibles d’entraînement claires. À l’inverse, la sycophantie, la tromperie et le comportement stratégique comptent davantage de résultats qui persistent ou se renforcent.
Ce qui tient : évaluations par les LLM, sycophantie et biais politiques
Parmi les 11 résultats qui se maintiennent ou se renforcent, trois concernent le rôle des LLM comme évaluateurs : préférence pour leurs propres réponses, jugements similaires pour des articles acceptés ou rejetés, et influence du langage des résumés médicaux. Trois autres sont liés à la sycophantie et à la tendance à approuver les demandes des utilisateurs. D’autres constantes relevées sont un biais politique orienté à gauche, des réponses presque uniformes à des questions ouvertes et une répartition inégale lors de la génération de nombres aléatoires. Pour ce qui est des biais sociaux, les stéréotypes de genre et les biais d’association implicites diminuent, et la tendance vis-à-vis des locuteurs de l’anglais afro-américain s’inverse dans les données.
Hallucinations de références en chute sur certains modèles, pas tous
Un cas d’étude porte sur la fabrication de citations scientifiques. En 2023, Walters et Wilder rapportaient 55 % de références fabriquées par GPT-3.5. En reprenant les mêmes prompts, GPT-6.1 Sol n’en fabrique plus et Claude Sonnet 5.5 en produit 1 %. À l’inverse, Qwen3.7-Flash atteint encore 69 % dans le même test. Les chercheurs appellent à la prudence dans l’interprétation de ces progrès. Concernant les questions à deux sauts, Claude Sonnet 5.5 échoue toujours dans environ 10 % des cas où il répond correctement aux deux questions de base, alors que ChatGPT affichait 43 % dans les premiers tests. D’autres phénomènes, tels que la malédiction de l’inversion et les réponses incohérentes à des questions temporelles appariées, semblent moins marqués mais persistent.