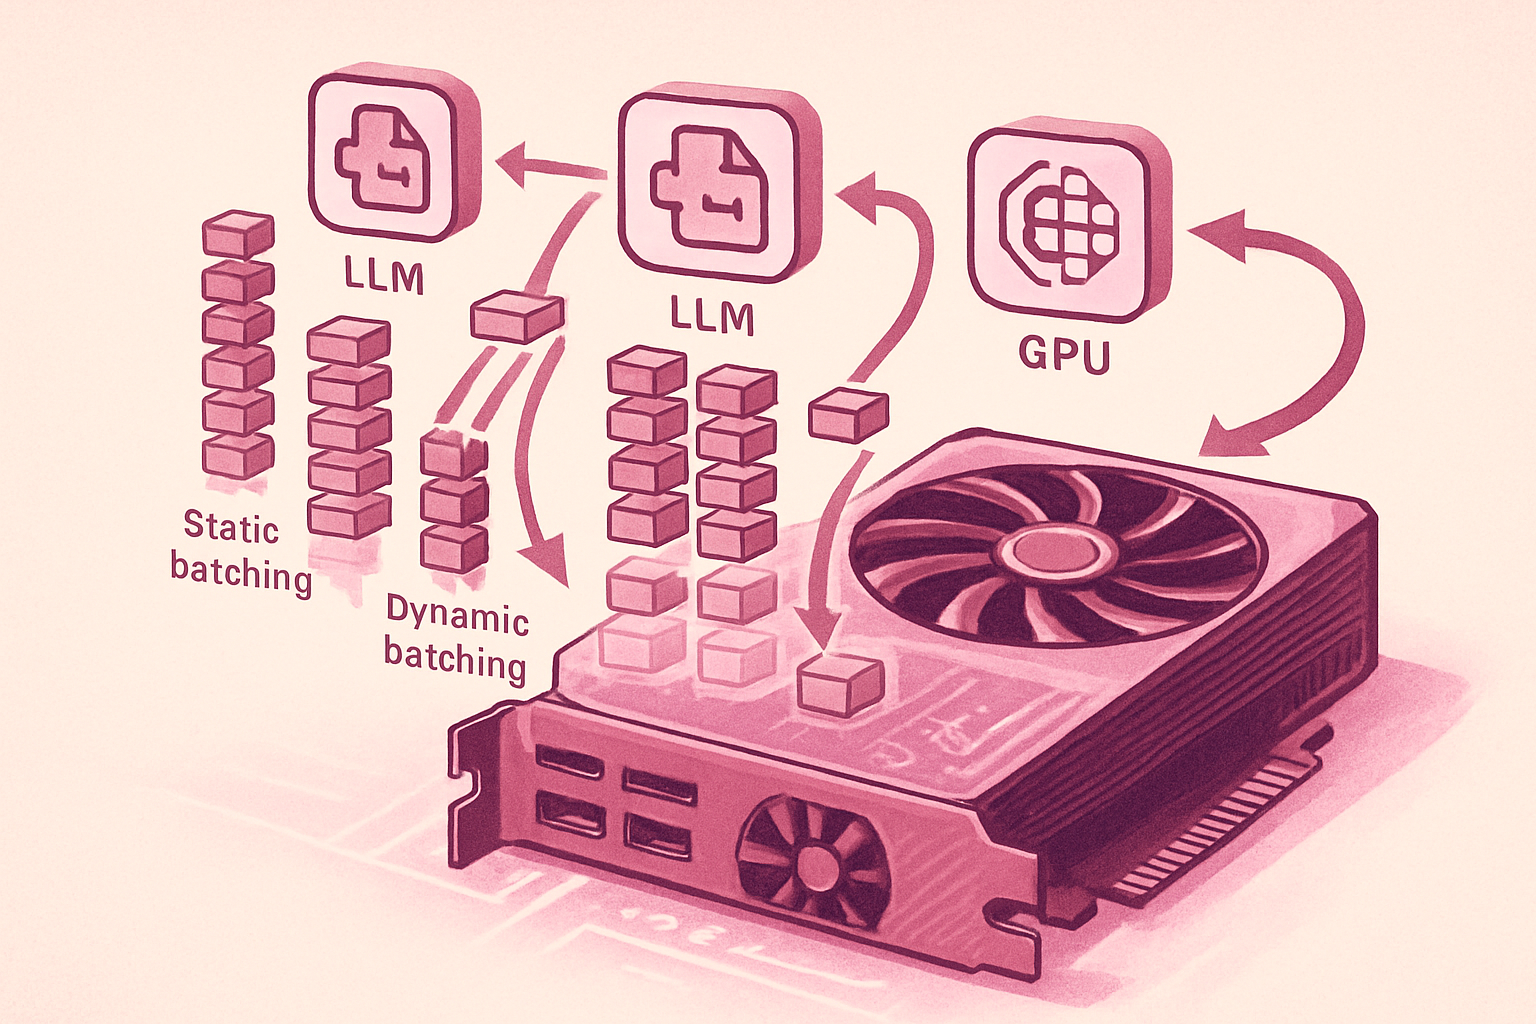
Le goulot d’étranglement des grands modèles n’est pas le calcul mais la mémoire lors du décodage. Trois façons de regrouper les requêtes — lot fixe, lot façonné en file et réapprovisionnement à chaque étape — conduisent à des comportements très différents côté serveur et GPU.
Quand un lot attend la plus longue requête, l’utilisation chute à 33 %
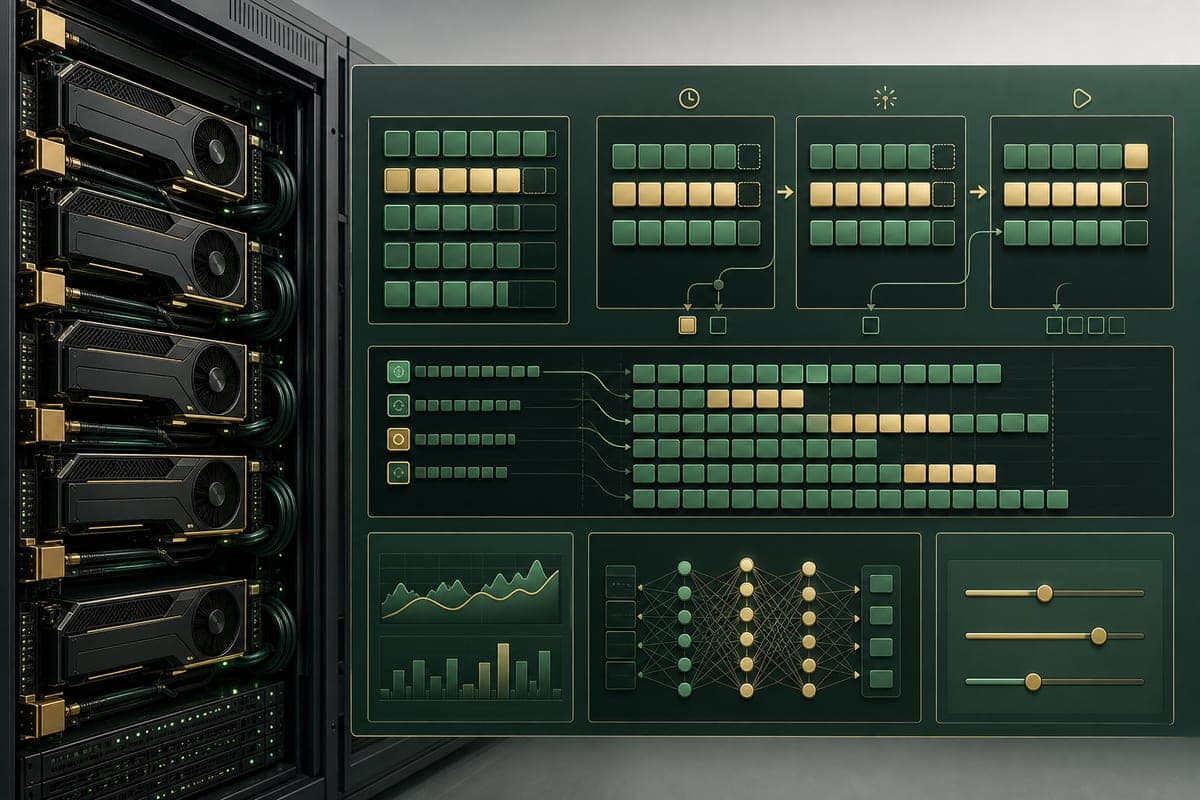
Dans un lot statique de quatre requêtes produisant 20, 50, 100 et 500 tokens, l’exécution s’étire sur 500 étapes car elle attend la plus longue. La requête de 20 tokens finit à l’étape 20, puis son emplacement reste inactif ou remplit pendant 480 étapes supplémentaires. Au total, le travail utile ne représente que 670 étapes de token sur 2 000 possibles, soit environ 33 % d’utilisation. Une requête arrivée à l’étape 1 doit, elle, patienter 499 étapes avant de commencer. Cette situation correspond au head-of-line blocking, où une requête longue retarde celles qui suivent.
Le vrai plafond est la mémoire: décodage, poids et KV cache
Pendant la génération, le GPU est limité par la vitesse de lecture mémoire plus que par le calcul. L’inférence alterne prefill et decode : le prefill traite tous les tokens du prompt en parallèle et occupe bien les unités de calcul, tandis que le décodage relit les poids à chaque token, source principale de gaspillage. Pour un modèle 7B en FP16 sur un H100, les poids occupent environ 14 Go ; avec une bande passante d’environ 3,35 To/s, les lire prend près de 4 ms, ce qui borne une requête unique à ~240 tokens par seconde. Chaque token demande environ 14 GFLOPs, soit ~3,5 TFLOPS en 4 ms, alors que le H100 propose près de 1 000 TFLOPS BF16 denses. Avec un lot de 1, le calcul reste inactif plus de 99 % du temps. En pratique, chaque séquence conserve un cache KV qui grossit à chaque token, et la taille de lot est donc limitée par la mémoire. Exécuter 32 séquences sur les mêmes étapes charge une fois les poids et produit 32 tokens au lieu d’un, et le batching augmente le débit tout en baissant le coût par token sans ajouter de GPU.
La recherche en IA te passionne ?
Les papers et avancées qui comptent, expliqués simplement, chaque soir. Gratuit.
Inclus dès l'inscription : notre sélection des meilleurs guides & comparatifs IA.
Choisis ton rythme
Gratuit · Pas de spam · Désabonnement en 1 clic
Former le lot à la volée: la file d’attente et l’exemple Triton
Le batching dynamique modifie la manière de former un lot mais pas son exécution. Les requêtes s’empilent en file ; un lot démarre quand la taille maximale est atteinte ou que la requête la plus ancienne dépasse un délai d’attente. Ainsi, en trafic léger, aucune requête n’attend indéfiniment que le lot se remplisse, et en trafic soutenu le GPU reste occupé. NVIDIA Triton Inference Server en fournit un exemple, activé dans le fichier config.pbtxt du modèle. Une configuration illustre max_batch_size à 8, des tailles préférées de 4 et 8, et un délai maximal en file de 100 microsecondes ; elle instruit Triton de viser des lots de 4 ou 8 et de ne jamais retenir une requête au-delà de 100 microsecondes. À l’inverse, le batching statique réunit un ensemble fixe de requêtes, en refuse de nouvelles tant que le lot n’est pas terminé, et correspond au comportement de model.generate(), ce qui devient problématique lorsque la longueur des sorties varie fortement.
Ordonnancer en continu pour maintenir le GPU presque plein
Le batching continu prend des décisions à chaque étape de décodage. Dès qu’une séquence émet son token de fin de séquence, elle est renvoyée et son emplacement est libéré. Une requête en attente occupe ce créneau dès l’étape suivante, de sorte que le lot ne se vide jamais. Cette approche, aussi appelée scheduling au niveau d’itération, a été introduite par Orca et est connue sous le nom d’in-flight batching dans NVIDIA TensorRT-LLM. Concrètement, une requête de 20 tokens est renvoyée à l’étape 20 et une nouvelle commence à l’étape 21 dans le même slot, ce qui garde le GPU presque plein et démarre de nouvelles requêtes quasi immédiatement.