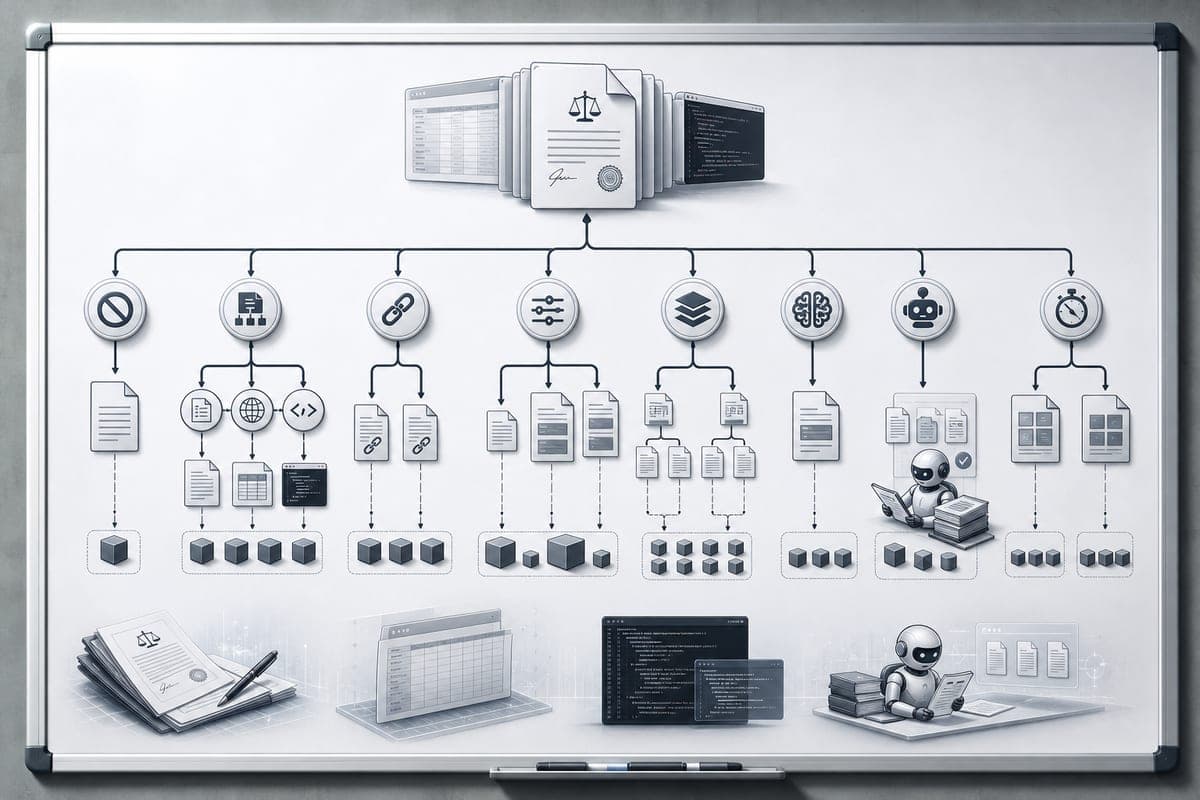
Choisir comment découper ses sources conditionne la qualité d’une recherche de passages pour les LLM. Un arbre en six étapes propose d’éviter le découpage quand il est superflu, de s’appuyer sur la structure quand elle est fiable, et de réserver les méthodes coûteuses aux cas qui le justifient. Les stratégies s’alignent sur la forme du corpus et les priorités de coût et de latence.
Arbitrer entre qualité, coût et latence dans le découpage
L’arbre de décision pose explicitement la question du compromis entre qualité de récupération, coût et latence. Lorsque la priorité est donnée à la qualité et que le budget permet un appel de modèle par document, il est préconisé d’opter pour un découpage fondé sur un LLM. Si la qualité demeure importante mais que le coût des appels de modèle par document est trop élevé et que les changements de sujet ne peuvent être anticipés, il convient alors d’utiliser un découpage sémantique reposant sur la distance d’embedding de phrases. Lorsque la rapidité d’exécution et la maîtrise des coûts sont les critères principaux, l’arbre conduit à examiner la question suivante puis, en dernier recours, à recourir à un découpage à taille fixe pour des phases de prototypage rapide. Le tableau d’association relie chaque stratégie à son contexte d’usage et à son coût, et réserve le LLM-based aux documents complexes et à enjeux élevés, tandis que le sémantique convient à un budget modéré. Le recours au fixe se justifie lorsque la rapidité compte davantage que la qualité des morceaux. L’objectif général est d’équilibrer qualité, coût computationnel et complexité d’implémentation.
Ne pas découper quand le document tient et reste monothématique
La première étape consiste à évaluer la nécessité de découper le document. Les contenus brefs et indépendants, tels que les entrées de FAQ, les fiches produits ou les extraits de configuration isolés, peuvent généralement être traités dans un unique appel d’embedding et abordent un seul sujet. Dans ce contexte, il est préférable d’encoder le document dans son intégralité sans procéder à un découpage. Si le texte est trop long ou aborde plusieurs sujets, il faut poursuivre l’évaluation par la suite de l’arbre.
Exploiter la structure quand elle est fiable
Lorsque le document dispose d’une structure interne claire, celle-ci sert de guide. Les en-têtes Markdown, les éléments HTML, les sections et tables PDF, ou encore les fonctions et classes de code constituent des limites pertinentes. Si cette structure est fiable et reflète des unités logiques, le découpage basé sur le document est indiqué. À l’inverse, si la structure est incohérente, incomplète ou peu utile, il faut considérer d’autres approches à l’étape suivante.
La recherche en IA vous passionne ?
Les papers et avancées qui comptent, expliqués simplement, chaque soir. Gratuit.
Inclus dès l'inscription : notre sélection des meilleurs guides & comparatifs IA.
Choisissez votre rythme
Gratuit · Pas de spam · Désabonnement en 1 clic
Préserver les dépendances à l’échelle du document
Certains contenus exigent que chaque morceau conserve le contexte global. C’est le cas d’un contrat qui définit un terme dans une section et le réemploie plus loin, ou d’une spécification technique dont la terminologie dépend d’un paragraphe précédent. Dans ces cas, il est préférable d’opter pour un découpage tardif. Cette méthode consiste à encoder d’abord l’intégralité du document à l’aide d’un modèle acceptant de longs contextes, puis à générer les embeddings pour chaque fragment séparément. De cette manière, chaque fragment conserve la mémoire du contexte global, ce qui permet de traiter les situations de références croisées et de dépendances sur de longues distances.
Adapter taille et niveaux de granularité aux usages
Deux besoins distincts orientent cette étape. Si la densité d’information varie au sein d’un même document, le découpage adaptatif ajuste la taille des morceaux et le chevauchement selon le contenu, avec de petits morceaux pour les passages denses et de plus grands pour les sections plus légères. Si le même corpus doit permettre de répondre à des questions larges et à des interrogations très précises, le découpage hiérarchique s’impose avec des morceaux parents grossiers et des enfants fins. Ces approches ciblent respectivement les corpus à densité inégale et ceux nécessitant des réponses à plusieurs granularités.
Choisir selon l’hétérogénéité ou l’uniformité du corpus
La nature de la collection oriente le choix final. Pour une collection hétérogène, un découpage agentique délègue à un agent l’inspection de chaque document et la sélection de la stratégie adaptée. À l’inverse, un corpus raisonnablement uniforme se prête bien au découpage récursif, qui segmente d’abord aux limites de paragraphes, puis de phrases, puis de mots, jusqu’à atteindre la taille cible, tout en préservant une structure naturelle sans analyse spécifique par document.
Hypothèses, compatibilités et effets d’un mauvais choix
Chaque stratégie s’appuie sur une hypothèse précise : taille fixe avec compensation par chevauchement, récursif fondé sur les limites de paragraphe et de phrase, basé sur le document aligné à la structure sémantique, sémantique via distances d’embedding, tardif pour des morceaux dépendants du tout, adaptatif pour une densité variable, LLM-based pour déceler des ruptures que d’autres signaux manquent, et agentique quand aucune règle unique ne suffit. Utilisées dans le bon contexte, ces méthodes justifient leur complexité ; mal alignées, elles ajoutent de la surcharge sans gain de récupération. Un découpage sémantique est ainsi superflu sur une courte FAQ, tandis qu’un découpage à taille fixe peut scinder des clauses liées dans un contrat. Ces incompatibilités engendrent des problèmes de récupération issus du prétraitement, et non de la génération. Le choix doit donc tenir compte de la structure, de la complexité et des besoins de récupération des données.