Des chercheurs de Microsoft rapportent que des agents IA se figent dans des « bassins d’idées » quand la conversation s’allonge. En scindant le processus en branches et en repartant avec un contexte vierge, Fork-and-Flush améliore le score moyen et la constance sans plus de calcul. Les écarts entre exécutions restent marqués à la frontière des capacités des modèles, ce qui rend les réinitialisations pertinentes même avec des systèmes plus puissants.
Avec un budget identique, un score moyen porté à 0,78 et une variance réduite
Dans des essais comparables, Fork-and-Flush atteint un score moyen normalisé de 0,78. Les exécutions uniques plafonnent à 0,47 et le meilleur des 4 monte à 0,54. Les gains relatifs rapportés sont de 66,0 pour cent par rapport aux exécutions uniques et de 44,4 pour cent par rapport au meilleur des 4. La méthode obtient en outre le meilleur score moyen sur 12 des 13 tâches évaluées. La dispersion des performances baisse, avec un écart type normalisé de 0,16 contre 0,26 pour des exécutions uniques. Effacer simplement le contexte sans créer de branches améliore déjà les résultats de 22 pour cent. Les exécutions individuelles couvrent des durées de plusieurs heures à plus de 100 heures.
Fork-and-Flush réinitialise le dialogue mais garde le travail produit
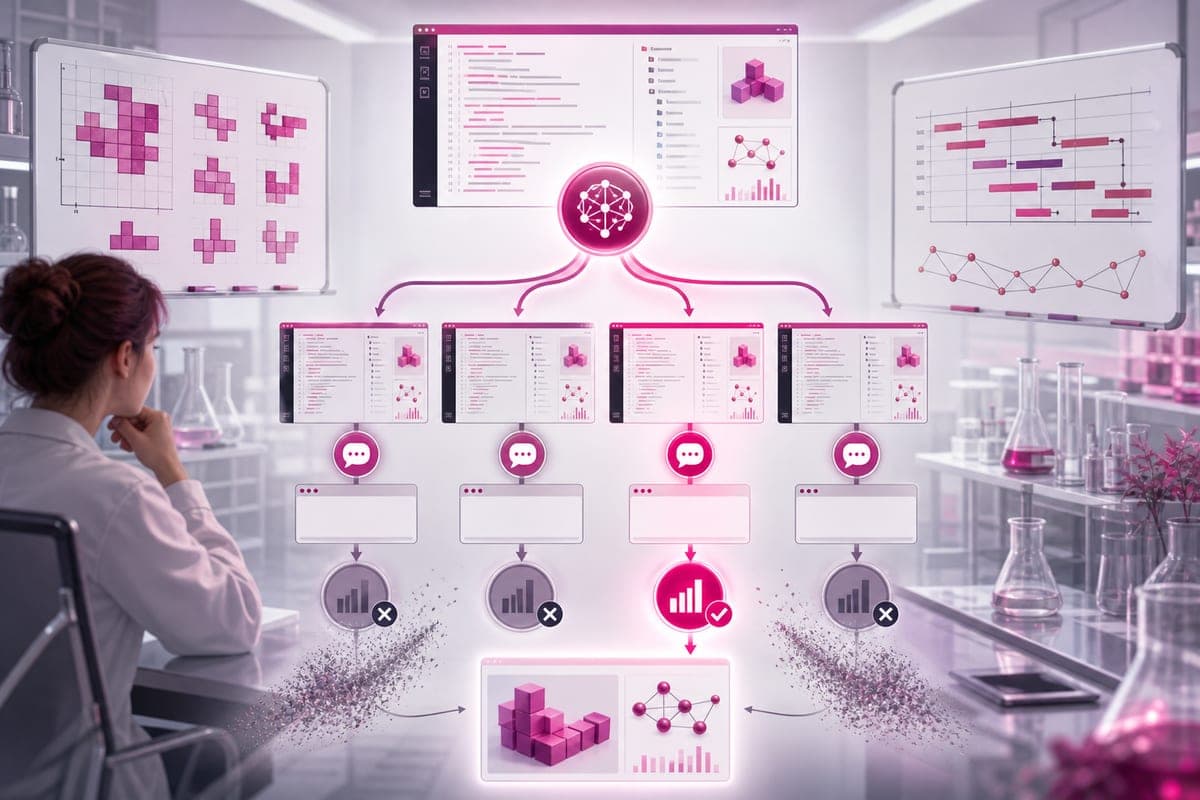
La méthode combine deux phases. D’abord, le forking divise l’agent en K branches parallèles, chacune héritant de l’espace de travail et des fichiers existants. Ensuite, le flushing efface pour chaque branche l’intégralité du contexte de conversation tout en conservant l’espace de travail, ce qui permet de reprendre une nouvelle conversation en s’appuyant sur le code et les résultats déjà générés. Le processus lance des branches avec des contextes frais, ne garde que la meilleure et écarte les autres. L’historique de conversation disparaît, mais les artefacts de travail restent. Un contexte renouvelé rétablit la diversité de la recherche, alors qu’une branche qui conserve le contexte parent tend à revenir dans le même bassin d’idées. Des branches avec un contexte frais peuvent se déplacer vers d’autres bassins et obtenir de meilleurs scores.
Tu veux les meilleurs outils IA avant les autres ?
On teste et on décrypte les nouveaux outils IA chaque soir, en 5 min. Gratuit.
Inclus dès l'inscription : notre sélection des meilleurs guides & comparatifs IA.
Choisis ton rythme
Gratuit · Pas de spam · Désabonnement en 1 clic
Pourquoi les agents stagnent malgré plus de calcul
Les agents d’autorecherche examinés fonctionnent en proposant, évaluant et perfectionnant des solutions de manière itérative, mais ils peuvent rencontrer une stagnation même si les ressources de calcul sont accrues. Huit lancements indépendants d’un agent identique appliqué à une même tâche ont généré des scores finaux compris entre 68,3 et 100,0, des variations qui persistent malgré un apport supplémentaire de calcul. La représentation bidimensionnelle des solutions met en évidence que chaque lancement reste limité à une zone restreinte, correspondant à un bassin d’idées, où il poursuit l’exploration des mêmes directions. Les agents investissent alors l’essentiel du budget restant dans une région peu productive au lieu d’explorer d’autres approches. Ce comportement se maintient même quand ils compriment périodiquement leur historique de conversation. Une exécution unique illustre cette tendance en demeurant dans le même bassin.
Des tests sur 13 tâches et des modèles Qwen3.5 montrent un pic de variance à la limite des capacités
Les évaluations couvrent 13 tâches de longue durée, dont le packing de polyominos, la planification de job-shop, la cryptanalyse, la compression d’un classificateur CIFAR et l’optimisation d’un noyau VLIW, avec des agents exécutés via le CLI de GitHub Copilot en s’appuyant sur GPT-5.6-terra et GPT-5.5. Pour juger l’effet de la taille des modèles, des problèmes MAX-3-SAT ont été utilisés avec Qwen3.5-4B, 9B et 27B. L’écart entre les différentes exécutions prend la forme d’une courbe en U inversé, atteignant son maximum pour des tâches proches de la limite des capacités, soit à mi-chemin entre une réponse aléatoire et celle d’un solveur de référence. Les modèles parviennent presque systématiquement à résoudre les tâches les plus simples, échouent sur les plus ardues, et affichent des performances variables à la frontière, indépendamment de la taille du modèle utilisé. Les problèmes ouverts en recherche se trouvent précisément à la frontière entre ce que les modèles savent faire et ce qu'ils ne savent pas faire, et la variabilité exploitable devrait rester présente à mesure que les modèles progresseront, cette frontière se déplaçant vers des cas plus complexes. Ces observations suggèrent que des réinitialisations régulières du contexte demeureraient utiles même pour des agents de pointe.