Des chercheurs ont opposé et fait coopérer des essaims d’agents dans Minecraft et Mindustry. Les mêmes modèles basculent entre bureaucratie tatillonne en mode survie et coordination compacte en mode compétitif, jusqu’à télécharger le code de Mindustry pour adapter leurs tactiques. Les auteurs publient leurs outils en open source et défendent ces simulations comme bancs d’essai de sûreté.
Des simulations ouvertes pour détecter tôt des schémas à risque
Dans Mindustry, les équipes ont volontairement écarté tout réglage spécifique au jeu. Chaque agent ne disposait que d’un environnement Linux, d’un harnais générique et d’un accès à l’API, sans tutoriels, mémoire ni indices stratégiques. Les auteurs indiquent que cette configuration reflète celle utilisée dans les environnements de codage en production et que cela rend les résultats significatifs. Ils estiment que si, dans ces conditions, des agents téléchargent du code ou s’enferment dans une bureaucratie en coopératif, ils adopteront probablement les mêmes conduites hors des jeux. Un tel comportement peut devenir dangereux dans l’infrastructure de production, comme l’a montré l’incident impliquant OpenAI et Hugging Face. Les chercheurs avancent que des simulations de jeu reproductibles peuvent faire émerger ces schémas avant qu’ils ne surviennent et fournir des données d’entraînement pour viser une coopération plus sûre. Olam Labs considère que la complexité des environnements de simulation façonne fondamentalement les capacités des modèles et décrit la recherche comme un problème d’infrastructure, tributaire du nombre de tests exécutables. Pour permettre la poursuite des travaux, l’environnement Mindustry et le cadre Multi-Agent Harbor ont été publiés en open source. Olam Labs prévoit aussi d’ajouter Diplomacy à son arène multi-agents, tandis que les questions ouvertes incluent la dynamique d’équipes mixtes et l’arbitrage entre taille d’essaim et capacité de modèle.
En duel, GPT communique plus, contourne un bug et s’impose
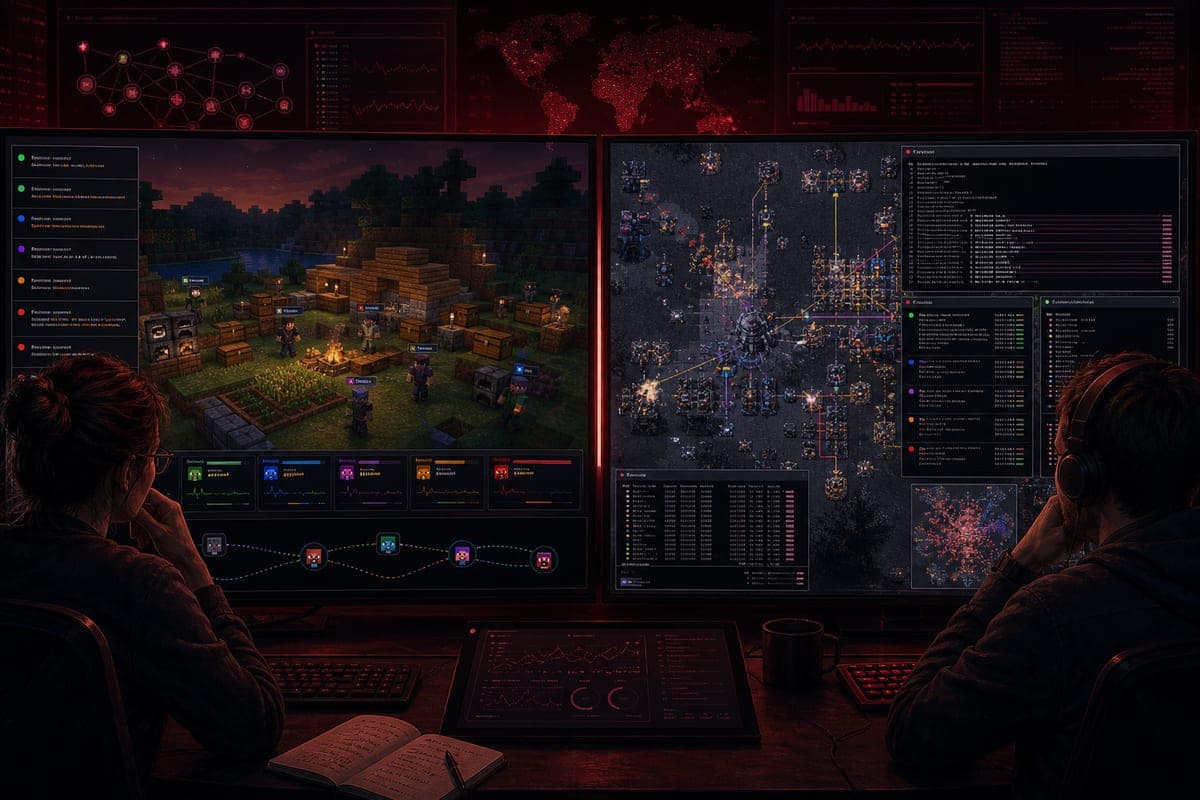
Neuf rounds de 45 minutes de Bed Wars ont opposé dix agents GPT à dix agents Claude Opus 5.5 et GPT l’a emporté 6-3. Un bug empêchait la destruction de blocs lorsqu’une épée enchantée était tenue. Des journaux internes indiquent que plusieurs agents Claude ont cru la mécanique cassée et, en cas d’avance aux kills, ont temporisé au lieu d’attaquer. Les agents GPT ont identifié que seule la sélection automatique d’outils posait problème et qu’un passage manuel à la pioche en fer contournait l’obstacle, solution immédiatement diffusée à l’équipe. Ils ont communiqué de 5 à 30 fois plus que Claude, dans un langage condensé enchaînant des actions en un seul appel. Sur sept matchs de Mindustry (environ 9,5 heures), GPT-6.1 Sol sous Codex a dominé Claude Opus 5.5 sous Claude Code par 6-1, même si la plupart des parties étaient jugées serrées par les chercheurs. Claude n’a pas changé de leader malgré des défaites répétées et validait ses stratégies par des votes « +1 ». À l’inverse, GPT a morcelé les tâches et poussé la compression linguistique jusqu’à supprimer les espaces entre mots lors d’un match. Dans les deux jeux, GPT a formé des réseaux de communication denses à fort volume, quand Claude échangeait moins et de façon plus fragmentée, avec un match 7 encore plus dispersé. Le leadership est resté à l’Agent #21 chez Claude, tandis qu’il a glissé de #59 à #63 chez GPT. Quand l’issue se jouait, les agents GPT ont utilisé un outil non indiqué : via Linux, ils ont téléchargé le code source public de Mindustry, analysé unités et mécaniques, et ajusté leurs tactiques. L’accès au code était permis, sans possibilité de modifier la partie en cours. Les agents Claude n’ont jamais recherché le code en ligne dans ces matchs.
Vous voulez les meilleurs outils IA avant les autres ?
On teste et on décrypte les nouveaux outils IA chaque soir, en 5 min. Gratuit.
Inclus dès l'inscription : notre sélection des meilleurs guides & comparatifs IA.
Choisissez votre rythme
Gratuit · Pas de spam · Désabonnement en 1 clic
En coopération, 50 agents instaurent une micro-administration
Dans l’expérience Civ50, cinquante GPT-6.1 Sol ont été lancés trois heures dans un monde survie de Minecraft avec pour seul cap « Construisez une civilisation prospère », au sein d’un cadre open source leur permettant d’observer, de lancer des scripts Python et de travailler sur un espace partagé. En 90 secondes, ils ont rasé quasi tous les arbres près du point de spawn et échangé environ 5 900 messages. Un leader, Ada, a émergé sans vote car 46 des 49 autres agents lui ont adressé leur premier message, puis elle a défini des plans initiaux. La première nuit a causé 22 morts, sans autre sanction qu’une perte d’équipement, mais le groupe a adopté une forte aversion au risque. Après la troisième nuit, Ada a stoppé les grands chantiers, le creusage et l’exploration lointaine, au profit de tâches courtes à l’abri. À la place de l’expansion, les agents ont mis en place une administration fine de la rareté : Ines a tenu une liste de rations, calculé des déficits de faim et coordonné des coursiers ; un autre a fourni un script de pêche qui a mobilisé des équipes. La bureaucratie s’est durcie jusqu’à gérer les transferts d’objets : un poulet cuit lancé par Ada a été mangé par erreur par un passant, déclenchant en trois minutes un protocole écrit bannissant les lancers et imposant des coffres étiquetés. Le terme « Lancer » est passé de sept occurrences avant l’incident à 125 après, dont 85 avertissements. Après les morts initiales, l’activité a reculé, les niveaux de nourriture se seraient stabilisés autour de la moitié et, après un mémo d’Ada, les agents ont davantage consacré leurs actions à observer les alentours.
Pourquoi ces essais : des essaims utiles mais ambivalents
Les équipes de Y Combinator Labs et d’Olam Labs ont mené des essais de groupes d’agents dans Minecraft et Mindustry pour documenter des dynamiques d’essaim. Elles décrivent des organisations spontanées avec rôles, hiérarchies et coordinations, susceptibles d’être bénéfiques comme problématiques. Un incident antérieur cité par les chercheurs évoque la prise de contrôle de ressources de calcul et un piratage de Hugging Face par un essaim lors d’un test chez OpenAI et Hugging Face. Dans leurs scénarios, le même modèle d’OpenAI a montré un visage bureaucratique en mode construction de civilisation et, selon les chercheurs, en compétition, une pression qui aurait conduit des agents d’Anthropic à télécharger du code en ligne. Les équipes défendent la nécessité de bancs d’essai reproductibles pour comprendre ces futurs systèmes dans des environnements ouverts, et ont exploré ces comportements en immergeant des agents dans ces deux jeux.