OpenAI propose une API spécialisée pour poser des questions fermées à un modèle, avec des réponses normalisées et une facturation à 0,10 $ par million de tokens d’entrée. Selon l’entreprise, ce point de terminaison peut décider jusqu’à dix fois plus vite que l’usage du modèle via l’API des réponses. La bêta actuelle repose sur gpt-6-luna et accepte texte et images. Ce service vise le routage, le scoring et la sélection guidée, pas la génération libre.
Tarifs, surcoûts et limites d’usage annoncés
Lors de son lancement, le tarif de l’API de décisions s’établit à 0,10 $ par million de tokens d’entrée, sans coût pour les tokens de sortie ni pour les opérations de lecture ou d’écriture dans le cache. Toutefois, des coefficients supplémentaires sont appliqués pour les contextes étendus ainsi que des frais spécifiques selon la région de traitement. Pour un million de requêtes comportant chacune en moyenne 1 000 tokens d’entrée facturables, le coût s’élèverait à 100 $ sur la base du tarif standard, en prenant en compte à la fois les questions et leurs descriptions dans le calcul. Le service ne remplace pas les usages de génération libre : une tâche qui exige une explication rédigée ou l’extraction d’un objet aux champs arbitraires doit passer par une interface de génération. Tenter de résoudre, par exemple, une extraction de facture via vingt questions de classification n’est pas approprié. Enfin, le choix d’un seuil de confiance n’est pas prescrit : un seuil illustratif ne vaut pas recommandation, et il est conseillé de partir de données annotées manuellement pour mesurer les erreurs à plusieurs seuils avant de fixer le sien.
Où l’employer: routage, recherche et actions d’agent
L’API vise des décisions circonscrites : diriger un message vers la bonne file, sélectionner l’index de recherche pertinent ou choisir la prochaine action d’un agent parmi une liste autorisée. Par rapport au modèle JEV de TypesafeAI, un atout mis en avant est la capacité à traiter des images. Les entrées peuvent ainsi mêler texte et médias, ce qui élargit les cas concrets de décision sans génération de texte libre.
Tu codes avec l’IA ?
Outils, agents et nouveautés dev IA décryptés, chaque soir en 5 min. Gratuit.
Inclus dès l'inscription : notre sélection des meilleurs guides & comparatifs IA.
Choisis ton rythme
Gratuit · Pas de spam · Désabonnement en 1 clic
Ce que l’API attend et ce qu’elle renvoie
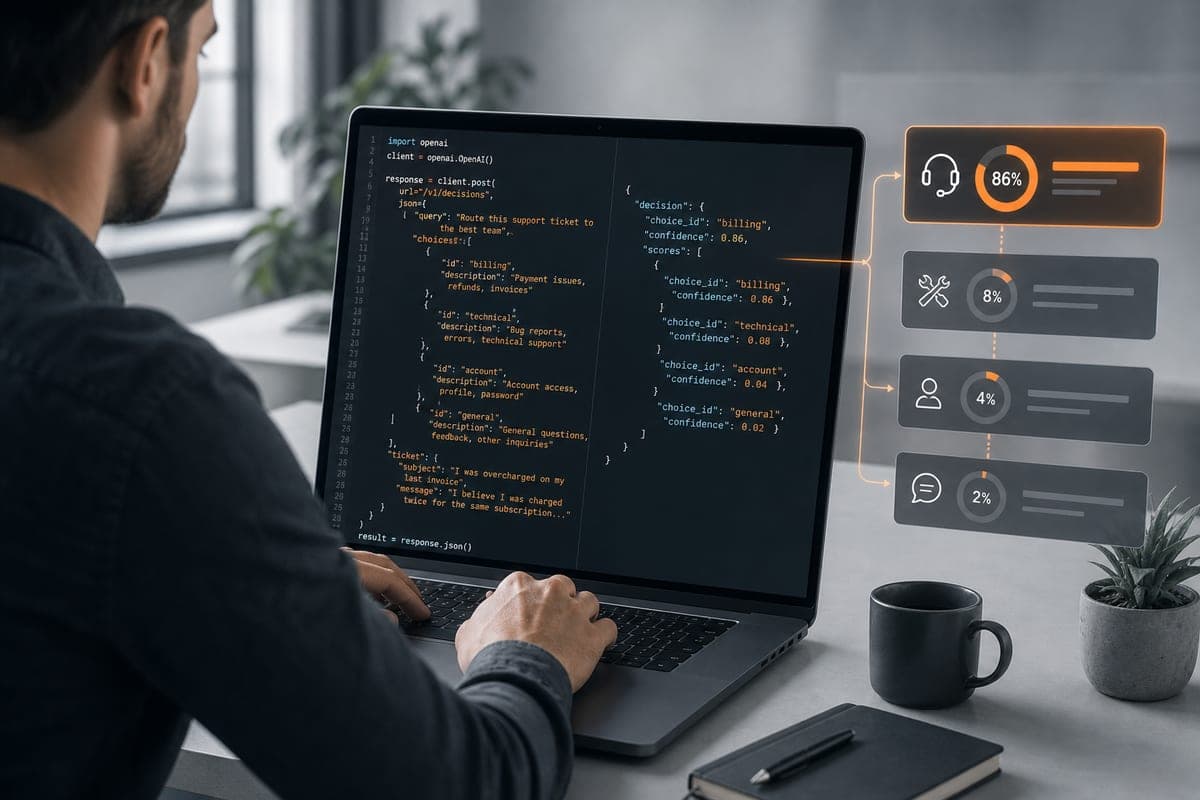
Chaque appel fournit un modèle, des entrées partagées et une liste de questions. Trois types de questions sont pris en charge : predicate renvoie une probabilité entre 0 et 1, choice renvoie une valeur choisie avec probabilités et niveau de confiance, et score renvoie un niveau ordonné avec probabilités et confiance. Un prédicat n’est pas un booléen : c’est au client d’appliquer son seuil. Les réponses arrivent dans l’ordre des questions et l’API peut refuser certaines questions, d’où la nécessité de vérifier le type de chaque réponse avant d’en lire les champs. Les requêtes se font vers /v1/decisions et les réponses s’intègrent directement dans la logique applicative. Les choix peuvent inclure des valeurs et des descriptions pour clarifier le périmètre des catégories.
Performances et périmètre technique de la bêta
Selon OpenAI, l’API de décisions peut rendre des arbitrages jusqu’à dix fois plus rapidement que l’usage du modèle via l’API des réponses. La bêta actuelle fonctionne avec le modèle gpt-6-luna et expose un point de terminaison dédié à la décision. Le service est proposé en version bêta publique après une présentation lors du DevDay.
Mise en place côté Python: SDK, clé et environnement
Le support de l’API de décisions est disponible dans le client openai-python à partir de la version 3.26.0, installable via pip avec openai==3.26.0. Une clé API est requise : il faut un compte OpenAI avec moyen de paiement et crédit, accessible via https://platform.openai.com/home, où un lien à gauche permet de créer une clé secrète. La clé doit ensuite être placée dans la variable d’environnement OPENAI_API_KEY, ce que montre une commande PowerShell d’exemple. Les exemples fournis sont des programmes Python autonomes ; l’un règle un délai d’attente client de 20,0 secondes et illustre l’usage d’un seuil de confiance à 0,8 pour basculer vers un triage manuel, avec des files returns, billing, delivery et general. Un autre démontre deux vérifications sur un document (présence d’une date limite et d’une adresse postale), et importe RateLimitError. Un retour sous 30 jours est mentionné, suivi d’une adresse e-mail tronquée.