OpenAI renforce les défenses de GPT-6.2 Astra et GPT-6.2 Sol contre l'extraction de leur raisonnement interne. Dans ses tests internes, le taux de réussite des attaques visant une demande antérieure passe de 54,0 % sur GPT-6 Astra à 0,2 % sur GPT-6.2 Astra. Certaines améliorations doivent aussi être appliquées à GPT-6 Astra.
OpenAI et Anthropic bannissent des comptes
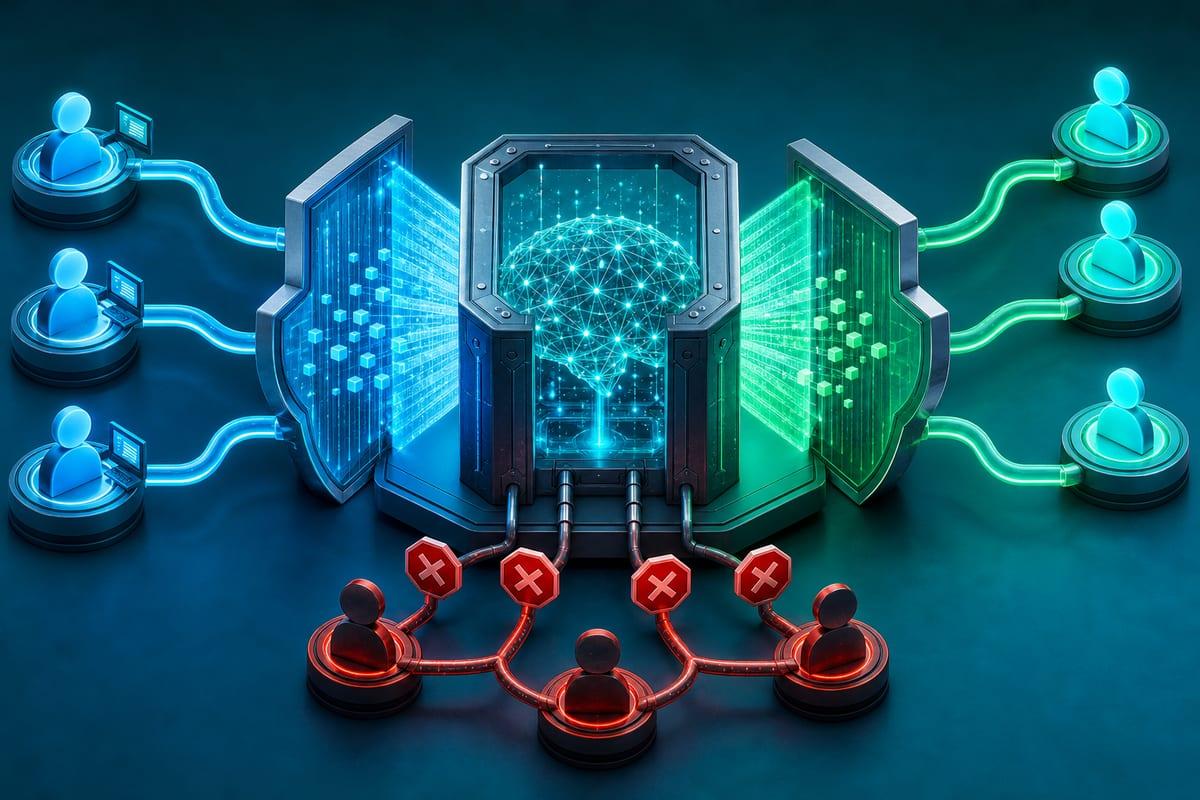
Contre les campagnes coordonnées, OpenAI bannit chaque semaine des milliers à des dizaines de milliers de comptes. Anthropic combat aussi la distillation systématique et bannit des dizaines de milliers de comptes pour limiter le vol de raisonnement interne.
Ces mesures chez Anthropic semblent aboutir dans 90 à 99 % des cas. L'entreprise a par ailleurs demandé aux industriels et aux responsables politiques d'organiser une réponse commune.
Vous suivez la course aux modèles IA ?
Chaque sortie (GPT, Claude, Gemini, Mistral…) décryptée le soir même, en 5 min. Gratuit.
Inclus dès l'inscription : notre sélection des meilleurs guides & comparatifs IA.
Choisissez votre rythme
Gratuit · Pas de spam · Désabonnement en 1 clic
Des filtres et des tests pour protéger les demandes
Pour chaque demande, OpenAI combine un entraînement ciblé et des filtres appliqués aux messages et aux appels d'outils, en entrée comme en sortie. Des restrictions dans l'API interdisent aussi aux anciens modèles l'accès au raisonnement protégé.
L'entreprise compare GPT-6 Astra, doté des défenses initiales, à GPT-6.2 Astra, équipé des nouvelles protections, dans des tests automatisés internes. Pour les attaques visant une demande active, elle rapporte un taux de réussite de 22,9 % sur le premier modèle, contre 0,9 % sur le second. Les résultats agrègent six modèles d'attaquants dans des tests adaptatifs en boîte noire. L'indicateur utilisé, l'ASR, mesure la réussite des attaques : plus il est faible, meilleure est la protection.