Tu suis la course aux modèles IA ?
Chaque sortie (GPT, Claude, Gemini, Mistral…) décryptée le soir même, en 5 min. Gratuit.
Inclus dès l'inscription : notre sélection des meilleurs guides & comparatifs IA.
Choisis ton rythme
Gratuit · Pas de spam · Désabonnement en 1 clic
Servir des LLM efficacement impose de séparer ce qui relève du calcul et ce qui bute sur la mémoire. Entre quantification, variantes d’attention et politiques de batching, plusieurs techniques apportent des gains concrets de débit et de coût. Certaines, comme FlashAttention, s’appliquent sans réentraîner ; d’autres, comme MQA, exigent un entraînement adapté.
Réduire la taille du modèle avec la quantification
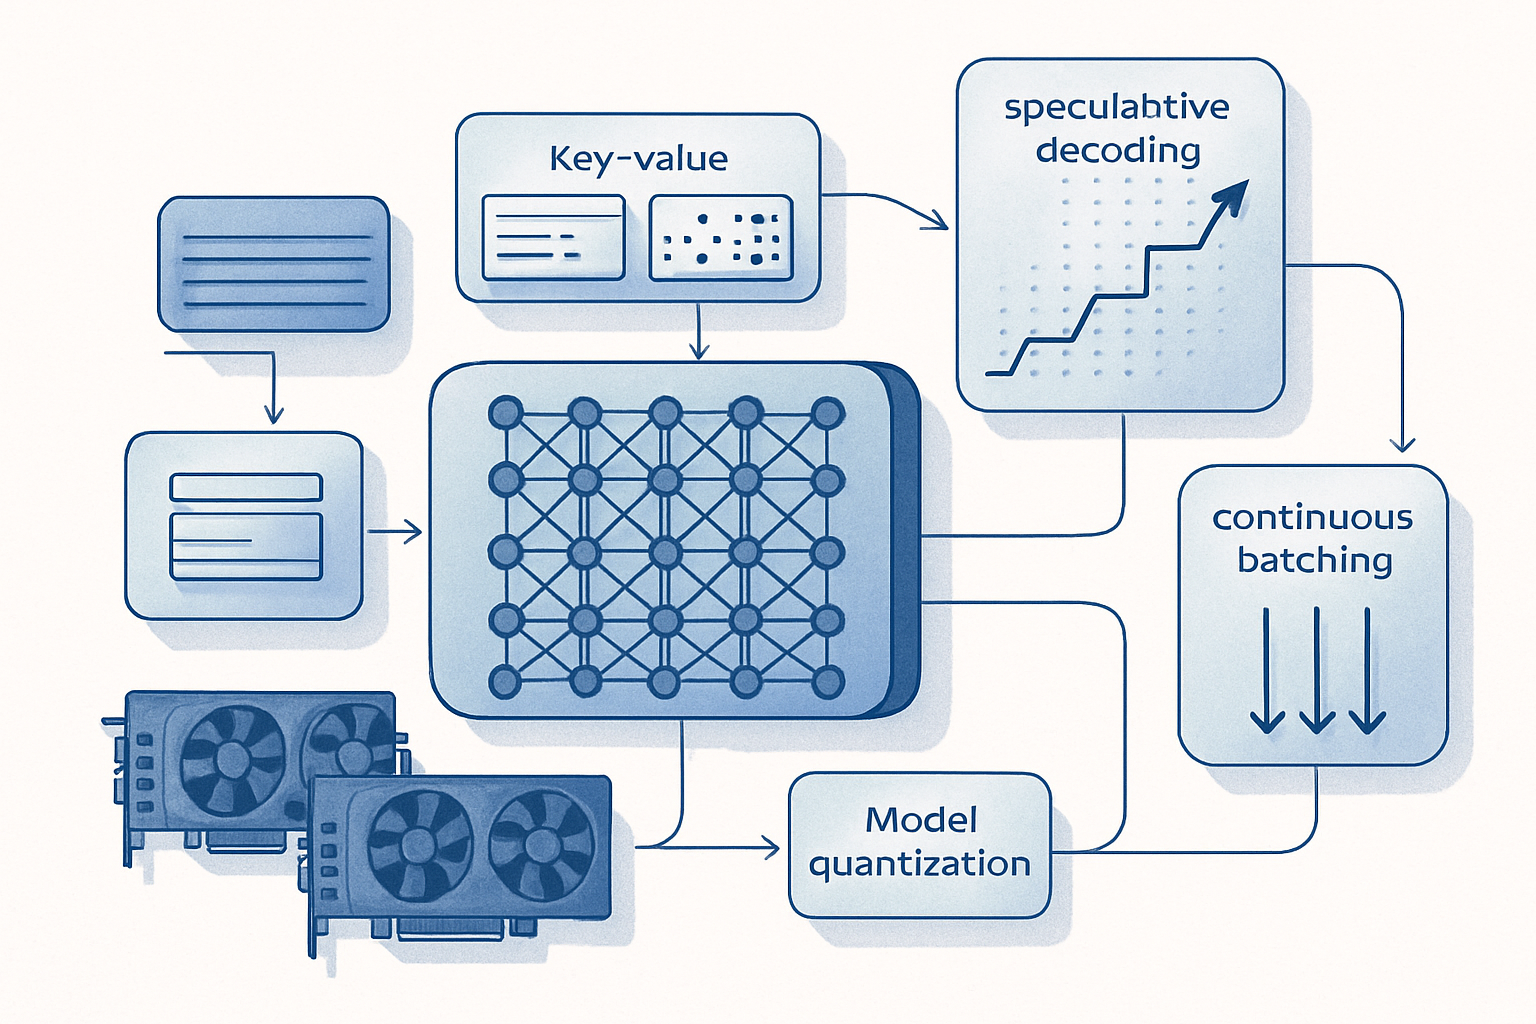
La compression de modèle permet de diminuer la taille et d'accélérer l'inférence, avec un compromis sur la précision qui peut rester limité si la méthode est bien choisie. La quantification consiste à réduire la précision numérique des poids, et parfois des activations. Un modèle entraîné en 16 bits flottants occupe environ 2 octets par paramètre ; en 8 bits entiers, 1 octet ; en 4 bits, 0,5 octet. Pour un modèle de 7 milliards de paramètres, passer de FP16 à INT4 fait passer la mémoire requise d'environ 14 Go à 3,5 Go. Cette réduction peut permettre d'utiliser un matériel moins coûteux ou plus accessible. Des techniques comme GPTQ et AWQ ont permis d'obtenir des modèles quantifiés en 4 bits.
Ajuster l’attention pour limiter le trafic mémoire
L'attention représente la principale part du calcul lors de l'inférence des transformateurs. Le mécanisme multi-tête classique (MHA) utilise des têtes de clé et de valeur distinctes pour chaque tête d'attention. Avec MQA, toutes les têtes de requête partagent un même ensemble de clés et de valeurs, ce qui réduit la quantité de données à transférer en phase de decode, sans modifier le calcul, mais au prix d'une légère perte de précision ; il faut entraîner ou ajuster le modèle avec MQA pour en bénéficier à l'inférence. GQA regroupe les têtes de clé et de valeur par groupes, offrant la plupart des gains mémoire de MQA tout en conservant une capacité de modélisation supérieure à MQA seul. FlashAttention, de son côté, réorganise l'ordre des calculs et utilise le tiling pour conserver les valeurs intermédiaires dans la mémoire SRAM rapide, ce qui réduit fortement le trafic mémoire sans changer le résultat mathématique. Cette optimisation s'applique directement, sans nécessiter de réentraînement du modèle.
Orchestrer les requêtes : du statique au batching en vol
Lorsque le traitement s'effectue requête par requête, le GPU n'est pas pleinement exploité, car les poids du modèle doivent être placés en mémoire à chaque passage avant, indépendamment du nombre de tokens. Accroître le nombre de requêtes traitées simultanément permet de répartir ce coût et d'augmenter le débit. Le batching statique, qui attend qu'un lot fixe soit constitué, est peu efficace lorsque les longueurs de sortie varient : le lot ne progresse pas tant que la requête la plus longue n'est pas terminée, ce qui ralentit l'ensemble. Le batching dynamique regroupe les requêtes arrivant dans une courte fenêtre, avec une taille maximale et un délai d'attente ; il démarre dès qu'un seuil est atteint, avec un compromis entre latence et taille de lot. Cependant, une fois lancé, toutes les requêtes avancent ensemble, ce qui peut bloquer les plus courtes. Le batching continu, ou en vol, évince immédiatement les séquences terminées et insère de nouvelles requêtes sans attendre la fin des autres, maintenant ainsi une utilisation élevée du GPU même avec des sorties très variables. Cette stratégie est désormais la norme dans des environnements de production comme vLLM et TensorRT-LLM.
Maîtriser la mémoire du KV cache avec PagedAttention et préfixes partagés
Le KV caching consiste à stocker en mémoire GPU les clés et valeurs des tokens précédents pour accélérer la phase de decode, en échange d'une consommation mémoire accrue. Les besoins en mémoire du cache augmentent avec la taille du lot et la longueur des séquences ; pour un modèle de 7 milliards de paramètres en 16 bits, il peut consommer plusieurs gigaoctets par requête à des longueurs modérées. Avec des contextes longs ou de grands lots, la mémoire devient la principale limite au nombre de requêtes simultanées. Une allocation naïve à la longueur maximale provoque une fragmentation interne importante. PagedAttention segmente le cache en blocs de taille fixe, alloués à la demande au fil de la génération, sans pré-réservation, ce qui réduit le gaspillage et permet d'augmenter la taille des lots et le débit à matériel constant. vLLM active cette approche par défaut. Lorsque plusieurs requêtes partagent un même préfixe, le prefix caching permet de calculer et de réutiliser une seule fois ce segment commun ; dans des pipelines RAG ou avec de longs prompts système, cela peut éliminer une part notable des calculs redondants.
Lire les métriques selon prefill et decode
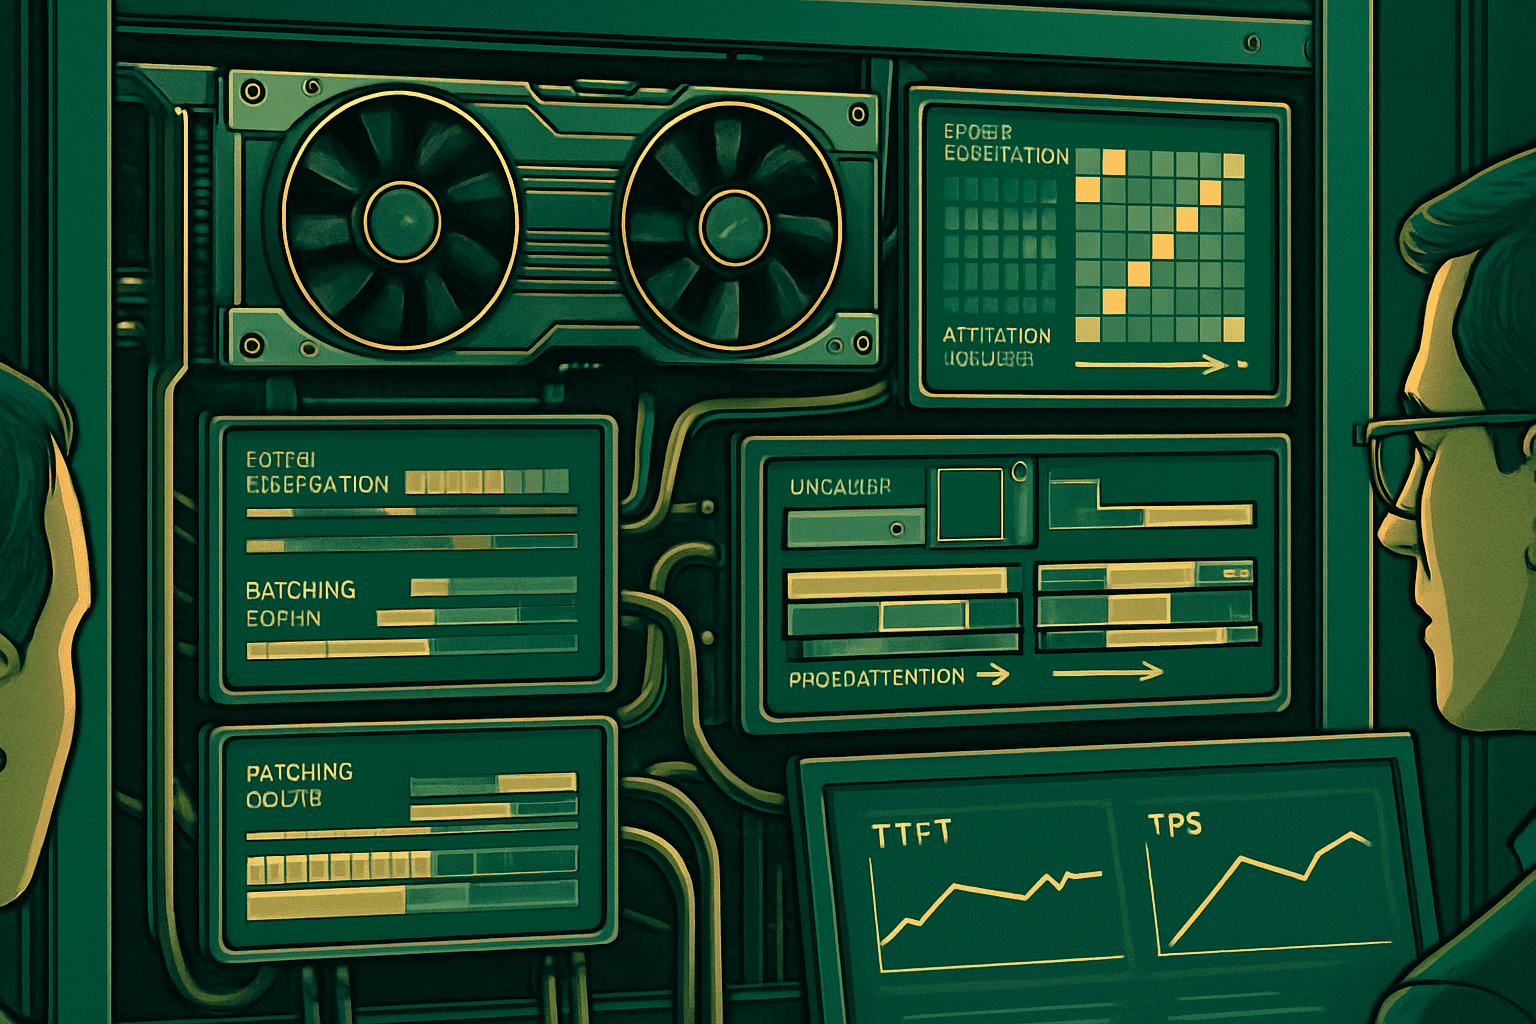
L'inférence des LLM uniquement décodeurs se divise en deux phases distinctes : prefill et decode, chacune avec ses propres contraintes. La phase de prefill, hautement parallélisée et limitée par le calcul, prépare les clés et valeurs pour le premier token. Ensuite, la phase de decode génère les tokens un à un, sans parallélisme intra-séquence, et se heurte principalement à la bande passante mémoire, le GPU passant beaucoup de temps à attendre les transferts de données. Les optimisations efficaces sont celles qui réduisent le volume de données déplacées ou augmentent le travail utile par accès mémoire. Le temps jusqu'au premier token (TTFT) mesure la performance du prefill, tandis que les tokens par seconde (TPS) après le premier token reflètent le decode. Améliorer l'une de ces phases n'améliore pas forcément l'autre ; le choix des techniques dépend de la métrique prioritaire pour l'usage visé.
Autres leviers : decoding spéculatif et multi-GPU
Des stratégies combinant gestion de la mémoire, batching et optimisations d'attention permettent d'améliorer directement le débit et la latence. Le decoding spéculatif est mentionné comme un moyen de réduire le coût d'inférence. Le parallélisme multi-GPU peut augmenter la capacité d'inférence pour des charges de travail importantes ou exigeantes.