Tu veux les meilleurs outils IA avant les autres ?
On teste et on décrypte les nouveaux outils IA chaque soir, en 5 min. Gratuit.
Inclus dès l'inscription : notre sélection des meilleurs guides & comparatifs IA.
Choisis ton rythme
Gratuit · Pas de spam · Désabonnement en 1 clic
Quatre assistants IA ont été confrontés à un jeu de données truffé de quatre pièges inspirés du commerce de détail. Malgré une invite explicite sur le calendrier des données, deux systèmes ont rapporté des scores en dessous d’un plancher d’erreur fixé par le bruit du processus. Classés par MAE déclaré, les résultats s’inversent presque lorsqu’on retient ce qui est exploitable en production.
Deux scores sous le plancher d’erreur et un podium inversé
Parmi les quatre scores présentés, deux affichent des valeurs inférieures au seuil que ne peut dépasser une prévision considérée comme honnête. Si l’on classe les modèles selon le MAE déclaré, DeepSeek occupe la première position tandis que GPT-6 Sol se retrouve en dernière place. Si l’on classe selon ce qui pourrait effectivement être déployé en production, l’ordre est presque exactement inversé. Sur les 52 dernières semaines du jeu de données, le processus lui-même obtient un MAE d’environ 49, soit environ un écart type en dessous de 56, ce qui reste dans la variation normale. Avec σ fixé à 70, le MAE minimal attendu tourne autour de 56, et la moyenne de l’erreur attendue sur une fenêtre a un écart type d’environ 6. Le 15 annoncé par DeepSeek est rapporté comme réel.
Un critère d’honnêteté prime sur tout le reste
Les critères d’évaluation ont été définis avant l’examen des réponses et portent sur les modèles finaux plutôt que sur leurs commentaires. Un principe surplombe les autres : les chiffres ne sont pris en compte que s’ils sont reproduits par le code relancé à l’identique. Un résultat non reproductible, même correctement argumenté, est écarté.
Quatre pièges alignés sur des réalités métiers
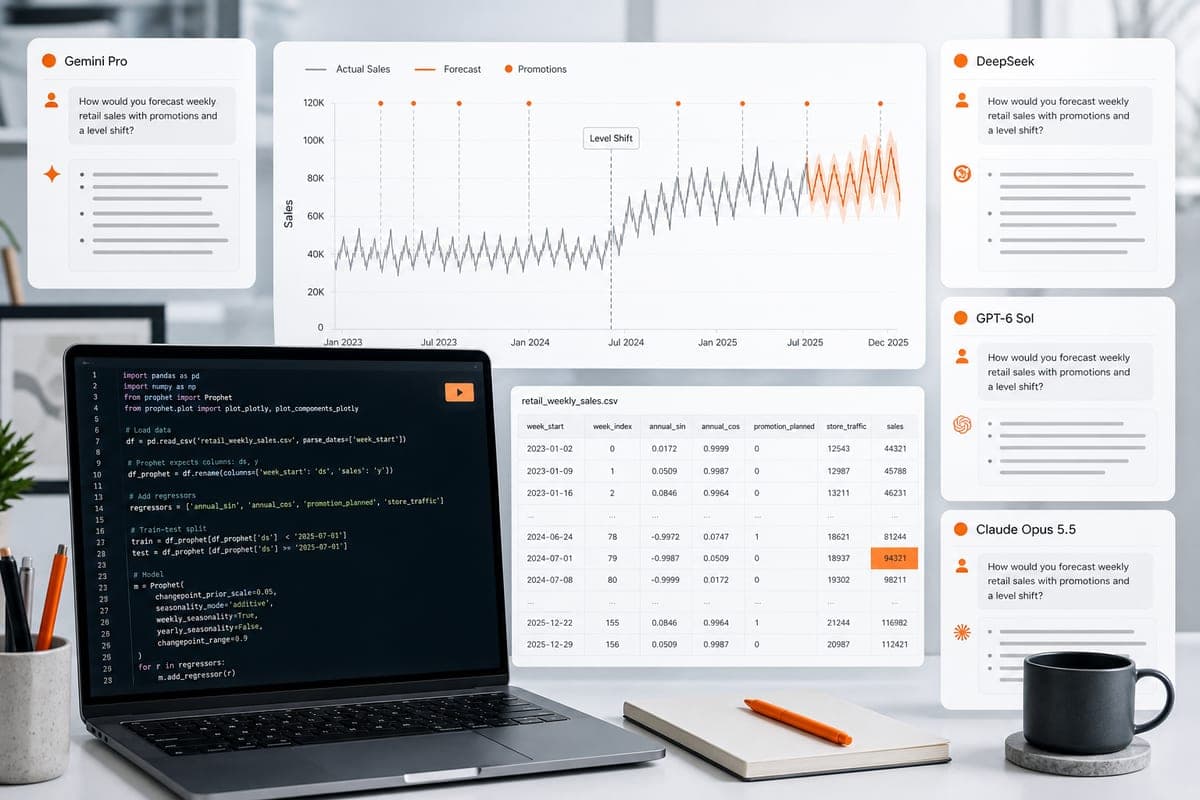
Quatre pièges, issus de situations fréquentes en distribution, sont intégrés dans 156 semaines de données allant de janvier 2023 à décembre 2025. D’abord, store_traffic connaît la réponse pour la semaine cible et, bien que fortement corrélée aux ventes, n’est pas disponible au moment de la prévision. Ensuite, les ventes ne sont connues qu’avec deux semaines de retard, ce qui interdit d’utiliser les deux dernières semaines et impose de remonter à trois semaines pour construire des variables retardées. Troisièmement, une chute suit les promotions, le calendrier étant connu à l’avance et la promotion de la semaine passée constituant une variable valide non signalée dans l’invite. Enfin, un concurrent fait baisser le niveau des ventes à mi-parcours de la dernière année, sans variable dédiée, obligeant à détecter un changement via l’analyse des erreurs. Les deux premiers pièges testent le raisonnement temporel, les deux derniers l’examen des données au-delà du seul score.
Règles de succès explicites et risques d’échec
Les conditions de réussite sont détaillées pour chaque piège. La variable store_traffic ne doit jamais être utilisée en entrée, un simple avertissement n’y change rien. Les variables construites à partir des ventes doivent se limiter à des valeurs âgées d’au moins trois semaines, toute utilisation des deux dernières conduisant à un échec. La chute post‑promotion doit être soit intégrée via la promotion de la semaine précédente, soit explicitement identifiée. Le changement de niveau dû au concurrent doit être géré, ou à défaut signalé, l’inaction face à l’erreur après rupture étant éliminatoire.
Invite cadrée et protocole de test des assistants
L’énoncé détaille que chaque ligne correspond à une semaine, que les données sont classées dans l’ordre chronologique, que l’entraînement du modèle s’effectue sur l’historique afin de prédire la semaine suivante, que le planning des promotions est disponible à l’avance et que les chiffres de ventes sont accessibles deux semaines après la clôture de la semaine concernée. Les informations fournies incluent la date de début de semaine, un numéro de semaine, deux variables saisonnières, un marqueur de promotion prévue, le trafic en magasin pour la semaine à prédire ainsi que la variable cible des ventes. Il est demandé d’inclure préparation, entraînement, une évaluation estimant la performance sur des semaines futures et de rapporter le MAE. Chaque modèle a reçu exactement le même fichier et la même invite, dans une conversation distincte, l’invite décrivant fidèlement les colonnes sans indiquer quoi chercher. Les systèmes testés sont Gemini Pro, DeepSeek, GPT-6 Sol et Claude Opus 5.5. Les essais ont été menés dans les interfaces de chat usuelles, avec abonnements payants pour Gemini, ChatGPT et Claude, et niveau gratuit pour DeepSeek. Claude Opus 5.5 a contribué à la conception de l’expérience ; un tiers a réalisé son essai sur un compte séparé, avant une évaluation unifiée des réponses.
Un pré-test temporel que tous ont correctement traité
Avant les pièges, un pré-test demandait de prédire la semaine suivante et d’évaluer la performance sur des semaines futures, ce qui impose un apprentissage sur une période antérieure et un test sur une période ultérieure. Les données de ce cas comprenaient trois années de ventes hebdomadaires avec tendance, saisonnalité, effet promotionnel et bruit, toutes variables étant disponibles au moment de la prévision. L’invite ne prescrivait pas la séparation, que tous les modèles ont pourtant correctement traitée en respectant la chronologie, sans fuite. Cette première étape montrait que les assistants maîtrisent les recettes de base, ce qui a motivé un test plus exigeant avec des pièges et une vérification de la reproductibilité des chiffres. Le cadre théorique rappelle que les ventes combinent une composante μ_t apprenable et un bruit ε_t i.i.d. de variance σ^2, que l’on ne peut réduire. L’espérance du MAE d’un modèle idéal vaut 2σ/√(2π), soit environ 56 pour σ=70, avec une fluctuation d’environ 6 sur une fenêtre. Sur les 52 dernières semaines, le processus obtient environ 49, compatible avec cette borne.