Un exemple Python compare trois prédictions simulées pour distinguer l'entropie d'une distribution et la perte d'entropie croisée. Aucun véritable modèle de langage n'est chargé : les probabilités sont fixées à l'avance.
Une prédiction confiante peut être incorrecte
Le vocabulaire de la simulation comprend cinq entrées : pomme, banane, chat, chien, éléphant. Le résultat attendu est « chat », placé à l'index 2. La distribution cible, appelée P, prend donc la forme [0.0, 0.0, 1.0, 0.0, 0.0].
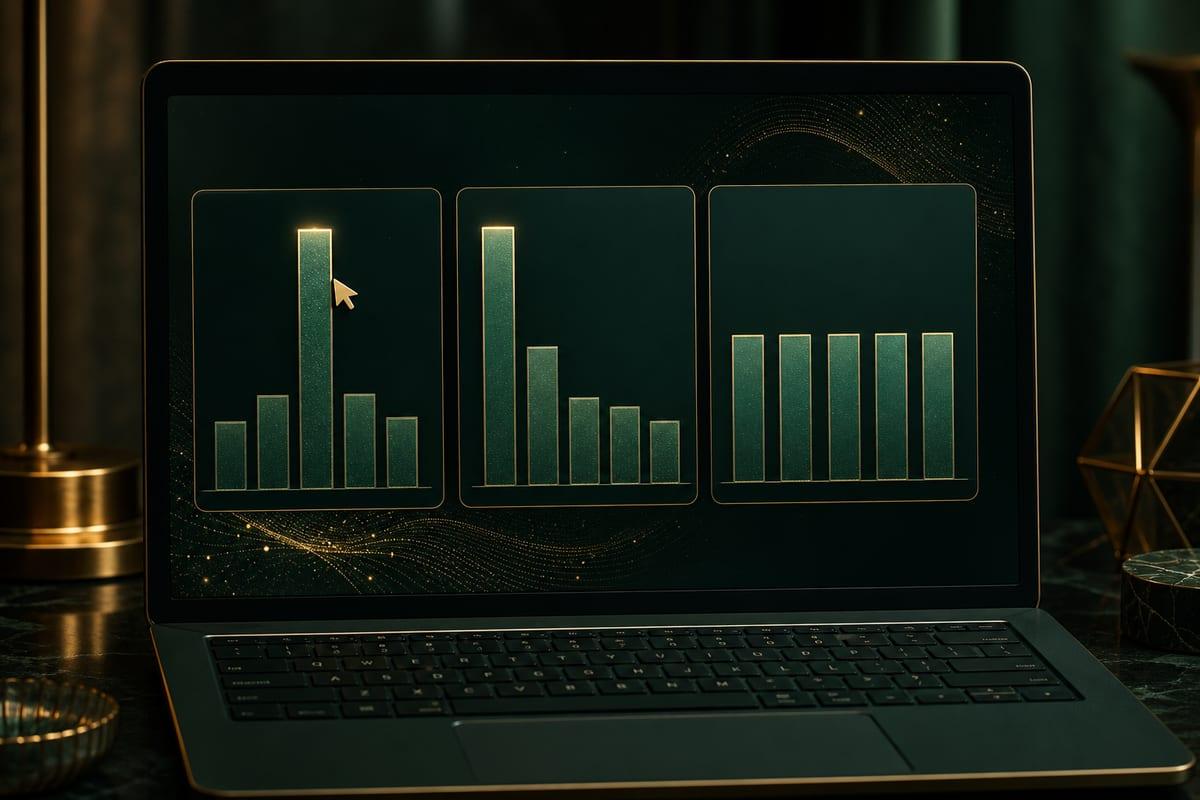
Dans le cas confiant et correct, les probabilités suivent cet ordre : [0.02, 0.03, 0.90, 0.03, 0.02]. Le cas confiant mais incorrect privilégie au contraire « pomme », avec [0.80, 0.05, 0.05, 0.05, 0.05]. Enfin, le cas incertain accorde la même probabilité à chaque entrée : [0.20, 0.20, 0.20, 0.20, 0.20].
Ces hypothèses sont réunies dans le dictionnaire Python models ; elles ne correspondent pas à des performances mesurées sur des systèmes réels. Pour chacune, le calcul confronte la distribution prédite à P au moyen de l'entropie croisée.
L'entropie mesure l'incertitude
Introduite par Claude Shannon en 1948, l'entropie quantifie l'incertitude associée à une distribution de probabilité. Sa définition est H(P) = −Σ P(x) log₂ P(x). Lorsque les issues ont toutes la même probabilité, cette mesure atteint son maximum ; lorsqu'une distribution se concentre davantage sur certaines issues, elle diminue.
Un dé équilibré fournit un exemple d'incertitude maximale. Un dé favorisant fortement le 6 présente au contraire une faible entropie. Pour une prédiction textuelle, une distribution étalée traduit de même une forte incertitude, tandis qu'une probabilité presque entièrement concentrée sur « tatami » correspond à une faible entropie.
Le code distingue explicitement cette mesure de la perte : shannon_entropy applique −Σ dist × log₂(dist + 1e-9), tandis que cross_entropy applique −Σ true_dist × log₂(pred_dist + 1e-9). La première fonction porte sur la distribution prédite elle-même. La seconde fait également intervenir la distribution cible.
Vous suivez la course aux modèles IA ?
Chaque sortie (GPT, Claude, Gemini, Mistral…) décryptée le soir même, en 5 min. Gratuit.
Inclus dès l'inscription : notre sélection des meilleurs guides & comparatifs IA.
Choisissez votre rythme
Gratuit · Pas de spam · Désabonnement en 1 clic
L'entraînement favorise le mot attendu
Les modèles de langage produisent leur texte par étapes successives, plutôt qu'en générant une réponse entière simultanément. Avant chaque sortie, leur couche finale attribue des probabilités aux éléments du vocabulaire, qui comporte généralement des dizaines de milliers de mots. L'entropie et l'entropie croisée relient ce mécanisme de prédiction à la théorie de l'information.
Pour la séquence « le chat est assis sur le ... », l'exemple d'entraînement peut imposer « tatami » comme réponse attendue. La distribution cible attribue alors 100 % à ce mot et 0 % aux autres. Elle remplit le rôle d'une étiquette connue en apprentissage automatique ; dans la simulation Python, c'est P qui fournit cette entrée au calcul de la perte.
L'objectif n'est pas seulement de rendre une prédiction moins incertaine : l'entropie croisée confronte les probabilités proposées à cette cible. Sa minimisation déplace progressivement la probabilité vers le mot attendu. Répété sur des millions ou des milliards d'exemples au fil de nombreuses itérations, cet apprentissage permet au modèle de produire des réponses cohérentes.
Plotly affiche les probabilités au survol
L'illustration s'exécute dans un notebook ou un script Python, avec NumPy pour les opérations numériques et Plotly pour les diagrammes interactifs. Elle repose uniquement sur les tableaux de probabilités définis dans le code.
Les graphiques occupent une ligne et trois colonnes, avec une échelle verticale commune allant de 0 à 1. Le titre de chaque panneau indique le scénario, l'entropie en bits et la perte, affichées avec deux décimales. La barre de « chat » apparaît en vert, les autres en bleu, sans légende séparée.
Au survol, chaque barre révèle le token concerné, sa probabilité exprimée en pourcentage avec une décimale et l'indication qu'il s'agit ou non de la cible.