La recherche en IA te passionne ?
Les papers et avancées qui comptent, expliqués simplement, chaque soir. Gratuit.
Inclus dès l'inscription : notre sélection des meilleurs guides & comparatifs IA.
Choisis ton rythme
Gratuit · Pas de spam · Désabonnement en 1 clic
Quatre défauts réalistes suffisent à mettre en échec un récupérateur RAG simple et à induire un modèle en erreur. Des tests d'injection de fautes et un contrôle de preuve systématique permettent de les détecter, puis d'y répondre avec des correctifs ciblés : règle de récence, normalisation OCR prudente, matching flou et ingestion adaptée des tableaux multi‑pages.
Des preuves sont exigées pour valider les affirmations avancées.
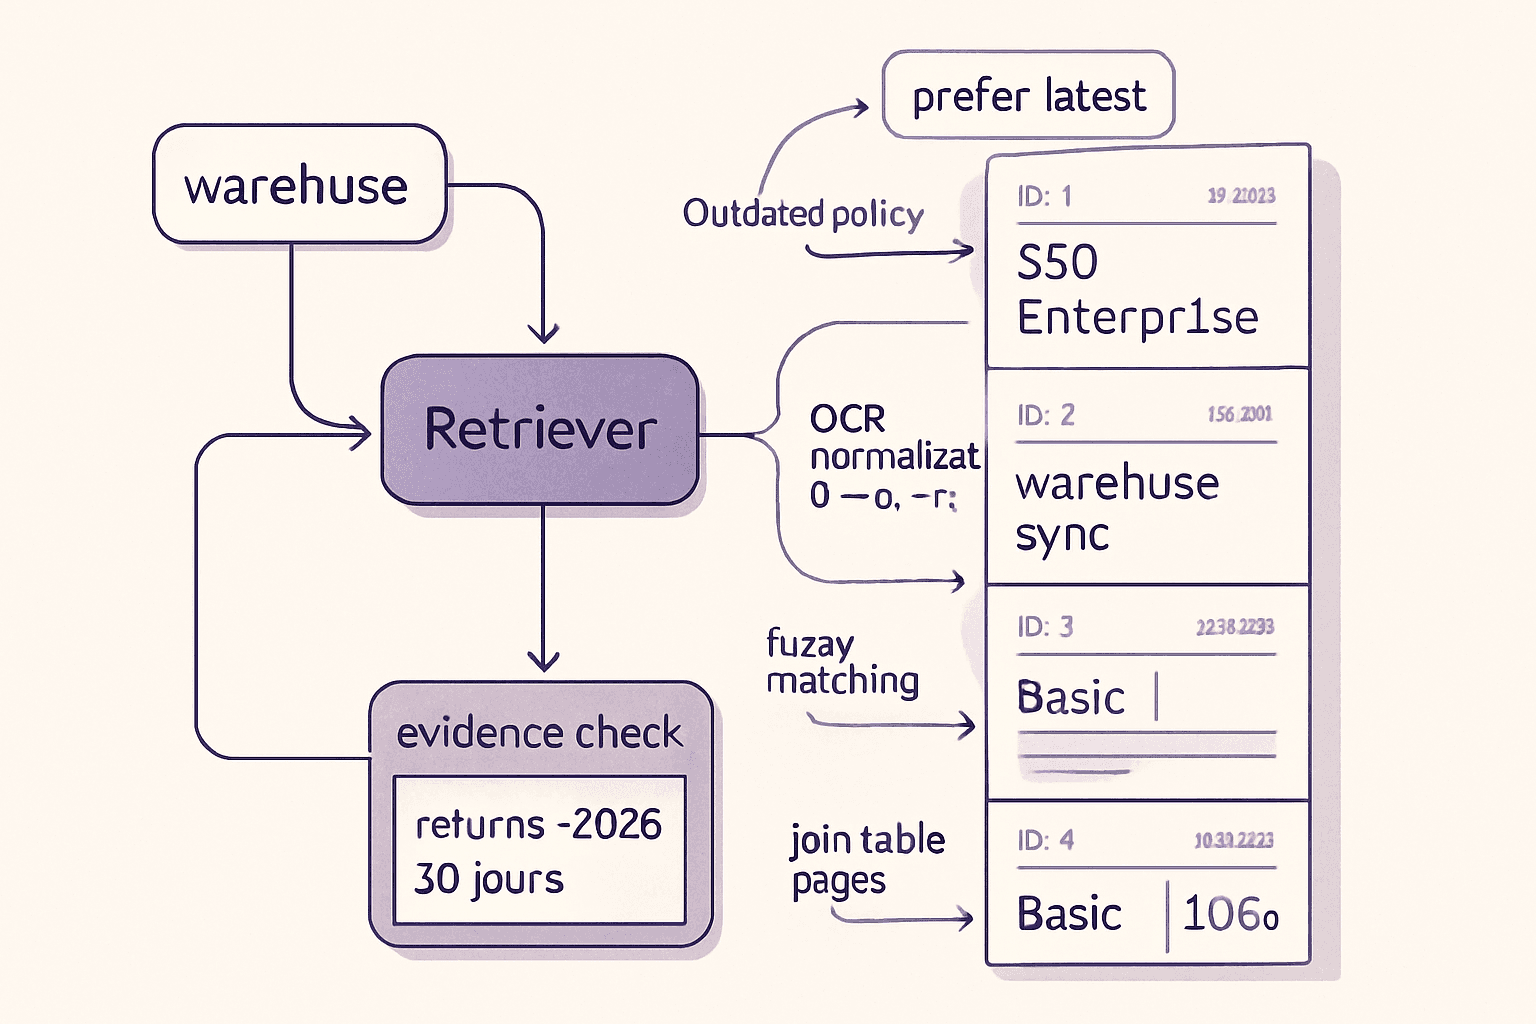
L'identifiant du document renvoyé indique quelle source a été classée en premier, mais cela ne garantit pas que la réponse soit fondée sur les bonnes informations. Un contrôle de preuve impose la présence de mots ou de valeurs nécessaires dans le passage récupéré. Par exemple, un test sur la politique de retour exige à la fois l'ID returns-2026 et la mention « 30 jours », tandis qu'un test sur un tableau requiert « Basic » et « 10 Go » dans le même passage. Ces vérifications facilitent le diagnostic : un mauvais ID signale un problème de classement ou de filtrage, un bon ID sans le texte attendu pointe vers un défaut d'extraction ou de découpage, et un bon ID avec les preuves requises fournit au modèle de langage le contexte nécessaire, même si la réponse finale doit encore être évaluée. Si plusieurs passages sont transmis au modèle, le contrôle de preuve s'applique au texte combiné.
Quatre requêtes corrompues révèlent les faiblesses du récupérateur
L'exécution de quatre entrées volontairement corrompues provoque quatre échecs sur un récupérateur simple. Une fois les corrections activées pour chaque cas, les quatre requêtes renvoient le document attendu. Les correctifs sont ciblés : tie-breaker par date, normalisation d'erreurs OCR connues, correspondance orthographique approchée et préservation des lignes de tableau à l'ingestion. Chaque mécanisme cible une cause distincte, et des tests séparés permettent d'identifier la protection manquante. Ces essais complètent l'évaluation de pertinence classique, qui mesure le comportement sur des entrées attendues, tandis que l'injection de fautes mesure la robustesse face à des défauts réalistes.
Contradictions entre versions : trancher à date égale
La politique de retour, passée de 60 à 30 jours au début de 2026, illustre le risque des doublons : l'ingestion a ajouté la nouvelle page sans retirer l'ancienne, et les deux textes partagent les mêmes mots clés, aboutissant à une égalité de score. Résolue par l'ordre de la liste, cette égalité renvoie la version de 2024 et pourrait indiquer 60 jours au lieu de 30. Un tiebreaker fondé sur la récence privilégie la mise à jour la plus récente et corrige ce cas. Cette règle convient aux politiques explicitement remplacées, tandis que d'autres collections peuvent nécessiter un statut actuel ou retiré lorsque la nouveauté ne signifie pas remplacement.
Bruit OCR : normaliser sans casser les données
Si « Enterprise » est transformé en « Enterpr1se » et « SSO » en « SS0 » dans un texte, les points associés aux tokens enterprise et sso tombent à zéro, ce qui mène à une égalité générale résolue par l'ordre de la liste. Une normalisation simple qui convertit 0 en o et 1 en i, appliquée aux requêtes et aux documents avant la tokenisation, rétablit les correspondances. Ces règles doivent toutefois rester limitées : transformer tous les 0 en o peut altérer des codes produits ou des mesures. Les substitutions sont à construire à partir des erreurs réellement observées et à limiter aux champs où elles sont sûres.
Fautes d'orthographe : recourir au matching flou et régler le seuil
Avec la requête « warehuse sync », la correspondance exacte traite le terme mal orthographié comme non lié et laisse « sync » départager les résultats, au bénéfice du document apparu en premier. En activant la similarité orthographique, le mot « warehuse » se rapproche suffisamment de « warehouse » pour que le document d'inventaire l'emporte. Le seuil de similarité devient alors déterminant : trop bas, il associe des mots sans lien ; trop élevé, il laisse passer des fautes courantes. Des seuils fondés sur des requêtes réelles sont plus pertinents que ceux issus de quelques erreurs inventées.
Tableaux sur plusieurs pages : réparer à l'ingestion
Quand l'extraction PDF découpe un tableau par pages, un premier passage peut contenir l'étiquette « Basic | » sans la valeur « 10 Go », placée sur la page suivante. Ce morcellement favorise le rang du passage incomplet et prive le modèle de la donnée chiffrée. La correction relève du pipeline d'ingestion : détecter les fragments de tableau et joindre les pages liées avant le découpage en passages consultables. Joindre systématiquement chaque paire de pages produirait des passages trop volumineux et des mélanges de contenus ; la règle doit viser les tableaux détectés ou intégrer juste assez de contexte voisin pour préserver chaque ligne.
Le banc d’essai minimal : quatre documents, un score par tokens
Le banc d'essai repose sur quatre documents courts et un score simple : 1 point par token de requête présent dans le document après tokenisation en minuscules via la regex [a-z0-9]+. Chaque document conserve un identifiant, un sujet et une date de mise à jour. Les exemples incluent returns-2026 avec 30 jours, plans mentionnant SSO, crm avec synchronisation des contacts toutes les cinq minutes et inventory avec synchronisation toutes les 15 minutes. Les environnements de production recourent souvent à des techniques de correspondance plus sophistiquées, mais les défauts illustrés peuvent les affecter de la même manière.