Des scripts et conteneurs publiés permettent d’affiner TRELLIS.2 avec LoRA, en local ou via Hugging Face Jobs. La méthode cible la structure et la géométrie, avec des chiffres concrets à la clé : 16 vues par objet et environ une heure pour 188 maillages sur a100-large. Les jeux de données peuvent être poussés et réutilisés sur le Hub.
Un flux mesuré : 16 vues par objet et une heure pour 188 modèles
Le prétraitement génère 16 vues de chaque objet à l'aide de Blender, qui servent ensuite d'images de conditionnement pour l’entraînement LoRA. Sur un travail a100-large, la préparation d’un lot de 188 objets a pris environ une heure. Le matériel est spécifié avec l’argument --flavor a100-large, correspondant à une carte de 80 Go. Les paramètres incluent un timeout à 6h, les options --holdout 0.05, --views 16 et --workers 8, et la publication des sorties vers un dépôt du Hub. En mode détaché, l’outil affiche l’ID et l’URL du job, et les logs sont accessibles via la commande dédiée.
Ce qui est livré : deux images Docker et un chemin en quatre étapes
Des scripts et conteneurs prêts à l’emploi permettent d’affiner TRELLIS.2 localement ou sur Hugging Face Jobs. Deux images Docker sont proposées : l’une pour le prétraitement, l’autre pour le fine-tuning. Le déroulé recommandé tient en quatre actions : donner l’accès aux données aux conteneurs, fixer les paramètres de la tâche, exécuter l’image de prétraitement puis celle d’entraînement. L’ensemble de données prétraité est sauvegardé afin d’être réutilisable lors de sessions ultérieures.
Cibler la forme : LoRA sur deux DiT et pas sur la texture
Les adaptateurs LoRA sont appliqués uniquement au flux de structure sparse DiT et au flux de forme DiT, qui déterminent la forme et la géométrie de l’objet. Le flux de texture DiT est gelé pour conserver ses capacités actuelles. L’ensemble de données utilisé comporte des cartes de couleur diffuse mais pas de cartes de matériau séparées, les premières mélangeant couleur de surface et éclairage ; elles ne constituent donc pas des cibles correctes pour entraîner la texture. Un entraînement inadapté pourrait amener le modèle à confondre éclairage et matériau et provoquer un oubli catastrophique. Sur un sous-ensemble de 188 chaussures, les tests initiaux montraient des semelles incorrectes avec le modèle pré-entraîné ; un LoRA est expérimenté pour améliorer ce point, tandis que les couleurs et textures du modèle de base sont jugées satisfaisantes.
La recherche en IA vous passionne ?
Les papers et avancées qui comptent, expliqués simplement, chaque soir. Gratuit.
Inclus dès l'inscription : notre sélection des meilleurs guides & comparatifs IA.
Choisissez votre rythme
Gratuit · Pas de spam · Désabonnement en 1 clic
Paramétrage LoRA : environ 9,3 millions de paramètres au total
La configuration présentée aboutit à un total d’environ 9,3 millions de paramètres d’adaptateurs pour l’ensemble des deux DiT concernés. Des modules de rang 8 sont placés dans les couches d’attention et MLP du DiT dédié à la structure, alors que des modules de rang 16 sont employés dans les couches d’attention du DiT de forme. Le rang détermine la taille des matrices d’adaptateurs et un rang plus élevé accroît leur capacité d’apprentissage. Avec 188 chaussures issues de 1 030 objets GSO, LoRA est privilégié face à un fine-tuning complet, jugé bien plus coûteux et susceptible d’écraser des acquis utiles du modèle.
Sous le capot : cinq étapes, O-Voxel et transformers sparse
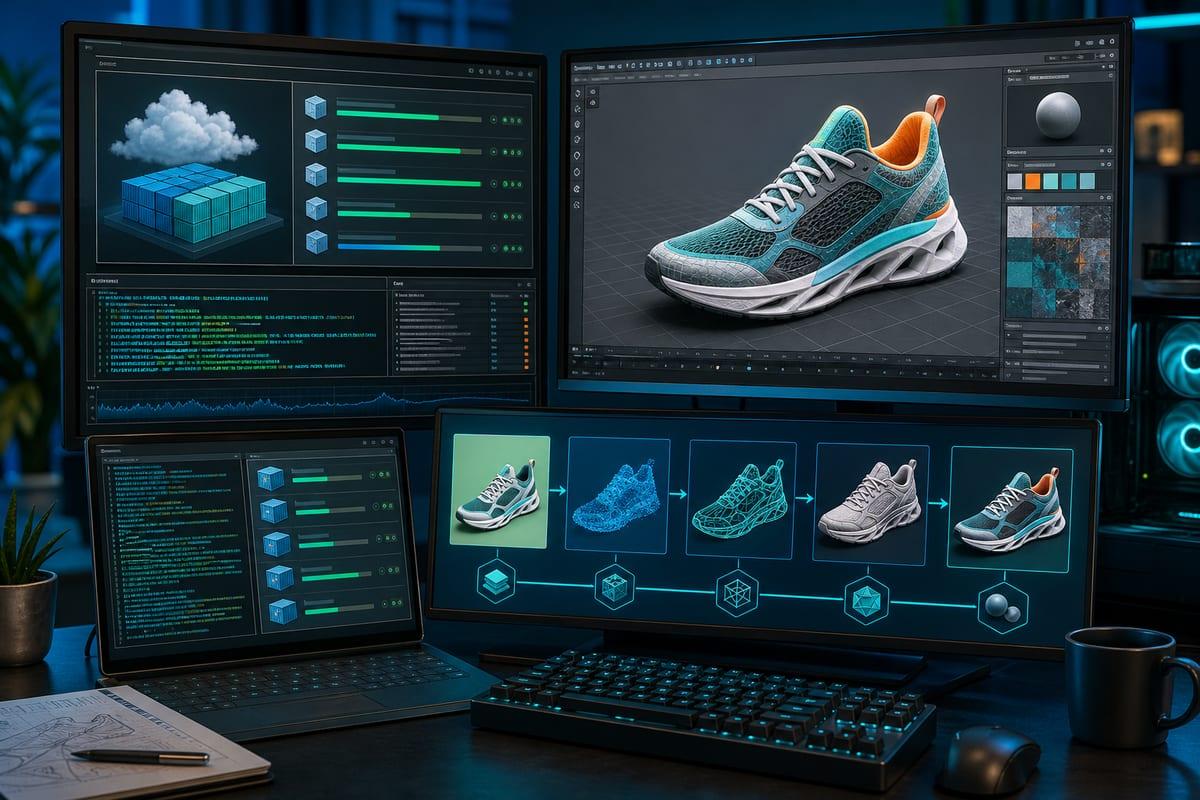
Le pipeline de TRELLIS.2 suit cinq étapes : suppression de l’arrière-plan par BiRefNet, encodage de l’image en tokens par DINOv3-L, prédiction d’une structure grossière, génération de la géométrie détaillée, puis définition des matériaux avant l’export d’un maillage texturé. Le flux de structure génère un latent 16³ × 8, décodé en grille d’occupation 64 × 64 × 64 ; des LoRA y sont ajoutés pour influer sur la géométrie. La représentation O-Voxel retient uniquement les voxels de surface et stocke géométrie locale et attributs de matériau ; un CPU convertit un maillage en O-Voxel en quelques secondes et l’opération inverse s’effectue en quelques secondes sur GPU. Hérités de TRELLIS, les latents structurés sparse n’emploient qu’environ 10 % des voxels, et les flux de forme et de texture s’appuient sur des transformers sparse, quand le flux de structure est dense. La géométrie O-Voxel est produite à une résolution de 512 × 512 × 512 ; des LoRA sont également ajoutés au DiT de forme. Les matériaux sont ensuite définis et décodés en cartes de couleur de base, métallique, rugosité et alpha, sans LoRA à cette étape, avant d’exporter un GLB. TRELLIS.2 s’inscrit dans la lignée de TRELLIS, qui introduit une représentation latente unifiée convertie par des décodeurs, évitant des modèles par format. L’objectif affiché est d’améliorer la performance sur une catégorie d’objets précise en affinant uniquement les composants pertinents.
Les scripts fonctionnent sur GPU local ou via Hugging Face Jobs
Les charges s’exécutent sur Hugging Face Jobs, utilisé pour le prétraitement et l’entraînement, ou via Docker sur un GPU local. Un jeton HF_TOKEN est nécessaire et l’accès au modèle restreint DINOv3 doit être accordé au compte. Les jeux de données personnels doivent être poussés au Hub avant de démarrer. Deux images Docker embarquent les dépendances pour éviter des installations longues, respectivement pour le prétraitement et le fine-tuning. Sur Jobs, le jeton est transmis comme variable chiffrée sans être écrit dans l’image ; l’URI cr.hf.co/...:latest désigne l’image, suivi de la commande exécutée. D’autres arguments sont pris en charge, y compris en exécution locale. La démarche type comporte trois volets : convertir des maillages GLB ou OBJ et rendre les images d’entrée, lancer un entraînement par DiT avec configuration LoRA, puis s’appuyer sur le code conteneurisé pour charger les données, insérer les adaptateurs et entraîner les modèles.