La recherche en IA te passionne ?
Les papers et avancées qui comptent, expliqués simplement, chaque soir. Gratuit.
Inclus dès l'inscription : notre sélection des meilleurs guides & comparatifs IA.
Choisis ton rythme
Gratuit · Pas de spam · Désabonnement en 1 clic
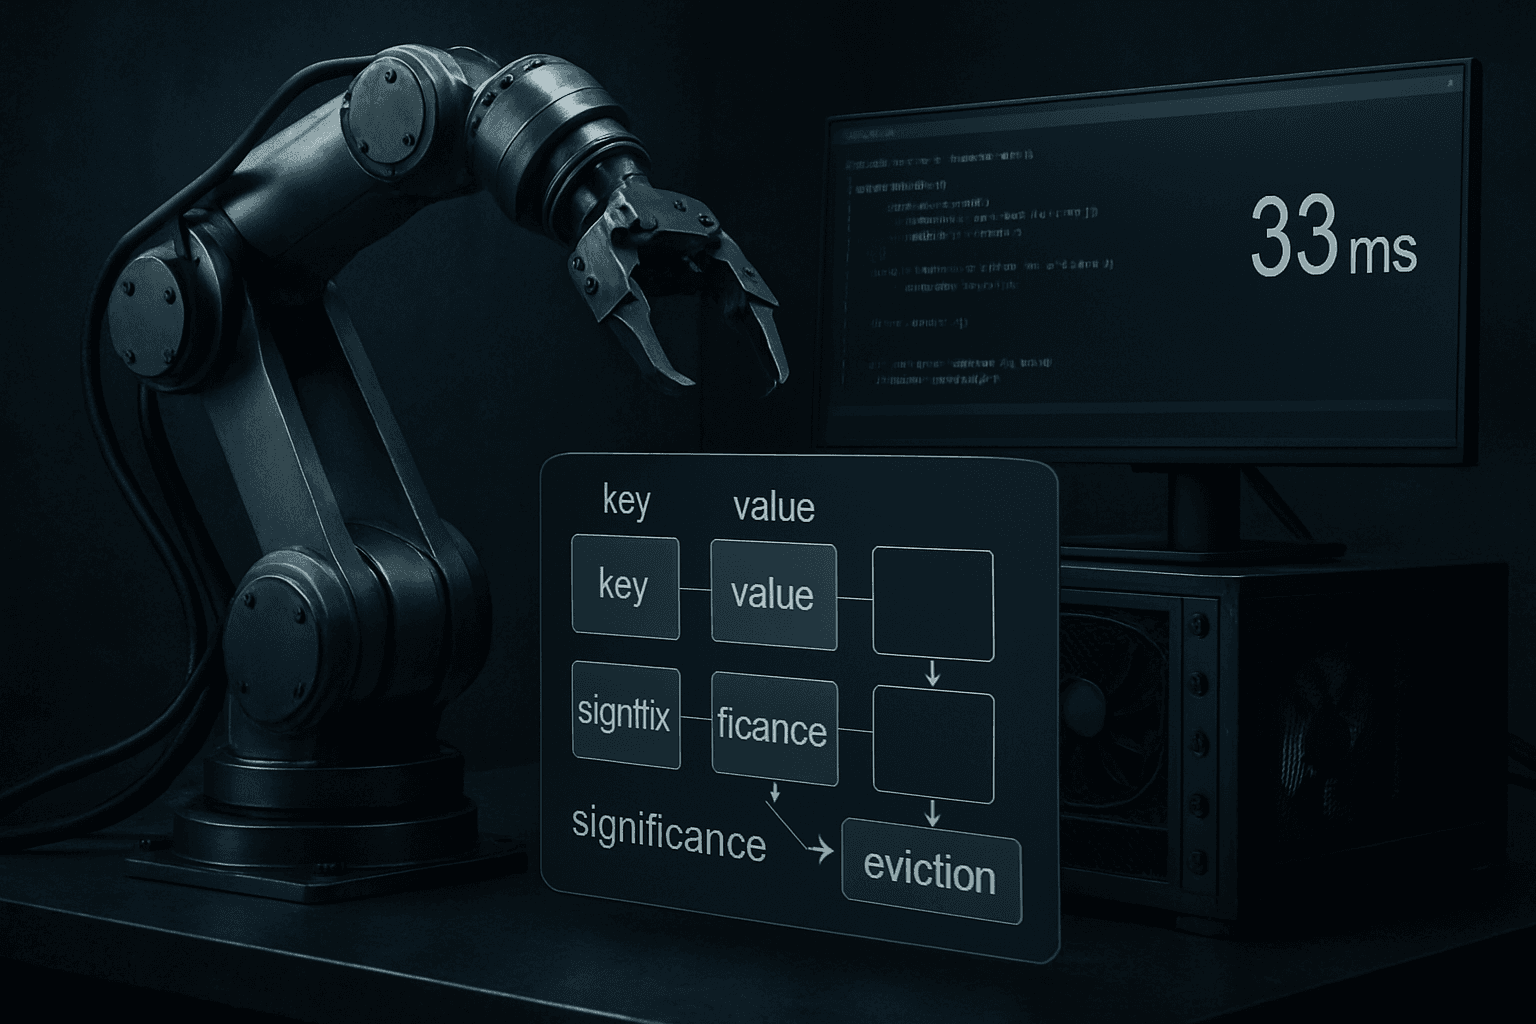
Un moteur d'inférence pour modèle de langage fonctionne selon des principes de temps réel. Il privilégie le refus d'admission afin de ne pas dépasser un cycle de contrôle robotique de 33 ms, procède à l'éviction de son cache KV en fonction de la signification, et repose sur un code CUDA développé manuellement, sans recourir à cuBLAS ni à libtorch. La majorité des solutions d'inférence pour LLM ne prennent pas en compte la notion d'échéance physique.
CUDA fait main et gestion du cache par signification
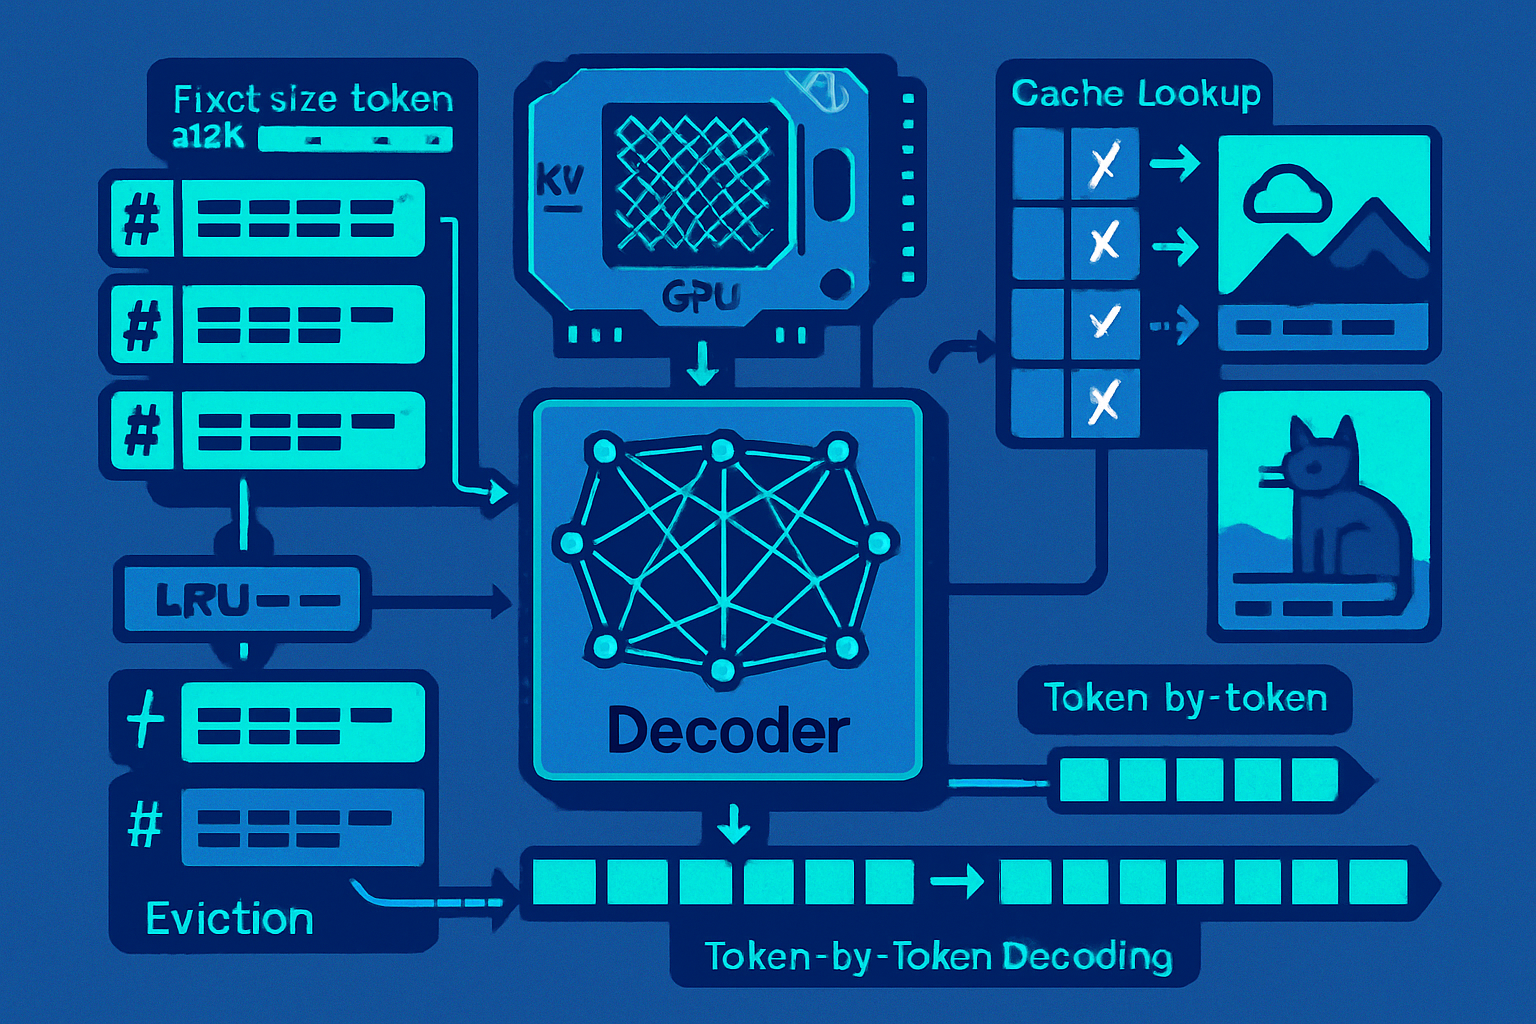
Le runtime est entièrement écrit en CUDA fait main, sans recourir à cuBLAS ni à libtorch. Il utilise un cache KV dont l'éviction se fait selon la signification des entrées, et non leur ancienneté.
Refus d'admission pour respecter le cycle robotique de 33 ms
Ce moteur d'exécution choisit de refuser l'admission plutôt que de courir le risque de dépasser un cycle de contrôle robotique de 33 ms. Cette méthode se distingue de la plupart des moteurs d'inférence pour modèles de langage de grande taille (LLM), qui ne prennent pas en compte de contrainte d'échéance physique.