La recherche en IA te passionne ?
Les papers et avancées qui comptent, expliqués simplement, chaque soir. Gratuit.
Inclus dès l'inscription : notre sélection des meilleurs guides & comparatifs IA.
Choisis ton rythme
Gratuit · Pas de spam · Désabonnement en 1 clic
Une équipe de Cambridge et Google DeepMind propose XConf, une estimation de confiance qui s’appuie sur les performances passées plutôt que sur l’instant présent. Les auteurs rapportent des gains nets de calibration et d’aide à la décision d’automatiser, sans accès aux logits ni entraînement, avec une exigence forte : des étiquettes externes fiables.
Des gains chiffrés sur la calibration et les décisions d’automatiser
Face à l’auto-consistance sur dix échantillons, XConf cumule 21 victoires, 2 égalités et 1 perte à un dixième du coût de génération. Les auteurs rapportent une erreur de calibration inférieure dans tous les cas, de trois à huit fois plus faible sur MMLU-Pro. Les gains sont particulièrement marqués pour les agents, où des trajectoires échouées peuvent paraître propres : sur AppWorld, la confiance verbalisée affiche en moyenne 0,72 d’AUROC, quand l’expérience récupérée atteint 0,86. Sur SWE-bench Verified, XConf dépasse un vérificateur entraîné. Pour piloter l’automatisation, s’abstenir sur les 10 % de cas estimés les moins confiants augmente la précision livrée de 4,8 points en moyenne, jusqu’à 8,7 points sur AppWorld. Le décile le plus confiant est correct 98 % du temps, contre 90 % pour la confiance verbalisée et 87 % pour l’auto-consistance, tandis que le cinquième le moins confiant concentre la moitié des erreurs. À difficulté de question contrôlée, l’AUROC reste à 0,79. Avec Claude sur AppWorld, l’AUROC progresse de 0,63 à 0,81 à mesure que la banque grandit, et sur le raisonnement quelques centaines d’épisodes suffisent à égaler l’auto-consistance là où la confiance verbalisée est faible. Dans 23 comparaisons sur 24, une seule génération avec XConf égalise ou dépasse dix échantillons d’auto-consistance, avec une calibration bien mieux tenue.
Une contrainte déterminante : des étiquettes externes et une banque d’épisodes
Le dispositif repose sur des étiquettes de vérité fournies en dehors du modèle. Les auteurs signalent qu’avec des auto-étiquettes produites par le LLM, la méthode se dégrade. Quand la banque est clairsemée, la composante empirique se détend vers le taux de base correspondant au niveau de confiance déclaré, ce qui évite les ruptures brutales. À l’inverse, plus la banque grandit, plus la calibration s’améliore, comme illustré par la progression d’AUROC de 0,63 à 0,81 sur AppWorld avec Claude. Sur des tâches de raisonnement, quelques centaines d’épisodes suffisent déjà pour rejoindre l’auto-consistance là où la confiance verbalisée reste faible.
Comment XConf produit sa probabilité de réussite
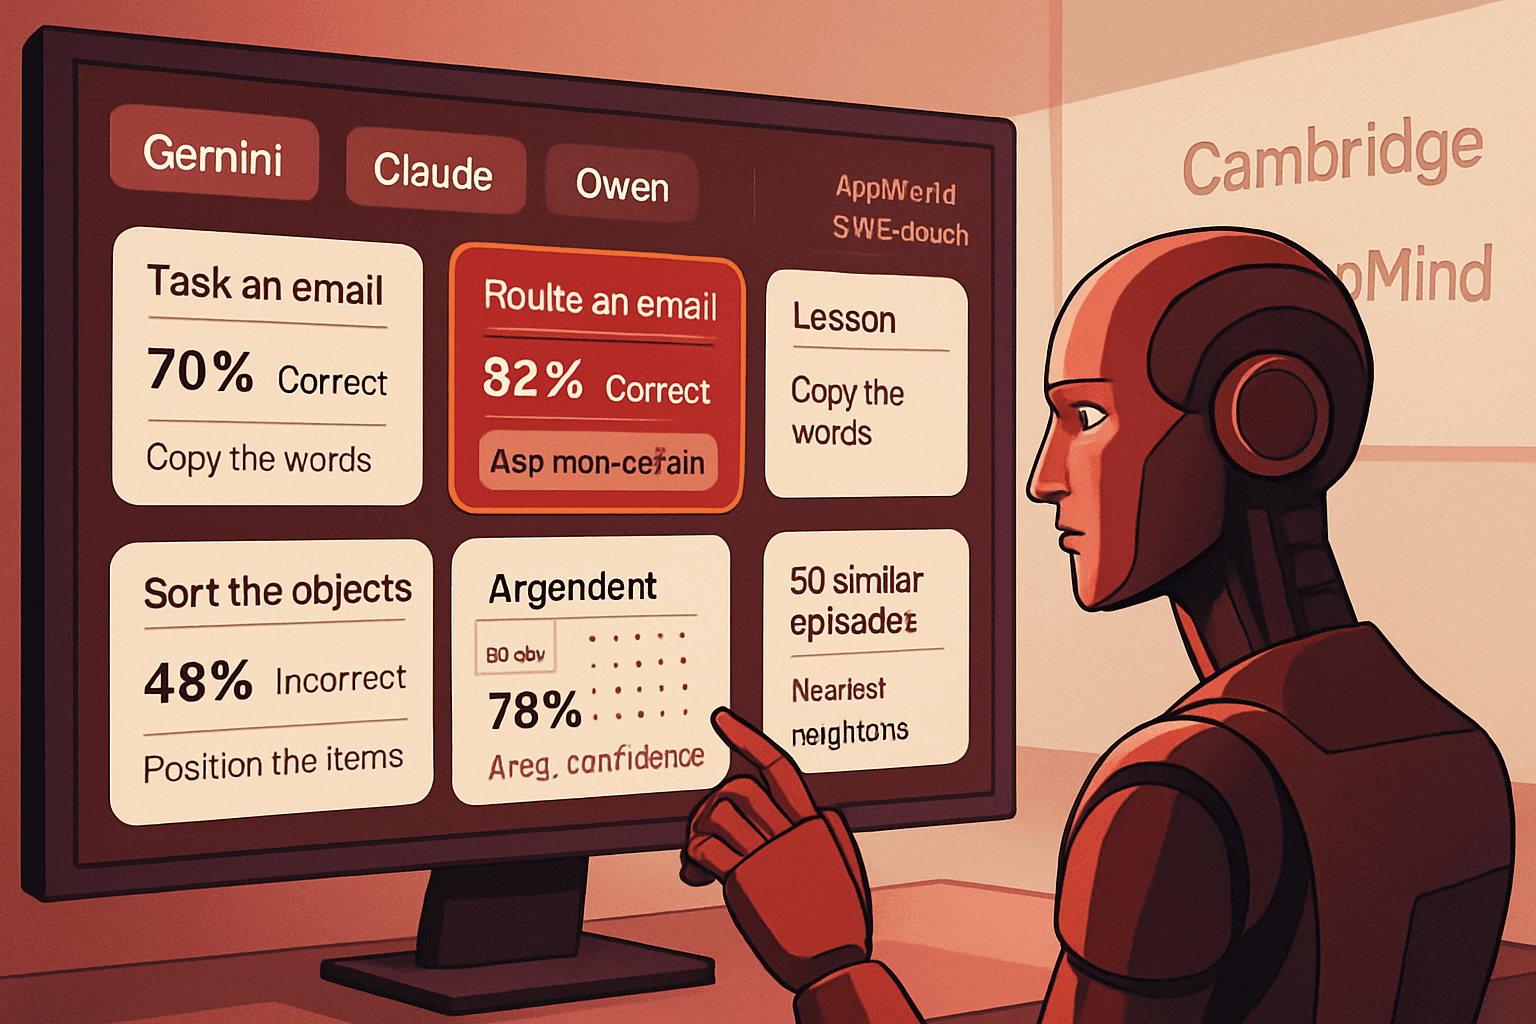
Chaque interaction réussie ou non est archivée comme un épisode contenant la tâche, une réflexion préalable du modèle, la confiance déclarée, le verdict correct ou incorrect et une leçon tirée après coup. La leçon est mise en quarantaine pour éviter un biais de connaissance du résultat lors d’évaluations ultérieures. Pour une nouvelle tâche, XConf forme une requête combinant l’embedding de la tâche et le niveau de confiance déclaré, puis récupère les 50 voisins les plus proches. La fraction de voisins réussis constitue une première lecture. Retirer la confiance de cette clé fait chuter l’AUROC de 0,08 sur le raisonnement et de 0,12 sur les agents. La similarité est apprise dans un espace redimensionné à partir des résultats notés pour rapprocher les épisodes qui échouent pour des raisons semblables. Les voisins sont présentés au modèle sous forme de cartes contenant tâche, confiance, résultat et leçon ; le modèle identifie un motif d’échec et reformule sa confiance. La probabilité finale est la moyenne simple entre cette réflexion et la lecture empirique. Le procédé est agnostique au format de sortie, qu’il s’agisse de QCM, de code étendu ou de trajectoires d’agents.
XConf exploite l’historique pour affiner le classement des e-mails
Dans un système de routage d’e-mails d’assurance, une demande contenant « arrêter de payer » est d’abord classée vers Paiements avec une haute confiance par le LLM. XConf consulte l’historique de cas similaires assortis du même niveau de confiance et constate que seuls 4 sur 10 sont effectivement restés en Paiements, les autres relevant d’Annulations ; le rappel est de 0,40 et la réflexion réduit encore la confiance sous le seuil d’automatisation. L’e-mail part alors en révision humaine. À l’inverse, une question de virement bancaire, également évaluée comme Paiements avec haute confiance, s’accompagne d’un historique montrant 48 corrects sur 50 et peut être traitée automatiquement. Aucun ajout de règle n’est requis : le système s’appuie sur l’issue réellement observée des précédents.
Périmètre des tests et modèles couverts
L’analyse concerne neuf benchmarks qui englobent le choix multiple, le raisonnement complexe, les olympiades de mathématiques, la génération de code, les questions multimodales ainsi que trois types d’environnements d’agents. Quatre modèles issus de trois familles différentes sont évalués : Gemini 2.5 Flash, Gemini 3.5 Flash, Claude Sonnet 4.6 et Qwen3.5–397B. Le protocole emploie une rotation à cinq volets pour s’assurer qu’aucune tâche n’apparaît à la fois dans la banque et dans l’estimation, et un scénario de croissance chronologique de la banque pour refléter l’usage en production. Les résultats cités incluent notamment AppWorld et SWE-bench Verified.
Positionnement face aux approches de calibration classiques
Les approches usuelles, qu’il s’agisse de confiance verbalisée, de probabilités de tokens ou d’auto-consistance, opèrent sur l’instant et peuvent se laisser abuser par des erreurs systématiques du modèle. Les calibrations dites classiques, comme le Platt scaling, l’histogram binning ou l’isotonic regression, estiment elles aussi des fréquences historiques, mais au niveau d’un score. XConf s’en distingue par le conditionnement conjoint sur la similarité de tâche et sur le niveau de confiance déclaré, et par une mise en œuvre qui n’exige ni accès aux logits ni entraînement. La méthode s’applique uniformément à des productions hétérogènes, du QCM aux agents.