Créativité des agents LLM : GPT-5 juge mieux que les embeddings
Le brief IA que les pros lisent chaque soir
Les 7 actus IA du jour, décryptées en 5 min. Gratuit.
Inclus dès l'inscription : notre sélection des meilleurs guides & comparatifs IA.
Choisis ton rythme
Gratuit · Pas de spam · Désabonnement en 1 clic
Des chercheurs ont mis à l’épreuve la créativité d’agents LLM sur MLE-bench, en utilisant des centaines de solutions Kaggle comme référence. Elle montre que l’évaluation par GPT-5 s’aligne le mieux avec des annotateurs humains et que les agents glissent vite de l’exploration vers l’exploitation. Le protocole détaille comment P- et H-creativity, impact et faisabilité sont quantifiés.
Un juge LLM concorde significativement avec l’humain
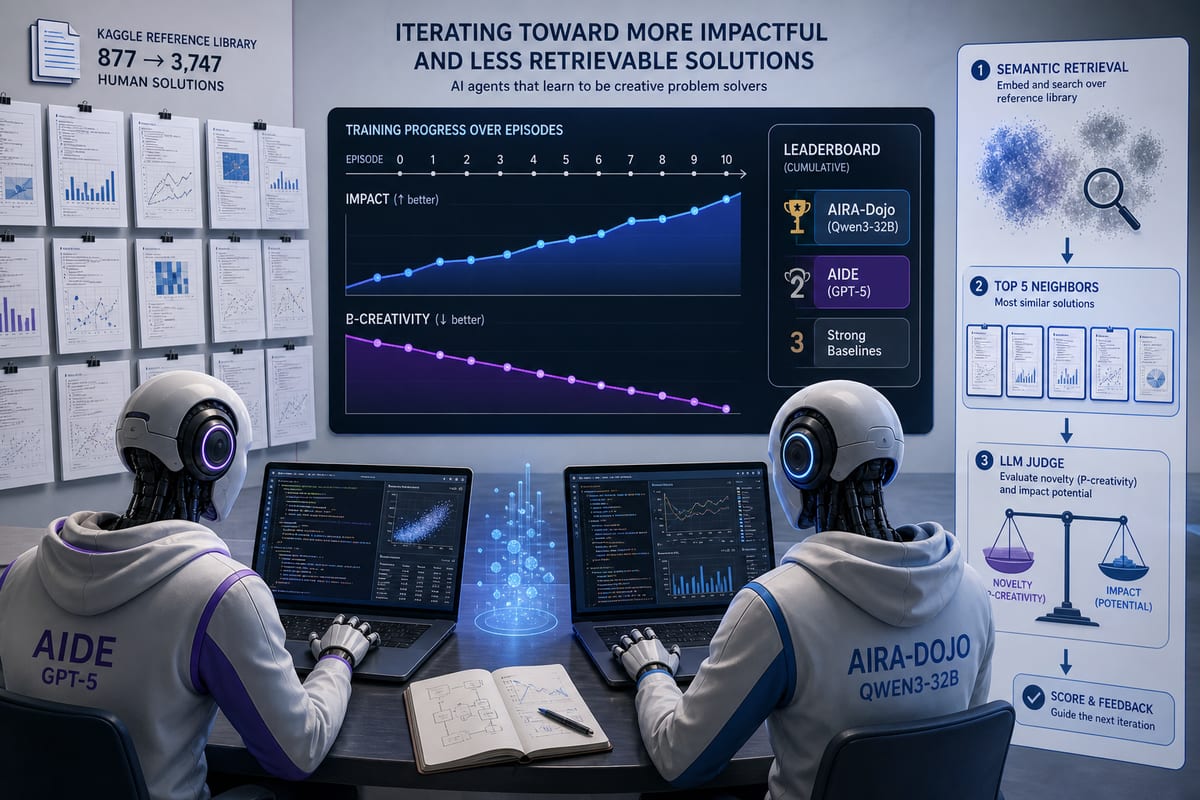
Trois annotateurs humains ont noté 300 épisodes pour la P-creativity, servant de référence à des méthodes automatisées. Les corrélations de Spearman entre ces méthodes et les jugements humains sont toutes significatives (p < 0.001). L’approche LLM-as-a-judge avec GPT-5 atteint le meilleur accord, devant les mesures fondées sur des embeddings. La distance sémantique reste performante, mais les écarts entre modèles utilisés comme juges soulignent un besoin de meilleures capacités de raisonnement pour évaluer la nouveauté. Pour la H-creativity, la taille des corpus humains impose une stratégie en deux temps : récupérer 5 voisins proches par distance sémantique, puis solliciter le jugement du LLM sur ces 5 références.
Des agents qui améliorent l’impact mais perdent en P-creativity
Sur les épisodes successifs, tous les agents augmentent leur impact. AIDE avec GPT-5 progresse de manière régulière, tandis qu’AIRA-MCTS avec Qwen démarre plus haut mais atteint un plateau. La P-creativity recule de façon générale au fil des épisodes, avec des niveaux systématiquement plus bas pour AIRA-MCTS avec Qwen. Le suivi débute à l’épisode 1, l’épisode 0 faisant office de référence. À mesure que le temps de test croît, les agents passent de l’exploration de pistes nouvelles à l’affinement d’un chemin choisi. Cette bascule existe aussi chez les humains, mais les agents y arrivent plus vite et voient leur P-creativity décroître plus rapidement.
Comment la créativité est définie et décomposée
La créativité est posée comme la production d’idées ou de produits à la fois originaux et utiles. Des travaux fondateurs la relient à l’exploration d’espaces conceptuels structurés et à la capacité de cibler une portion pertinente d’un vaste espace de résolution de problèmes. L’originalité est scindée entre P-Creativity, relative à la mémoire et à l’historique d’un programme, et H-Creativity, appréciée par rapport au corpus de connaissances humaines. L’utilité est découpée en impact et en faisabilité. L’ensemble forme le socle d’analyse : P-Creativity, H-Creativity, impact et faisabilité.
Des métriques opérationnelles pour P-, H-creativity, impact et faisabilité
La P-Creativity est notée par GPT-5 sur une échelle de 0 à 4, ancrée entre des pôles « Routine » et « Transformationnel ». La H-Creativity s’appuie sur une récupération par proximité sémantique, suivie d’un jugement par GPT-5 en se comparant à des corpus de 877 à 3,747 notebooks par tâche. L’impact est défini par un score normalisé reflétant la distance entre une ligne de base et la meilleure performance humaine. La faisabilité n’est pas un score explicite : un épisode n’est retenu que si son code s’exécute correctement. La notion d’épisode correspond à un ensemble d’étapes menant à une soumission réussie.
Un cas concret : cassava, entre idées neuves et répétition
Sur la classification d’images de maladies des feuilles de cassava, cinq épisodes consécutifs d’un run AIDE propulsé par GPT-5 ont été observés. L’agent commence par un classificateur de crête à l’épisode 0, auquel est attribuée par convention une P-creativity de 4, faute d’historique. La H-creativity et l’impact culminent lorsqu’il exploite LightGBM avec des caractéristiques conçues manuellement, alors que des concurrents humains auraient dès le début privilégié des CNN. Dans ce contexte, LightGBM ressort comme novateur face à 3,747 approches humaines. Après l’épisode 4, l’agent réitère la même voie, privilégiant l’exploitation, et termine loin d’une médaille.
Une évaluation à l’échelle de MLE-bench et des trajectoires humaines
Dix tâches de MLE-bench couvrant l’image, le NLP et les données tabulaires ont été sélectionnées pour leurs corpus humains denses, comprenant de 877 à 3 747 notebooks publics. Deux agents sont pris en compte : AIDE, basé sur une recherche d’arbre avide, et AIRA-Dojo, qui intègre à ce dernier des stratégies et opérateurs supplémentaires, en utilisant GPT-5 et Qwen3-32B comme modèles sous-jacents. Huit exécutions sont réalisées pour chaque agent et chaque combinaison modèle–tâche, avec une limite de 8 heures et un maximum de 10 épisodes. L’intérêt de MLE-bench est d’offrir des trajectoires humaines, permettant de suivre l’évolution de l’impact et de la P-creativity au long de compétitions et de comparer directement ces dynamiques à celles des agents.
L’étude analyse l’écart entre annonces et résultats des agents LLM
Le travail, publié à COLM 2026 et coécrit avec des chercheurs de l’Université du Michigan, répond au décalage entre annonces de percées et performances réelles d’agents LLM sur des défis de recherche en apprentissage automatique. Tandis que des projets comme AlphaEvolve ou Kosmos sont cités et qu’OpenAI affirme avoir résolu les équations de Navier–Stokes, les meilleurs humains gardent l’avantage sur des problèmes concrets. Une hypothèse avancée tient au rôle du cadre et de l’échafaudage fournis aux agents. Les auteurs proposent la créativité comme clé d’analyse et posent la question de l’attribution des écarts de performance à la structuration de la recherche créative. Les tâches ML offrent le terrain adapté pour étudier, LLM fixe à l’appui, comment des cadres guident l’émergence d’idées nouvelles et utiles et si des métriques de créativité peuvent expliquer pourquoi certains cadres ou modèles surclassent d’autres.
Brief IA — L'actualité IA en français
L'essentiel de l'actualité de l'intelligence artificielle, décrypté et expliqué chaque jour.