IA au travail : deux horloges et le cap des 400 ms
Le brief IA que les pros lisent chaque soir
Les 7 actus IA du jour, décryptées en 5 min. Gratuit.
Inclus dès l'inscription : notre sélection des meilleurs guides & comparatifs IA.
Choisis ton rythme
Gratuit · Pas de spam · Désabonnement en 1 clic
Dans les interfaces d’IA, la mesure qui compte n’est plus seulement le temps de réponse du modèle. Le budget critique se joue à la reconnaissance, sous 400 ms, faute de quoi l’attention décroche et la supervision humaine s’évapore. Des règles concrètes, chiffrées et déjà éprouvées guident la conception de ces interactions.
Quand l’attention décroche, la supervision disparaît
Dans les outils d’IA, le coût d’une réponse lente se traduit en supervision humaine plutôt qu’en simple débit. Le budget de reconnaissance équivaut à un budget de contrôle des sorties : le dépasser revient à interrompre, sans bruit, la vérification par l’utilisateur. Dans les environnements d’entreprise, ces retards s’additionnent avec la file des tâches. Selon des mesures mentionnant 117 emails et 153 messages Teams quotidiens et des interruptions toutes les deux minutes, une seconde perdue à chaque reconnaissance peut totaliser quatre minutes de clics sans réponse sur 270 occasions. Dans un chat loisir, l’utilisateur tolère un tour lent ; au travail, la file multiplie l’effet. À force, les utilisateurs reviennent pour accepter la sortie plutôt que la vérifier, ce qui retire l’humain de la boucle. La latence renchérit la supervision, transforme un outil collaboratif en tâche de fond et finit par redessiner le produit, jusqu’à exiger des surfaces dédiées comme des notifications et un historique d’exécution.
Ce que mesurait Doherty et pourquoi 400 ms tiennent toujours
Dès 1982, Walter Doherty et Ahrvind Thadani ont relié transactions par heure et réactivité : sous environ 400 millisecondes, la productivité grimpe plus que ne l’explique le temps économisé car l’opérateur maintient sa pensée au lieu de reconstruire le contexte. Le seuil ne dit rien de la vitesse de calcul, il dit combien de temps une pensée tient. Sous 400 ms, les pauses ne cassent pas le fil ; au‑delà, les erreurs augmentent. D’autres mesures contemporaines pointent la même direction. Deloitte Digital a observé qu’un gain de 0,1 seconde augmentait de 8,4 % les conversions sur 37 marques. À l’échelle conversationnelle et à travers dix langues, l’écart médian entre tours est d’environ 100 ms. Sur le web, Jakob Nielsen a formalisé trois bornes : 0,1 s paraît instantané, 1 s préserve le flux, 10 s marque la limite d’attention.
Deux horloges à piloter : reconnaissance et réponse finale
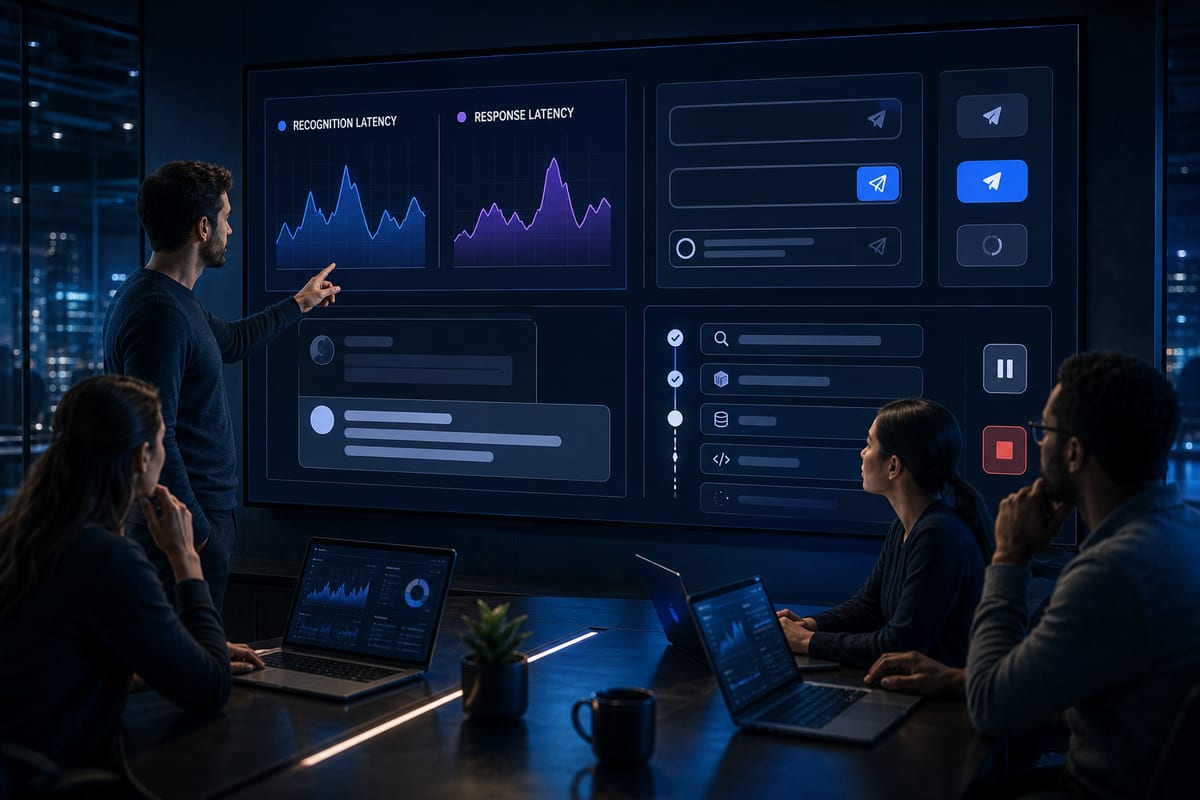
Chaque interaction d’IA obéit à deux horloges. La première démarre au geste de l’utilisateur et s’arrête quand l’interface prouve qu’elle a entendu : écho de l’entrée, changement d’état du bouton, squelette de réponse. Il faut viser 100 ms et considérer 400 ms comme plafond. La seconde va de l’envoi jusqu’à une réponse utilisable ; elle peut durer si l’attente achète un résultat de valeur. Ce qui brise l’échange, c’est l’absence de reçu et de progrès, pas la durée. Les principes de retour d’information énoncés par Ben Shneiderman — état réel, annulation permanente, correction des actions optimistes — restent valides. Or, beaucoup d’équipes n’instrumentent que l’horloge deux portée par les métriques de modèles, laissant la première sans propriétaire. C’est ainsi qu’un p95 flatteur coexiste avec une interface inerte au premier tap. Documenter les deux objectifs et leurs responsables clôt le débat sur la lenteur.
Mesures de terrain : seuil Google et échos sous 50 ms
Des repères opérationnels existent côté interface. Google considère « bon » un délai interaction‑à‑prochaine‑peinture de 200 ms ou moins au 75e percentile des visites, indépendamment de la durée d’inférence qui suivra. Dans la plupart des contextes, une interface peut émettre un accusé de réception en 50 ms, même sur un appareil modeste. Cet accusé peut prendre la forme d’un écho de l’invite dans le fil, d’un changement d’état du bouton ou d’un squelette à l’emplacement prévu de la réponse.
Le faux remède du streaming et ses angles morts
Le streaming rend une longue réponse plus facilement lisible en flux, mais il ne traite pas le vide avant le premier jeton. Luke Wroblewski alertait dès 2013 sur l’effet du délai initial sans retour. Avec des étapes de raisonnement ou de récupération, ce temps peut s’allonger alors que l’interface reste inchangée. Pire, afficher un mouvement ou une progression fictive pour acheter de la patience se retourne contre l’expérience. Les utilisateurs peuvent excuser la lenteur, mais pas une attente gérée de manière trompeuse.
Les agents ajoutent de la latence à chaque phase de traitement
Les agents enchaînent appels de modèles, d’outils et relances, accumulant la dette de latence à chaque étape. Dans un scénario de révision de contrat — extraire, comparer, signaler, rédiger — chaque phase dure quelques secondes sans paraître alarmante isolément. Beaucoup d’interfaces n’affichent qu’un seul indicateur global, masquant les erreurs survenues à mi‑parcours que l’utilisateur ne découvre qu’à la fin. La recommandation documentée consiste à montrer le travail de l’agent étape par étape et à permettre l’arrêt. En pratique, les utilisateurs lancent l’exécution, passent sur Slack, puis reviennent plus tard — comme à l’époque des mainframes. À ce moment‑là, ils valident plus qu’ils ne contrôlent.
Arrêter d’accuser l’inférence et fixer des budgets
Imputer la lenteur au seul temps d’inférence — huit secondes n’étant pas rare — occulte la responsabilité de l’interface. L’IA générative a scindé l’événement d’interaction en reconnaissance et réponse ; le seuil de 400 ms s’applique au premier. Des métriques comme le temps au premier jeton incluent la réflexion du modèle, mais ne peuvent servir de substitut à une mesure de reconnaissance côté surface. Concevoir sur cette base fait confondre mesure du modèle et mesure d’interface. Le modèle peut prendre son temps pour produire la réponse ; la première demi‑seconde, elle, doit prouver qu’il a entendu.
Brief IA — L'actualité IA en français
L'essentiel de l'actualité de l'intelligence artificielle, décrypté et expliqué chaque jour.