Tokens d’IA : unité de contexte, de coût et de calcul
Le brief IA que les pros lisent chaque soir
Les 7 actus IA du jour, décryptées en 5 min. Gratuit.
Inclus dès l'inscription : notre sélection des meilleurs guides & comparatifs IA.
Choisis ton rythme
Gratuit · Pas de spam · Désabonnement en 1 clic
Dans les modèles de langage, tout passe par les tokens : unités de découpage, repères de capacité et base de facturation. Comprendre comment ils sont comptés et utilisés éclaire les limites des longues conversations, la portée des fenêtres de contexte et le coût réel des requêtes via API.
Quand la fenêtre sature, les échanges anciens sautent
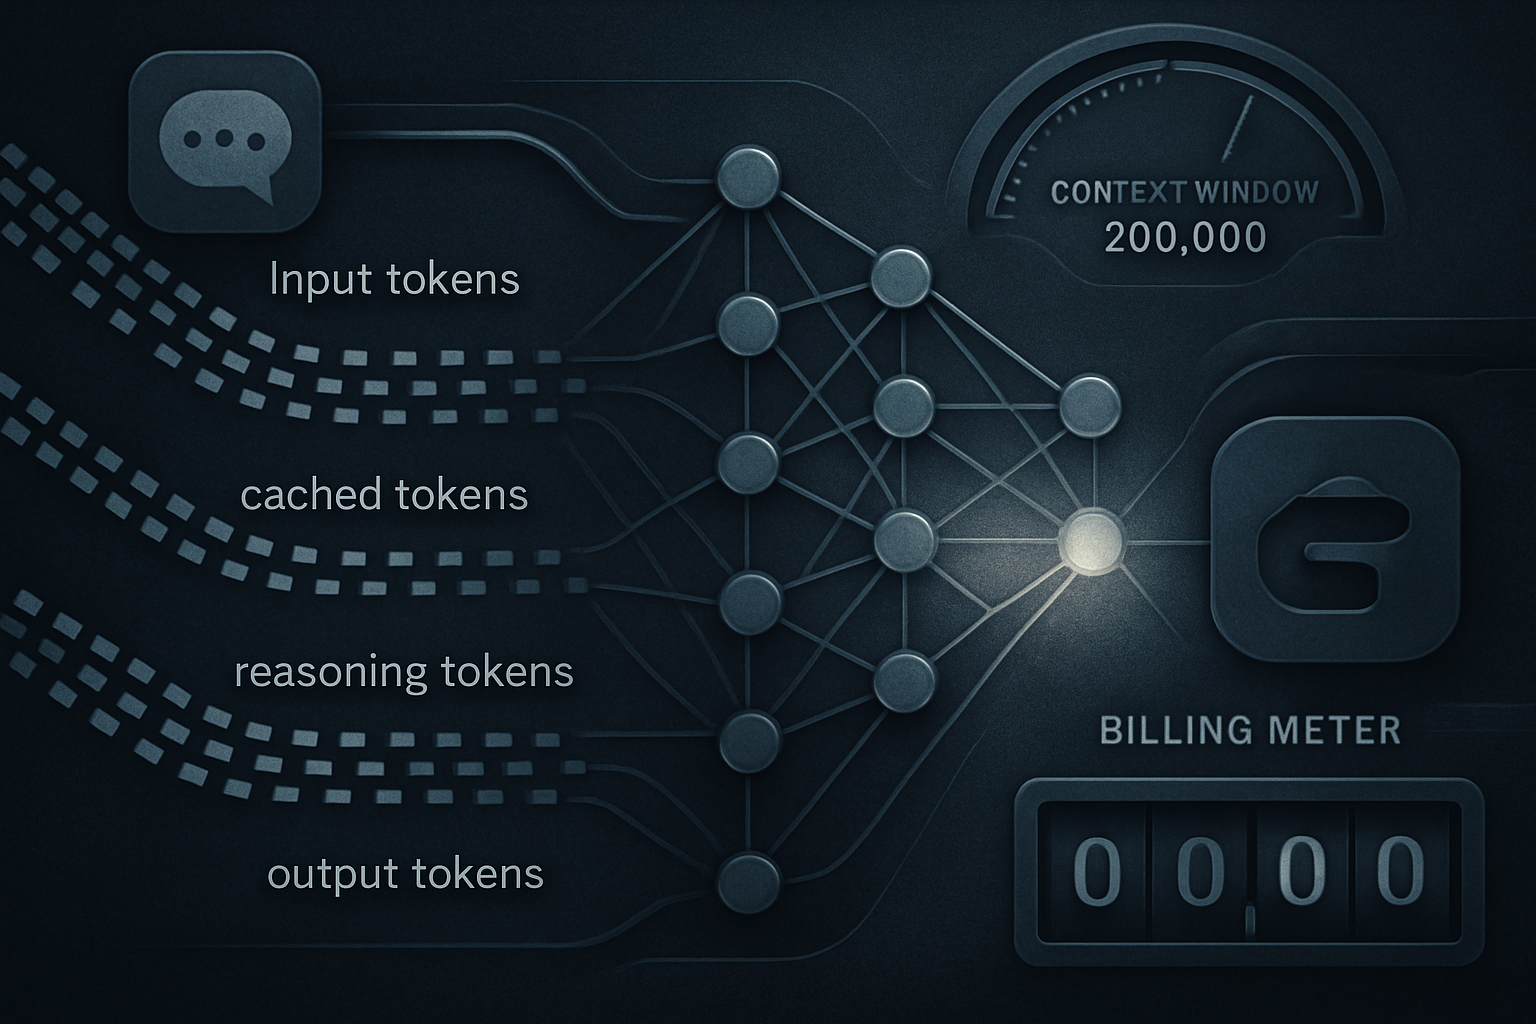
À mesure qu’une conversation s’allonge, elle consomme la fenêtre de contexte dont dispose le modèle. Lorsqu’elle atteint sa capacité maximale, des services peuvent écarter, condenser ou tronquer les messages les plus anciens. Dans ces conditions, une IA peut perdre le fil, oublier une consigne donnée plus tôt ou passer à côté d’un détail auparavant pris en compte. On appelle fenêtre de contexte l’ensemble des éléments que le modèle est capable de prendre en compte en même temps pour traiter une demande, ce volume pouvant atteindre jusqu’à 200 000 tokens lorsque cette limite est mentionnée. Cet espace doit également permettre la génération de la réponse et, selon le modèle, inclure le raisonnement interne.
Un token : la brique qui segmente et alimente le calcul
Le token est l’unité de base qui sert à découper ce que traitent les modèles d’IA générative et à mesurer leur capacité et leur consommation. En texte, un token peut être un mot entier, un segment de mot, un signe de ponctuation ou quelques caractères avec espaces. Les tokens d’entrée regroupent tout ce que le modèle reçoit : prompt, historique, instructions ou documents. Chaque token est associé à un identifiant numérique donnant accès à une représentation mathématique, à partir de laquelle le modèle calcule probabilistiquement la suite et génère pas à pas les tokens de sortie, ensuite reconvertis en texte. Cette capacité résulte de l’entraînement sur de grandes quantités de données, et un token ne porte pas une quantité fixe d’information : sa signification dépend du contexte.
La tokenisation varie selon les modèles et les langues
Le découpage n’est pas universel : il dépend du tokenizer propre à chaque modèle ou famille de modèles, si bien qu’une même phrase peut être segmentée différemment. Il n’existe pas d’équivalence générale entre token et mot. Chez OpenAI, Google et Anthropic, l’ordre de grandeur évoqué est d’environ quatre caractères par token en anglais, et la langue influe sur le découpage. Un terme long et fréquent peut tenir en peu de tokens, quand un mot court mais rare peut en demander davantage. Les tokenizers s’appuient sur un vocabulaire fini privilégiant les séquences fréquentes — des terminaisons comme « ing » en anglais peuvent constituer des unités. Travailler avec des mots entiers ferait exploser la taille du vocabulaire, tandis que travailler caractère par caractère produirait des séquences trop longues. La tokenisation est un compromis entre ces deux extrêmes.
Entrées, sorties, cache et raisonnement : des comptes partiels
Au-delà des tokens d’entrée et de sortie, certains systèmes réutilisent des tokens mis en cache lorsque des portions de contexte reviennent à l’identique, évitant de tout recalculer. Par ailleurs, des modèles mobilisent des tokens de raisonnement durant des étapes intermédiaires qui ne figurent pas forcément dans la réponse affichée. Une courte réponse peut ainsi avoir consommé davantage de tokens que ne le laisse voir son texte final. De fait, l’utilisateur ne perçoit qu’une partie du volume réel de tokens impliqués dans un échange.
Contexte n’est pas mémoire, même à 200 000 tokens
La fenêtre de contexte concerne uniquement les informations accessibles pour traiter la requête en cours et ne doit pas être confondue avec une mémoire persistant au-delà d’une conversation. Disposer d’une fenêtre de 200 000 tokens ne signifie pas que le système se souvient durablement de 200 000 tokens d’échanges. Une fenêtre plus large autorise le traitement simultané d’un plus grand volume d’informations, mais elle ne garantit ni une exploitation aussi précise de chaque élément, ni une meilleure qualité de réponse.
Avec les API, le token fait la facture
Pour les chatbots destinés au grand public, le prix par interaction n’apparaît pas à l’utilisateur et peut se résumer à une formule d’abonnement mensuel. Lorsqu’il s’agit des API, la tarification de chaque requête dépend du nombre et de la catégorie de tokens : les tokens produits en sortie sont habituellement facturés à un tarif supérieur à ceux transmis en entrée, car le modèle les génère individuellement alors qu’il est capable de traiter une grande partie des entrées de façon simultanée. Ce système de comptage convient à des usages nécessitant davantage de ressources, notamment pour les modèles affichant des fenêtres de contexte particulièrement larges. À titre illustratif, des grilles évoquent deux dollars par million de tokens en entrée et dix dollars par million en sortie. Les modèles couramment cités par les utilisateurs incluent ChatGPT, Claude et Gemini.
Brief IA — L'actualité IA en français
L'essentiel de l'actualité de l'intelligence artificielle, décrypté et expliqué chaque jour.