Vers des labos IA : DeepMind esquisse un marché, premiers scores
Le brief IA que les pros lisent chaque soir
Les 7 actus IA du jour, décryptées en 5 min. Gratuit.
Inclus dès l'inscription : notre sélection des meilleurs guides & comparatifs IA.
Choisis ton rythme
Gratuit · Pas de spam · Désabonnement en 1 clic
Des chercheurs de DeepMind recommandent la création d'un marché où idées et expériences scientifiques seraient associées, avec des règles et paiements à la validation. Dans les laboratoires automatisés, un benchmark récent mesure déjà la part d'exécution réalisable par des modèles et son coût. Google avance en biosécurité avec un marquage dédié aux séquences et structures biologiques. Les stratégies d'essaims et l'opinion publique américaine sur la régulation complètent le tableau.
DeepMind propose un marché pour les expériences et des règles de paiement
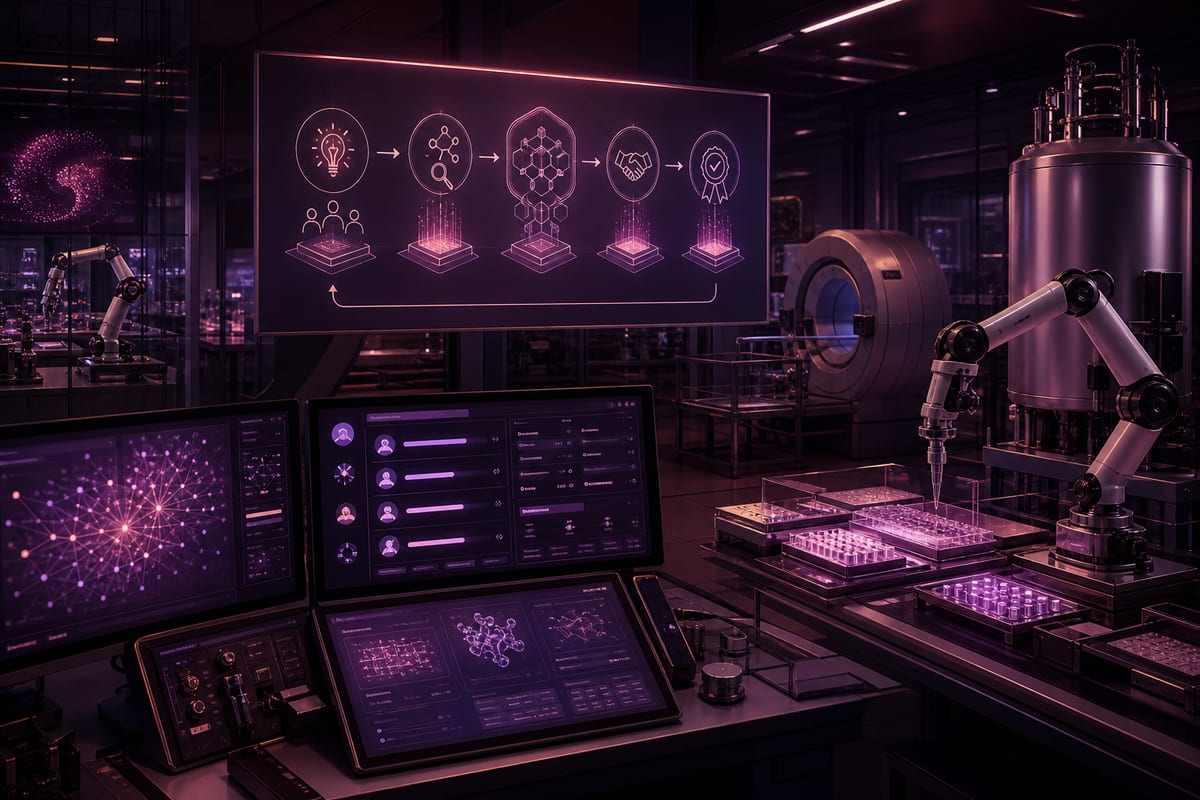
Des chercheurs de DeepMind posent la question de la gestion d'un monde où le nombre de scientifiques augmenterait fortement et préconisent un marché pour proposer et exécuter des expériences, afin de faire coïncider idées et ressources physiques rares. Ils estiment que le développement des scientifiques IA sera surtout limité par les ressources matérielles et la validation empirique, plutôt que par la génération d'idées plausibles. Ils suggèrent la création anticipée d'une économie scientifique automatisée conçue dès l'origine pour ce but. Le marché tel qu'il est présenté s'articule autour de quatre composantes : une étape de preuve d'idéation pour authentifier la provenance avant toute évaluation publique ; une phase d'évaluation ex-ante où différents agents formulent des prévisions et misent des crédits ou des jetons de calcul ; un système de courtage avec licenciement fractionné pour mettre en relation les générateurs d'idées et ceux qui les réalisent ; et enfin, un paiement lié à la validation, qui entraîne le versement de redevances si la proposition est effectivement vérifiée dans le monde réel. Il est aussi indiqué que si l'IA parvient à accélérer de façon tangible le travail des scientifiques humains, il faudra s'attendre à une augmentation de la demande dans toute la chaîne d'approvisionnement scientifique.
Laboratoires automatisés : 92 tâches testées et des performances chiffrées
C5R Corp cherche à mesurer jusqu'où des systèmes d'IA peuvent opérer des laboratoires automatisés, de la fabrication de molécules aux rayons X en passant par le pressage de granulés de pilules. Son benchmark SciUniverse comprend 92 tâches réparties sur 17 familles, incluant la préparation d'échantillons, le contrôle d'instruments, l'adaptation de protocoles, l'apprentissage au fil des expériences, la gestion d'installations et l'interprétation de mesures réelles. Les exemples couvrent la chimie (assigner des structures à partir de la RMN), la biologie (exprimer sfGFP dans un système sans cellules) et la science des matériaux (presser des granulés de BaTiO3). Côté résultats, Claude Fable 5.1 (xhigh) affiche 45,3 % de réussite pour 40,61 $ par tâche, devant GPT-5 Astra (xhigh) à 32,5 % et 52,37 $, puis Claude Opus 5 (xhigh) à 30,5 % et 46,31 $. Des capacités scientifiques croissantes pourraient se traduire en impact, après des « coups de semonce » évoqués pour 2026 sur la R&D automatisée.
Biosécurité : Google introduit un marquage dédié avec SynthID Bio
Google a développé SynthID Bio, une famille de méthodes de marquage conçues pour la biologie synthétique afin de renforcer la biosécurité et l'intégrité scientifique. La méthode varie en fonction des données : pour les séquences, elle consiste à choisir certains acides aminés, tandis que pour des structures 3D prédites, elle modifie les coordonnées atomiques, ce qui permet d'obtenir un signal de détection fiable. Lors d'expérimentations en laboratoire sur trois cibles — VEGF-A, le domaine RBD de la protéine de pointe du SARS-CoV-2 et PD-L1 — les versions marquées ont montré des performances équivalentes aux versions non marquées en ce qui concerne le taux de réussite, l'affinité de liaison et la diversité des séquences naturelles. Cette solution est décrite comme venant en complément d'autres approches, telles que le suivi des équipements physiques et l'utilisation de classificateurs du côté des fournisseurs d'IA.
Essaims d’agents : gains de temps, rendements décroissants et nouveau paramètre d’échelle
Toby Ord décrit les essaims comme une nouvelle forme d'échelle d'inférence et les juge utiles sous contrainte de temps. Selon lui, par rapport à des agents uniques, les essaims consomment davantage de tokens mais leur parallélisation accélère l'exécution : un essaim de 4 agents requiert environ deux fois plus de tokens au total pour une performance équivalente, tout en divisant par deux la dépense par agent et potentiellement le temps d'exécution. L'augmentation du nombre d'agents s'accompagne toutefois de rendements décroissants, analogues aux difficultés de coordination décrites par les économistes via le paramètre dit « marcher sur les pieds ». Multiplier par 10 le nombre d'agents n'apporte pas autant que 10 fois plus de tokens sur un agent unique ; la performance suit plutôt 10λ, entre 3 et 5 fois dans l'exemple cité, avec un déficit qui s'accumule à grande échelle. Il est avancé que l'échelle par essaims pourrait même augmenter la probabilité d'une explosion d'intelligence. Plus largement, au-delà du calcul et des données pour l'entraînement et des budgets d'inférence optimisés par chaînes de pensée et appels d'outils, les agents ajoutent un nouveau paramètre d'échelle ; de meilleures coordinations pourraient amplifier ces retours.
États-Unis : majorité pour des règles publiques au-delà des engagements volontaires
Un sondage du Center for Shared AI Prosperity indique que l'accord d'auto-régulation annoncé par l'administration Trump avec des entreprises comme Anthropic et OpenAI est jugé « pas suffisant » par 61 % des Américains, sur un échantillon de 2498, dont 53 % des électeurs de Trump. Par ailleurs, 54 % des électeurs estiment que le gouvernement devrait établir et faire respecter des règles pour l'IA, avec 61 % chez les électeurs de Harris et 48 % chez ceux de Trump. Ces résultats sont présentés comme le signe d'une demande populaire pour un encadrement plus strict que la position actuelle observée à Washington, une asymétrie décrite comme instable.
Brief IA — L'actualité IA en français
L'essentiel de l'actualité de l'intelligence artificielle, décrypté et expliqué chaque jour.