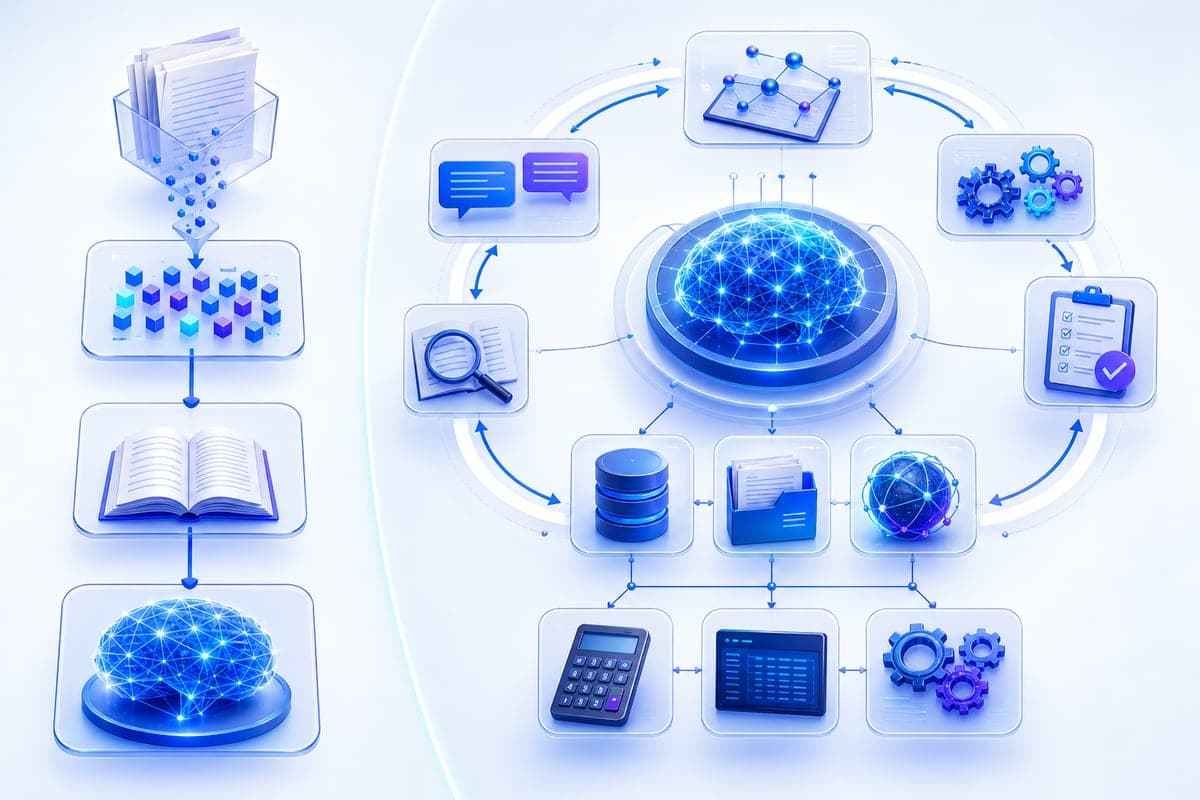
Deux architectures de récupération s’opposent dans les applications à base de modèles de langage : un pipeline linéaire, rapide et économique, et une boucle agentique, plus coûteuse mais adaptée aux requêtes complexes. Le choix dépend d’un arbitrage explicite entre capacité et coût, ainsi que des mécanismes mobilisés pour planifier, décomposer, évaluer et outiller la récupération.
Arbitrer coûts et capacités avant de trancher
La décision entre une récupération linéaire et une récupération agentique s’appuie sur un compromis entre coût et capacité. Un pipeline standard implique une seule intégration de la requête et un appel au modèle, avec une latence faible, des coûts prévisibles et une facilité de débogage. À l’inverse, un système agentique multiplie les étapes de raisonnement, ajoutant de la latence et des coûts en tokens. Une requête pouvant exiger trois itérations de récupération et deux appels d’outils reviendra significativement plus cher qu’un unique passage. Cette réalité économique explique que le RAG standard reste un choix excellent et économique pour de nombreuses applications, notamment quand la rapidité est cruciale et que les requêtes sont bien définies et unidimensionnelles.
Quatre leviers pour rendre la récupération agentique
Quatre mécanismes distincts transforment un pipeline en système agentique. Le routage de requête d’abord : le modèle sélectionne, dans un registre prédéfini, la source ou l’outil adapté avant la recherche, évitant de forcer toute demande à travers un même mécanisme. Une analyse financière peut ainsi passer par une base SQL structurée, une question de politique par une recherche sémantique dans des documents non structurés, et une demande d’actualités par une recherche web en direct. Vient ensuite la décomposition de requête, qui segmente une question complexe en sous-questions indépendantes : déterminer d’abord l’acquéreur d’un service, puis interroger les obligations réglementaires de cet acquéreur dans une zone donnée. Chaque réponse intermédiaire alimente la suivante, constituant un chaînage séquentiel que les pipelines naïfs ne réalisent pas. Troisième levier, l’auto-réflexion : le système évalue si les morceaux récupérés répondent à la question ; en cas d’insuffisance, de contradiction ou de hors-sujet, il réécrit la requête et relance une récupération. Cette boucle continue jusqu’à atteindre un seuil de confiance ou une limite d’itérations, une garde-fou qui évite l’explosion des coûts et de la latence. Enfin, l’utilisation d’outils et d’appels de fonction élargit le champ des possibles : calculatrice pour l’arithmétique, API de recherche en direct, exécuteur SQL ou API internes spécifiques au domaine. Le modèle choisit l’outil approprié pour chaque sous-tâche et peut combiner texte récupéré, calcul, requêtes structurées et données en temps réel dans une même réponse. La nature des outils disponibles conditionne alors ce que le système peut adresser.
Vous suivez la course aux modèles IA ?
Chaque sortie (GPT, Claude, Gemini, Mistral…) décryptée le soir même, en 5 min. Gratuit.
Inclus dès l'inscription : notre sélection des meilleurs guides & comparatifs IA.
Choisissez votre rythme
Gratuit · Pas de spam · Désabonnement en 1 clic
Ce que la boucle agentique change dans le rôle du LLM
Dans un système agentique, le modèle n’est plus un simple générateur recevant un contexte figé. Il devient le moteur de raisonnement qui orchestre la récupération dans une boucle planifier, exécuter, évaluer, répéter. Il décide ce qu’il faut récupérer, où chercher, si les résultats sont satisfaisants et quelles actions entreprendre si ce n’est pas le cas. Là où un pipeline classique expose le modèle à un contexte unique, l’agenticité introduit une réflexion sur la récupération elle-même, y compris la décision d’arrêter quand l’information est jugée suffisante. La récupération cesse d’être une étape de prétraitement pour devenir un processus dynamique, auto-correcteur et itératif.
Pourquoi les pipelines linéaires échouent sur le complexe
La linéarité constitue la faiblesse structurante des pipelines standards. Un seul passage de récupération peut réussir ou échouer sans qu’aucun mécanisme interne ne permette de se rétablir si la requête est mal formulée, si les informations sont dispersées ou si la réponse exige plusieurs étapes de raisonnement. Le pipeline ne sait ni reconnaître un échec de récupération, ni tenter une approche alternative. Lorsque les résultats les plus proches s’avèrent non pertinents, le modèle peut soit ignorer un contexte inadapté au risque d’halluciner, soit signaler qu’il manque d’informations. Dans un cadre d’entreprise à enjeux élevés, ces issues ne sont pas acceptées. Sur une requête composite, une recherche unique sur l’ensemble de la formulation rate souvent la connexion entre morceaux d’information, et le pipeline naïf ne sait pas en faire des sous-questions séquentielles.
Le RAG standard, sa mécanique et ses domaines d’aisance
Le RAG standard s’exécute selon le triptyque récupérer, lire, générer. La requête est traduite en vecteur via un modèle d’embedding, une recherche de similarité sélectionne les k morceaux les plus proches, puis ces éléments sont intégrés à la fenêtre de contexte du modèle de langage qui produit la réponse. Lors de l’ingestion, les données sont segmentées, transformées en embeddings denses, puis stockées dans une base de recherche par voisins approximatifs ; au moment de l’inférence, la requête est vectorisée avec la même méthode d’embedding et les passages correspondants sont extraits. Ce procédé a servi à concevoir des outils de questions-réponses pour les entreprises, des assistants internes de gestion des connaissances ainsi que des solutions de résumé de documents fondées sur des sources contrôlées. Ce fonctionnement demeure pertinent et peu coûteux lorsque la question posée reste basique et que la base de données est bien organisée, mais il atteint rapidement ses limites si plusieurs étapes doivent être enchaînées, si les sources doivent être croisées ou si une synthèse dispersée s’avère nécessaire. Elle a été adoptée, entre autres, pour atténuer des hallucinations de modèles de langage en ancrant la génération dans des contenus externes vérifiés.