Tu veux les meilleurs outils IA avant les autres ?
On teste et on décrypte les nouveaux outils IA chaque soir, en 5 min. Gratuit.
Inclus dès l'inscription : notre sélection des meilleurs guides & comparatifs IA.
Choisis ton rythme
Gratuit · Pas de spam · Désabonnement en 1 clic
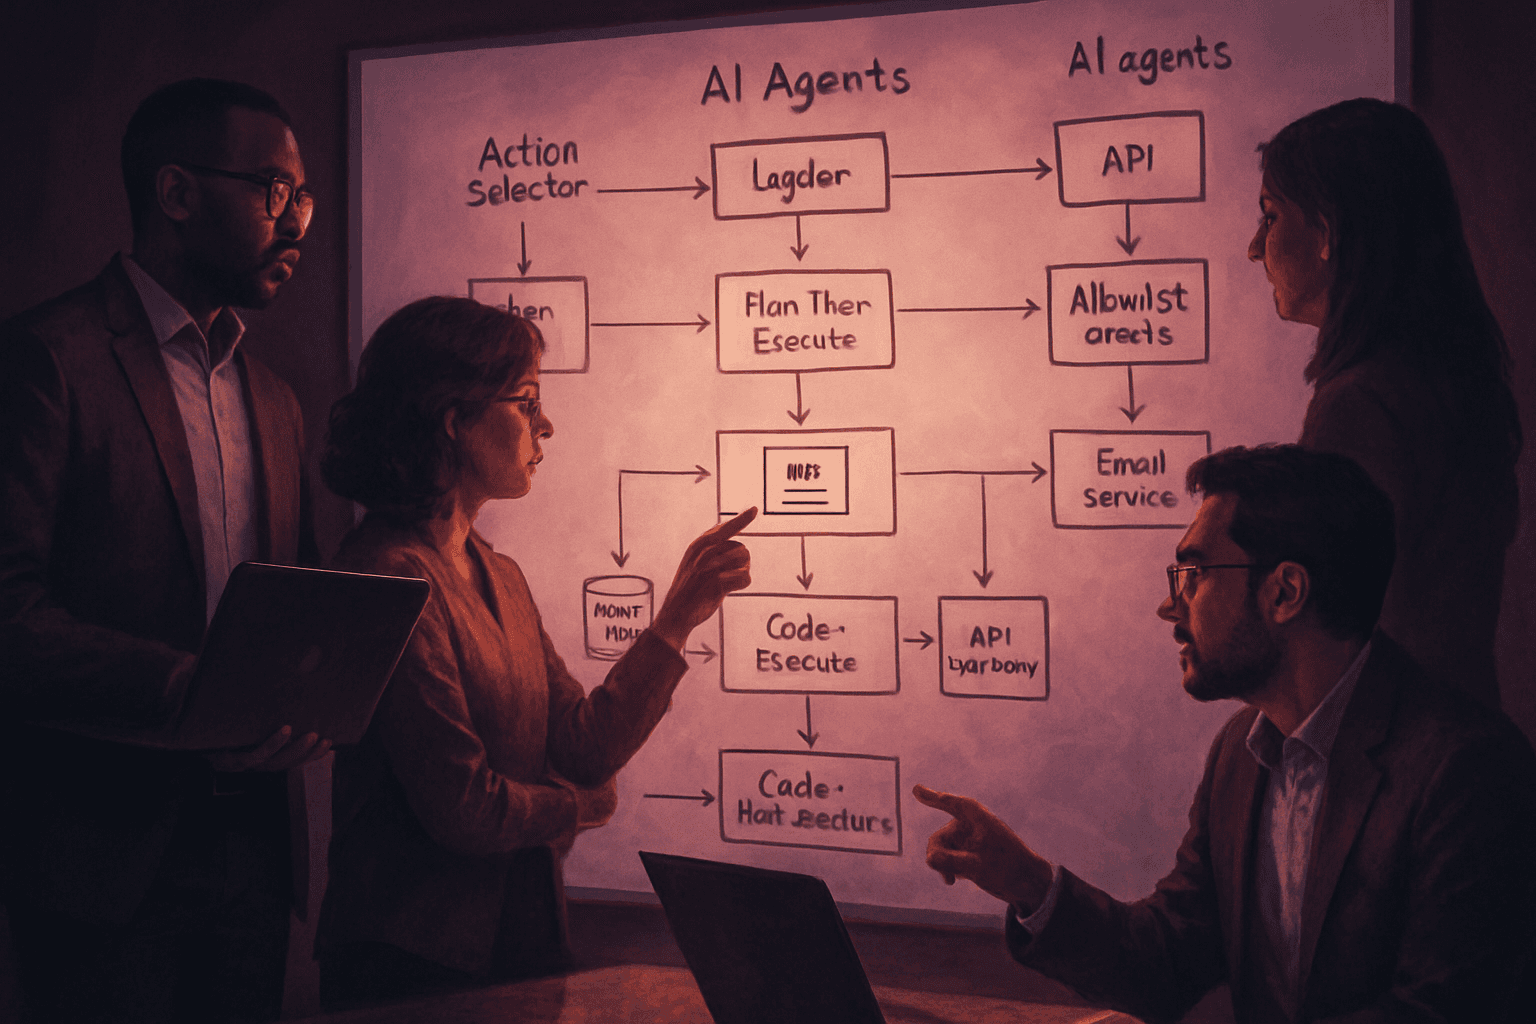
Des incidents récents rappellent qu’un seul détournement suffit à compromettre un agent IA connecté à Internet et aux systèmes internes. Trois modèles architecturaux — sélecteur d’action, planifier puis exécuter, coder puis exécuter — offrent des garde-fous concrets, à condition d’accepter des compromis sur la souplesse et l’ergonomie. Voici comment ils s’implémentent et ce qu’ils ne couvrent pas.
Des garde-fous efficaces, mais une adaptabilité réduite
Chaque modèle étudié apporte une protection ciblée contre l’injection de commandes, au prix d’une rigidité accrue. Le sélecteur d’action peut rendre un agent quasi immunisé aux manipulations, mais il limite l’agent à un ensemble figé d’opérations et expose à des erreurs d’implémentation. Un agent de réinitialisation de mot de passe bâti ainsi ne fait qu’exécuter des tâches prédéfinies et ne « conçoit » rien au-delà. Le schéma « planifier puis exécuter » empêche un attaquant d’influer sur le choix des outils ou des arguments, mais il sacrifie l’adaptation en temps réel : l’agent ne réagit pas à des structures inattendues, à des informations manquantes ou à des formulaires dynamiques, et le contenu malveillant peut encore teinter la sortie. Sa variante « coder puis exécuter » verrouille le flux d’exécution, sans empêcher la manipulation des variables d’entrée. Elle introduit en outre les risques propres à l’exécution de code, parfois inévitables mais à manier avec prudence, même si, pour certaines tâches, écrire et exécuter du code s’avère plus approprié que la simple planification.
Former l’utilisateur et verrouiller les points de contact
La sécurité commence par l’aval du système : l’utilisateur demeure le maillon le plus faible, comme le rappelle Bruce Schneier. Même de bonne foi, des employés internes peuvent mal interpréter une demande, commettre une erreur ou, sans s’en douter, se faire relayer une instruction hostile via une source externe. Cartographier les actions possibles, renforcer l’authentification et les vérifications d’accès, et délivrer une formation complète à la sécurité constituent la première ligne. Les connexions à des sources non fiables et les téléchargements sont identifiés comme des points critiques : les dépôts sont limités à des documents internes, sélectionnés depuis SharePoint, tout en reconnaissant qu’un simple copier‑coller de contenu web peut à lui seul exposer l’agent.
Interposer des services sûrs : l’exemple des fonctions et des emails
Au‑delà des consignes au modèle, les défenses systémiques offrent le meilleur levier de réduction du risque. Les instructions peuvent filtrer des usages indésirables, mais des architectures bien posées contrôlent effectivement les effets. Concrètement, l’agent n’exécute jamais de SQL brut. Il choisit des modèles de requêtes et renseigne des paramètres, tandis que des API hébergées via Azure Function assurent l’exécution, bornée à des opérations préprogrammées. Une requête de projets par secteur illustre ce découplage : l’API répond après interrogation, ou déclenche une erreur si le secteur n’existe pas. Le même principe encadre l’envoi d’emails : une fonction vérifie que le destinataire figure dans une liste autorisée avant d’émettre le message, sans exposition directe au service de messagerie.
Restreindre les actions autorisées réduit les risques d’injection
Limiter strictement le répertoire des actions évite de placer le LLM face à du contenu non fiable et coupe court aux tentatives d’injection. Dans ce cadre, le modèle traduit des requêtes en langage naturel en opérations explicitement autorisées, sur un périmètre connu. L’intérêt apparaît notamment lorsqu’un agent a accès au web et à une base interne : s’il pouvait générer et lancer du SQL, une instruction sournoise l’invitant à tronquer des tables pourrait être suivie à la lettre. Même sans privilèges élevés côté base, d’autres vecteurs demeurent. En ôtant au LLM l’exécution directe et en la confiant à des composants bornés, la surface d’attaque se réduit.
Planifier ou coder avant d’agir pour figer les décisions sensibles
Le schéma « planifier puis exécuter » impose de décider en amont des ressources à consulter et des destinataires d’emails avant toute exposition à des sources non fiables. Pour un agent qui assemble un rapport hebdomadaire à partir de données internes et de recherche web, cette discipline évite qu’un contact découvert en ligne — potentiellement contrôlé par un attaquant — devienne destinataire d’un message. Si un contenu nuisible peut encore se glisser dans la rédaction, l’ordonnancement des outils et les paramètres sensibles, comme l’adresse d’envoi, sont figés et hors de portée d’un tiers. Lorsque la structure de la tâche exige une boucle ou une logique dont la taille est inconnue à l’avance — par exemple se désinscrire des 100 dernières newsletters jamais ouvertes en 3 mois, qui peuvent n’être que 3 —, « coder puis exécuter » transforme la demande en code et verrouille le flux d’exécution. L’adversaire peut influer sur des valeurs de variables, mais pas sur le chemin d’exécution, au prix des risques propres à l’exécution de code.
Pourquoi ces garde-fous sont nécessaires : des ratés documentés
La probabilité perçue d’un scénario adverse peut sembler faible, mais les rapports d’incidents s’accumulent et un seul suffit à compromettre un système. Des cas ont vu NotebookLM intégrer dans une URL d’image des informations appartenant à un autre client, l’opérateur de ChatGPT extraire un email privé depuis un compte Hacker News authentifié, et Microsoft Copilot résumer un message en citant un lien contrôlé par un attaquant. Le terrain est propice à l’injection de commandes : des pages glissent des injonctions implicites, les modèles confondent contexte et instruction, et l’éventail des issues va de la fuite de données à la modification destructrice en base. Même sans malveillance apparente, une page concurrente structurée de façon directive peut orienter un classement. C’est tout l’enjeu à traiter en amont dans l’architecture.