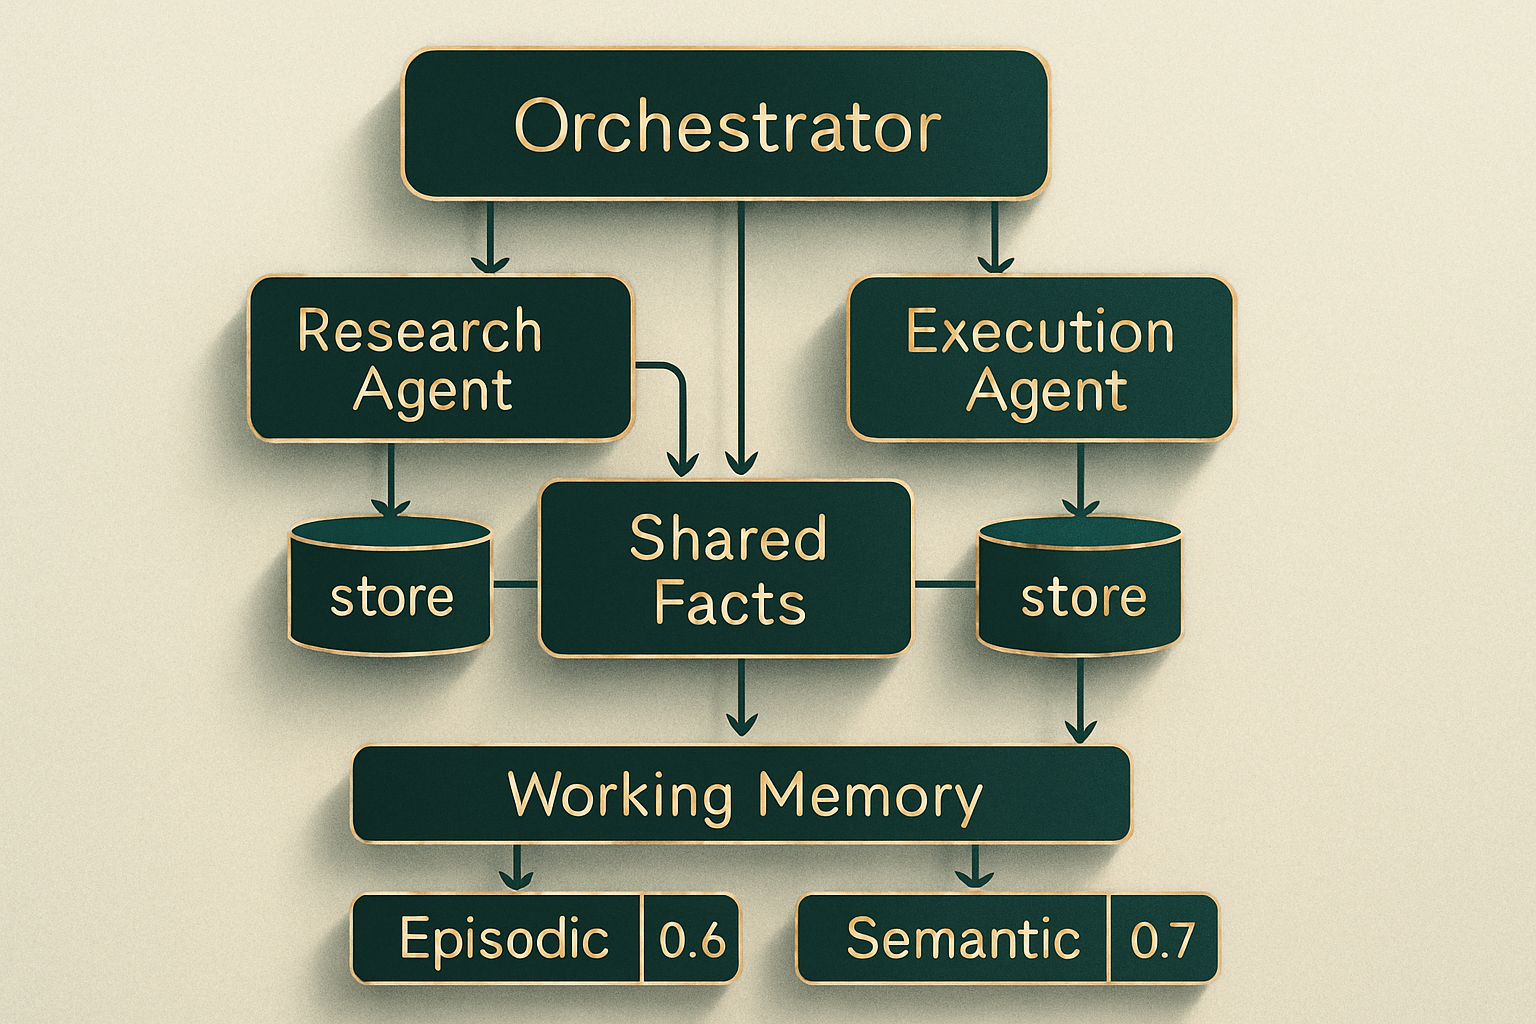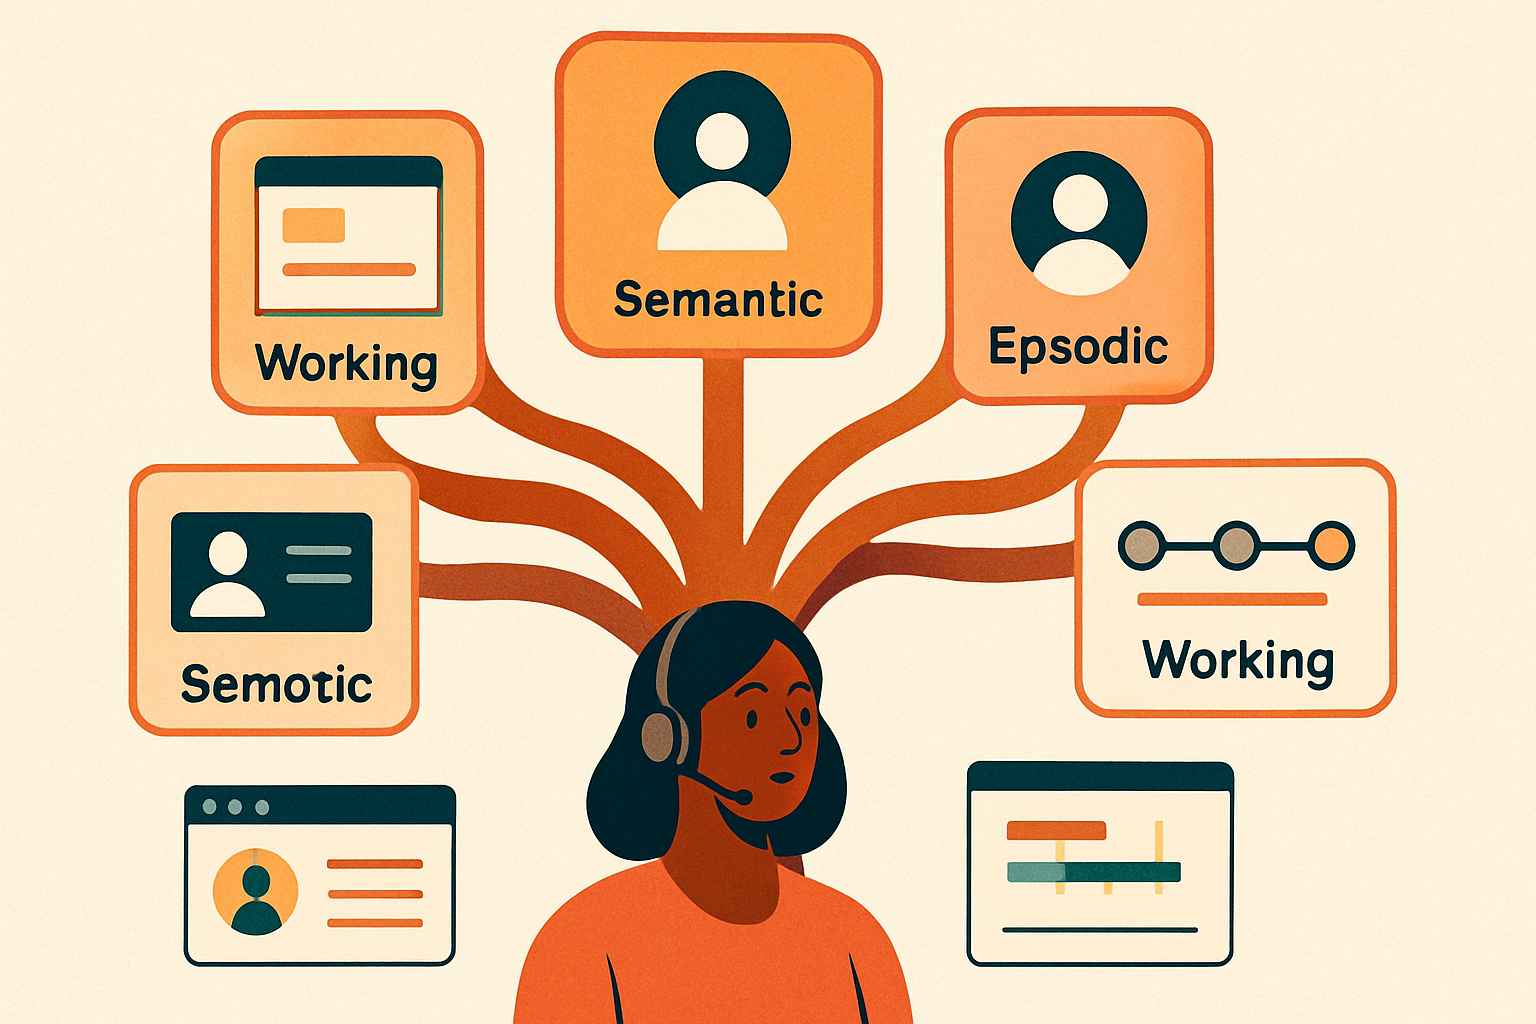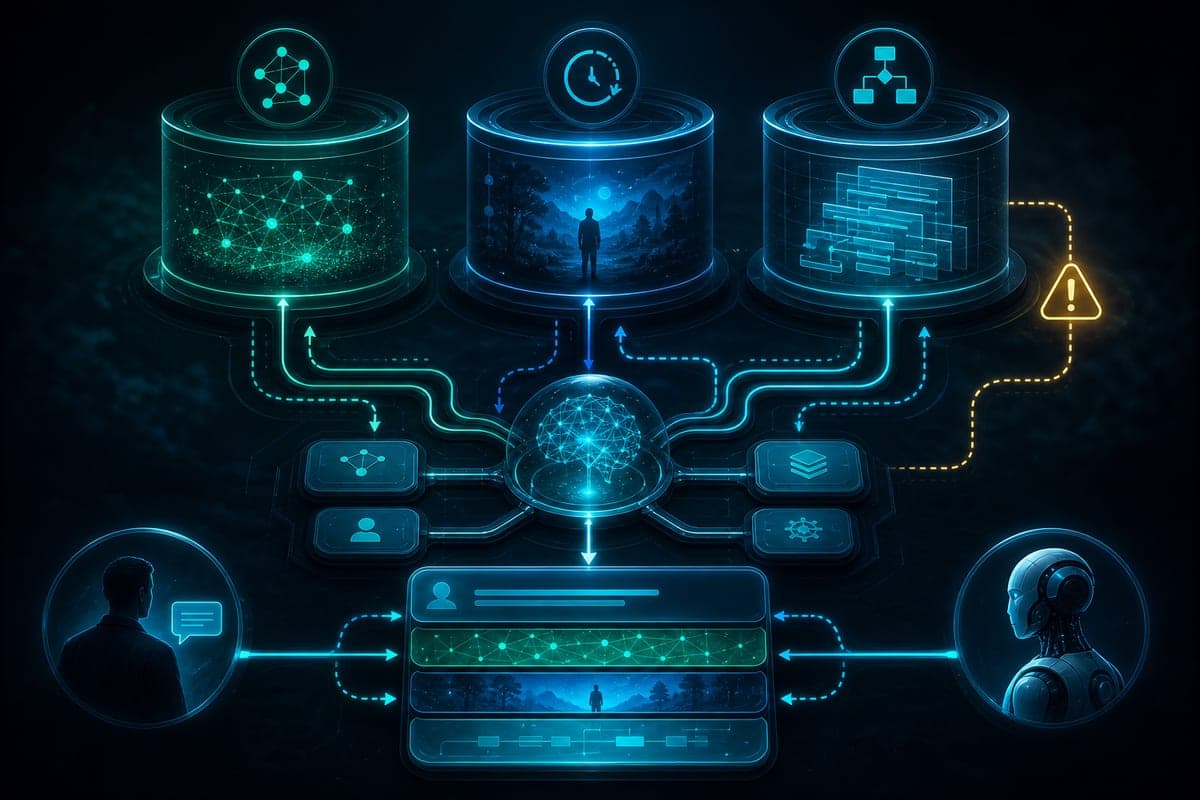
Séparer faits, expériences et règles de conduite change la façon de construire la mémoire des agents. Un cadre en trois volets — sémantique, épisodique, procédural — s’accompagne d’une implémentation sous LangGraph, d’avertissements sur les modifications globales et d’exercices pour valider le comportement du système.
Des protections contre les dérives des instructions procédurales
Modifier globalement les instructions procédurales d’un agent est déconseillé sans protections spécifiques. La conception doit distinguer les situations où une information doit être mise à jour, ajoutée uniquement ou exposée à un risque lié à la réflexion. Lors de chaque appel, le modèle assemble les éléments issus de chaque type de mémoire dans le message système. Des exercices sont proposés pour vérifier que la mémoire épisodique filtre correctement les expériences réussies, afin d’éviter des rappels non souhaités.
Trois mémoires pour des usages différents
La mémoire à long terme d’un agent se divise en trois catégories : la mémoire sémantique, qui conserve les faits actuels avec des règles de mise à jour ; la mémoire épisodique, qui enregistre les expériences en ajout uniquement, marquées par un signal de succès et récupérées par similarité ; et la mémoire procédurale, qui regroupe les instructions et invites système révisées par réflexion. Chacune nécessite un mode de stockage, un déclencheur et une méthode de récupération adaptés. Considérer la mémoire comme un ensemble uniforme expose à l’obsolescence des faits, à la perte d’exemples utiles et à des modifications comportementales non maîtrisées.
La recherche en IA vous passionne ?
Les papers et avancées qui comptent, expliqués simplement, chaque soir. Gratuit.
Inclus dès l'inscription : notre sélection des meilleurs guides & comparatifs IA.
Choisissez votre rythme
Gratuit · Pas de spam · Désabonnement en 1 clic
Implémentation sous LangGraph et exercices de validation
Les trois types de mémoire peuvent être réunis dans un stockage unique sous LangGraph, en utilisant des espaces de noms distincts et des logiques d’écriture et de lecture différenciées. Par exemple, une semaine après le lancement d’un agent, le stockage d’un utilisateur peut contenir un régime végétarien, une mise à jour indiquant la consommation de poisson, et une réservation de restaurant, tous stockés en paires clé-valeur et récupérés de façon identique. Des exercices invitent à restructurer un stockage existant selon ces espaces de noms, à tester le comportement de réflexion et de retrait, et à valider la bonne séparation des mémoires.