Les agents autonomes ne se limitent plus aux laboratoires. Ils opèrent déjà dans le code, la recherche et les opérations clients, mais leur passage en production exige des pratiques spécifiques. Cette feuille de route par niveaux détaille les garde-fous, architectures et protocoles à mettre en place pour des déploiements robustes.
Garder le contrôle : boucles, sandbox et observabilité en production
Les systèmes multi-agents fiables exigent des protections opérationnelles. L'atténuation des boucles incontrôlées est une première préoccupation : des agents peuvent perdre de vue leur objectif, recevoir des sorties d'outils inattendues ou se retrouver bloqués dans des cycles auto-renforcés, ce qui peut entraîner une consommation illimitée de jetons et de temps. Il est nécessaire d'intégrer dès la conception de l'infrastructure des dispositifs comme des coupe-circuits pour limiter le nombre d'étapes échouées, des restrictions sur la profondeur de récursion ainsi que des budgets de jetons ajustables, plutôt que de les ajouter ultérieurement. Pour l'exécution de code, il faut recourir à des environnements cloisonnés, tels que les conteneurs Docker, les sandboxes cloud e2b ou les runtimes WebAssembly, car autoriser l'exécution de code Python non contrôlé sur un serveur mutualisé expose à des failles de sécurité. L'observabilité constitue par ailleurs un écueil récurrent lors des premiers déploiements ; l'évaluation d'un enchaînement multi-étapes requiert davantage qu'une simple vérification du résultat final.
Ce qu’est un agent : boucle perception–action–outil et validations
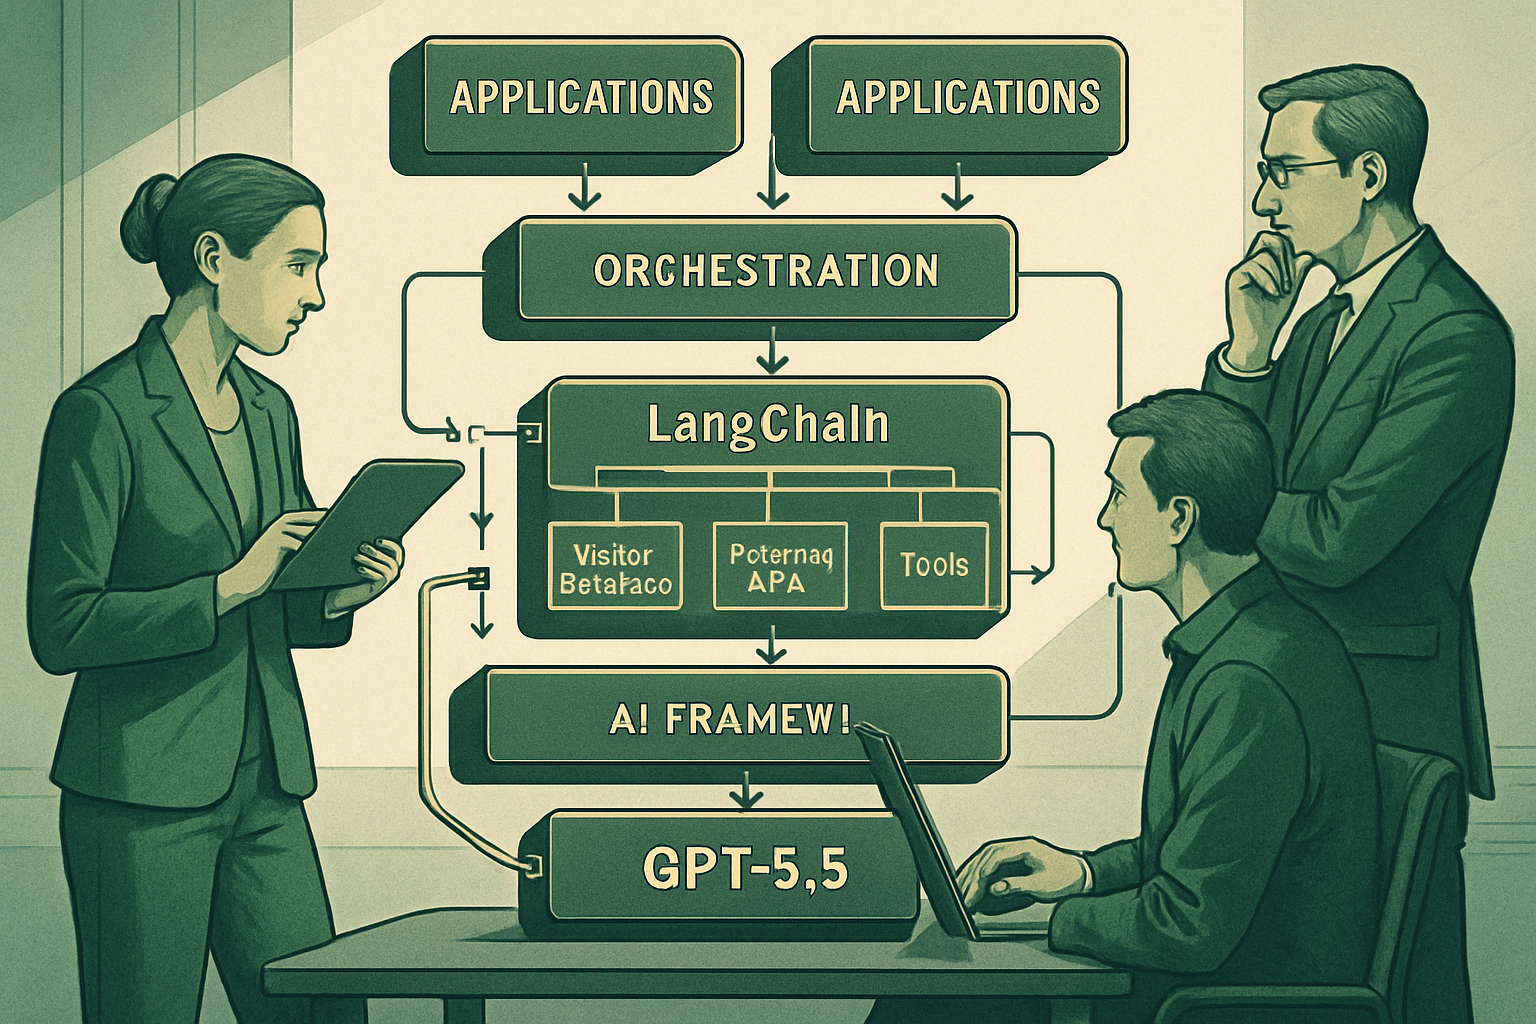
Un agent perçoit un environnement, choisit des actions, exécute via des outils et utilise les résultats pour la décision suivante ; cette boucle multi-étapes le distingue d'un simple appel à un modèle de langage. Plusieurs paradigmes structurent ce cycle : ReAct combine chaîne de raisonnement et appels d'outils selon un schéma penser–agir–observer ; Plan-and-Solve produit un plan complet à l'avance, utile lorsque la tâche est prévisible ; des modèles de réflexion conduisent le modèle à critiquer ses sorties ; Tree of Thoughts explore et évalue plusieurs branches avant sélection. Côté outils, l'agent produit des appels de fonctions structurés (recherche, exécution de code, requête de base de données), intègre les résultats à l'étape suivante et valide strictement les sorties avec Pydantic ou TypeChat pour éviter des appels mal formés. La gestion de la fenêtre de contexte, des résumés et de la récupération mémoire influe sur coûts et cohérence. Des modèles Pydantic illustrent ces pratiques, par exemple une fonction de recherche avec max_results par défaut à 5 et une exécution Python avec un délai de 30 secondes, la validation préalable réduisant les échecs d'exécution.
Mémoire persistante et flux par graphes pour des tâches ramifiées
Pour aller plus loin qu'une boucle classique, la solidité d'un système repose sur une mémoire durable et sur des mécanismes de contrôle non linéaires. On distingue trois types de mémoire : le contexte de travail, qui est rapide mais limité et onéreux ; la mémoire épisodique, utilisée pour conserver les échanges et les retrouver via une recherche vectorielle ; et la mémoire sémantique, structurée, généralement sous forme de graphe de connaissances, permettant de raisonner sur les entités et leurs relations. Les chaînes séquentielles montrent leurs limites pour des tâches à embranchements multiples ; LangGraph prend en charge les graphes acycliques dirigés et les machines d'état à cycles, tandis qu'AutoGen de Microsoft propose une approche différente pour offrir des fonctionnalités comparables. La persistance d'état, caractéristique des systèmes de production, autorise retour arrière, reprise d'exécution et débogage des chemins. Un exemple de machine d'état à deux nœuds illustre cet agencement, avec un état typé et des transitions jusqu'à END. Les ressources recommandées couvrent LangGraph, AutoGen et un ouvrage d'architecture applicative. Des exercices invitent à introduire une mémoire vectorielle et à en mesurer l'effet sur des sujets répétés.
Tu suis la course aux modèles IA ?
Chaque sortie (GPT, Claude, Gemini, Mistral…) décryptée le soir même, en 5 min. Gratuit.
Inclus dès l'inscription : notre sélection des meilleurs guides & comparatifs IA.
Choisis ton rythme
Gratuit · Pas de spam · Désabonnement en 1 clic
Travailler en équipe d’agents : hiérarchies, débats et protocoles
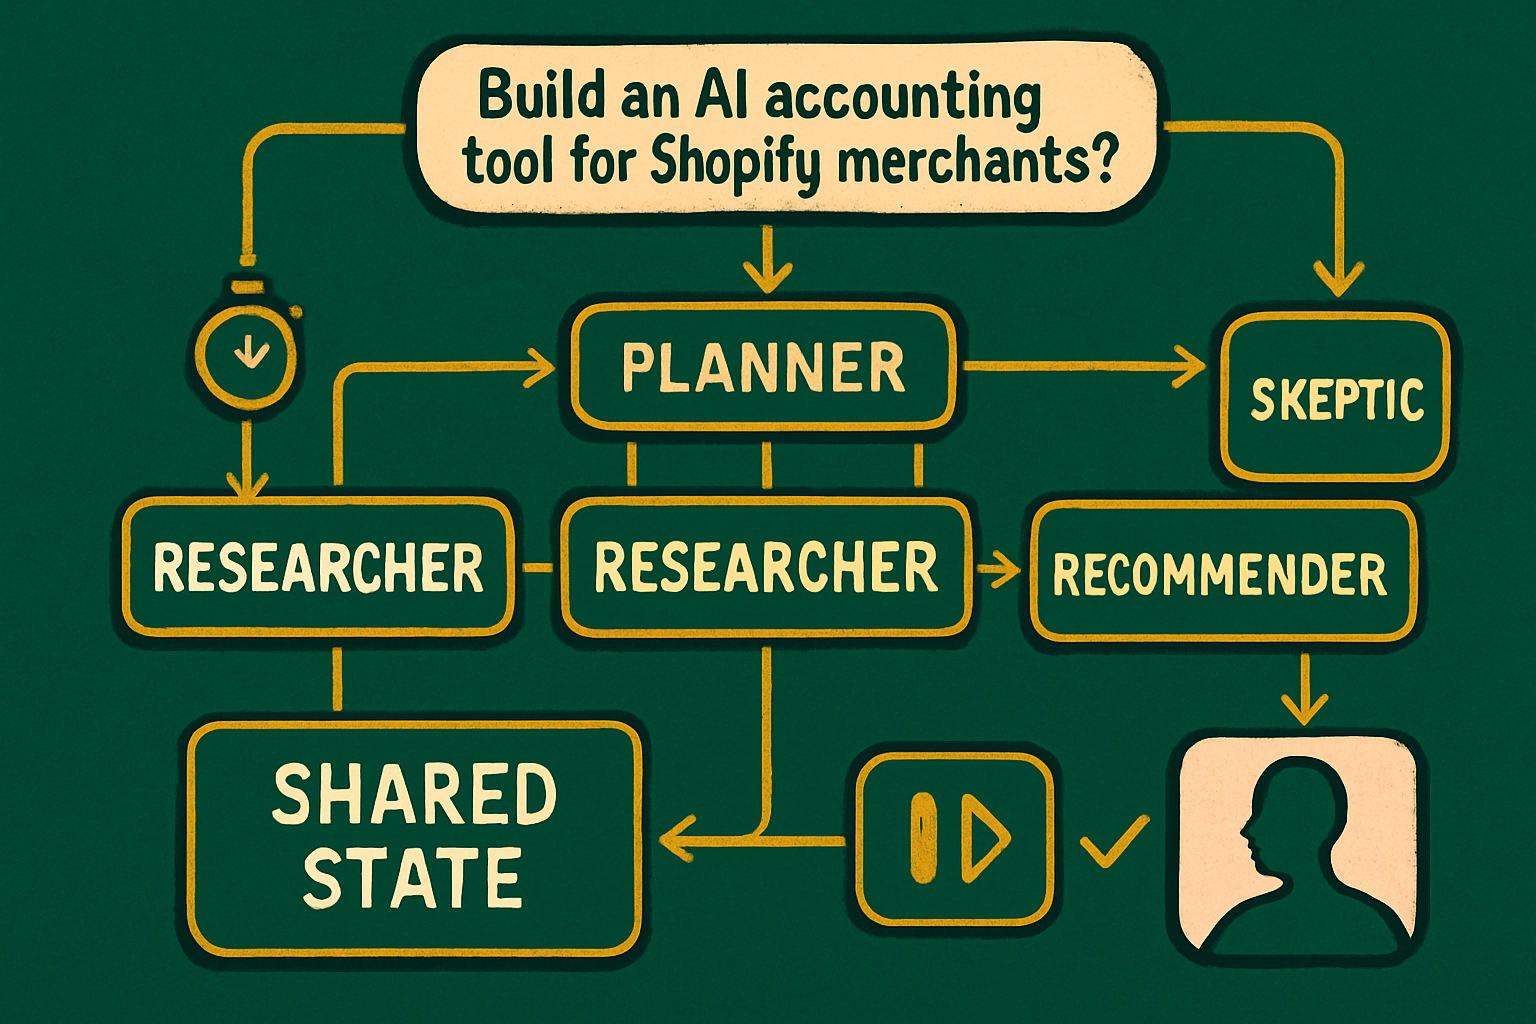
Lorsque la complexité dépasse un agent unique, des équipes spécialisées s'imposent. Les schémas hiérarchiques, fréquents en production, s'appuient sur un superviseur qui décompose, délègue et synthétise. Des architectures de débat opposent générateur et critique, utiles quand l’auto-critique ne suffit pas. Des arrangements pair-à-pair facilitent une exploration parallèle, par exemple pour une analyse concurrentielle multi-marchés. La communication structurée est essentielle : des messages non structurés propagent les erreurs, tandis que des schémas de messages et des contrats de transfert réduisent les échecs de coordination. Les divergences entre agents exigent des mécanismes définis, tels que vote, re-requête contextualisée ou escalade à un humain. Le Model Context Protocol, introduit par Anthropic, standardise la connexion aux outils et sources, avec une adoption croissante entre fournisseurs. Des ressources incluent AutoGen, CrewAI et la spécification MCP, et un exercice propose une équipe chercheur–écrivain–critique avec gestion d’un rejet et reprise.
Où l’agentique opère déjà et pourquoi la marche vers la prod est exigeante
L’IA agentique est sortie des laboratoires pour entrer dans les pipelines de relecture de code, les assistants de recherche, les opérations clients et l’automatisation interne, dans des entreprises de toutes tailles. Les systèmes déjà en place élaborent des plans, recourent à des outils et procèdent par itérations pour atteindre leurs objectifs. Passer en production demeure plus complexe que de mettre en place une simple démonstration : la différence avec un chatbot à réponse unique requiert d'autres compétences d'ingénierie, telles que la gestion de l'état, la reprise après incident, l'utilisation d'environnements d'exécution isolés et l'analyse de parcours multi-étapes. Un plan d'évolution en quatre étapes est présenté, allant de l’agent unique à la collaboration entre agents et à l’adoption de pratiques opérationnelles.
Ressources pratiques et exercices pour construire un portefeuille
Des pistes concrètes sont suggérées pour progresser et documenter ses systèmes. Côté lectures, l’article fondateur sur ReAct, la documentation de LangChain et de Pydantic, les guides LangGraph et AutoGen ainsi que l’ouvrage Building LLM-Powered Applications offrent un socle. Côté pratique, des exercices gradués incluent la construction d’un agent de recherche multi-étapes consignant ses raisonnements et appels d’outils, l’ajout d’une mémoire vectorielle et l’évaluation de son apport, puis la réalisation d’un trio chercheur–écrivain–critique où un rejet est provoqué et la reprise tracée, avec à la clé des artefacts de portfolio.