Notre analyse sur Ollama face au cloud situe autour de 50 millions de tokens par mois le point à partir duquel l’approche locale devient moins chère pour des agents IA et des charges intensives. Ce seuil résume le nouveau choix des DSI et des équipes produit : il ne s’agit plus de prendre « le meilleur modèle », mais d’arbitrer entre coût marginal, confidentialité, latence, performance et dépendance fournisseur. Les modèles ouverts perdent du terrain, les API managées simplifient la production et les modèles compacts gagnent du terrain. Ce guide détaille les usages qui fonctionnent, les outils, les règles, les pièges et un plan pour démarrer.
Ce que l’IA change vraiment pour la DSI et les équipes produit
Le choix d’un modèle n’est plus une décision isolée. Il engage l’hébergement, le routage, la sécurité, le budget par usage et la capacité à changer de fournisseur. Notre analyse sur les Small Language Models montre pourquoi des modèles plus petits, souvent inférieurs à 10 milliards de paramètres, deviennent rationnels pour des tâches ciblées. La bonne méthode consiste à séparer les flux : modèles compacts pour les opérations répétitives, modèles plus puissants pour les cas rares, contrôles humains pour les décisions sensibles.
La séparation entre local et cloud devient moins nette. Notre analyse sur Ollama face au cloud rappelle que le local transforme un coût variable en coût fixe, tandis que le cloud apporte simplicité, disponibilité et puissance immédiate. Une DSI doit donc bâtir une grille d’arbitrage : fréquence d’usage, sensibilité des données, charge prévisible, besoin de raisonnement, capacité interne d’exploitation et clauses de sortie.
Les équipes produit doivent aussi penser distribution et gouvernance. Un modèle propriétaire peut réduire le nombre d’étapes de déploiement, mais il contrôle l’accès, la facturation et les évolutions. Un modèle ouvert donne plus de maîtrise, sans supprimer les coûts d’infrastructure. Notre analyse sur le recul de l’IA ouverte rappelle que les modèles ouverts sont passés de 56 % du secteur en 2020 à 40 % en 2025 selon OnPodé, ce qui renforce l’importance d’un plan de réversibilité.
 Équipe IT et produit examinant une feuille de route IA près d’une salle serveur
Le choix du modèle se décide par usage, coût, données et capacité d’exploitation.
Les usages qui fonctionnent aujourd’hui
Les usages les plus fiables sont ceux dont les entrées, les sorties et les contrôles sont bornés. Les usages sensibles ou longs demandent un pilotage plus serré, même lorsque le modèle paraît performant en démonstration.
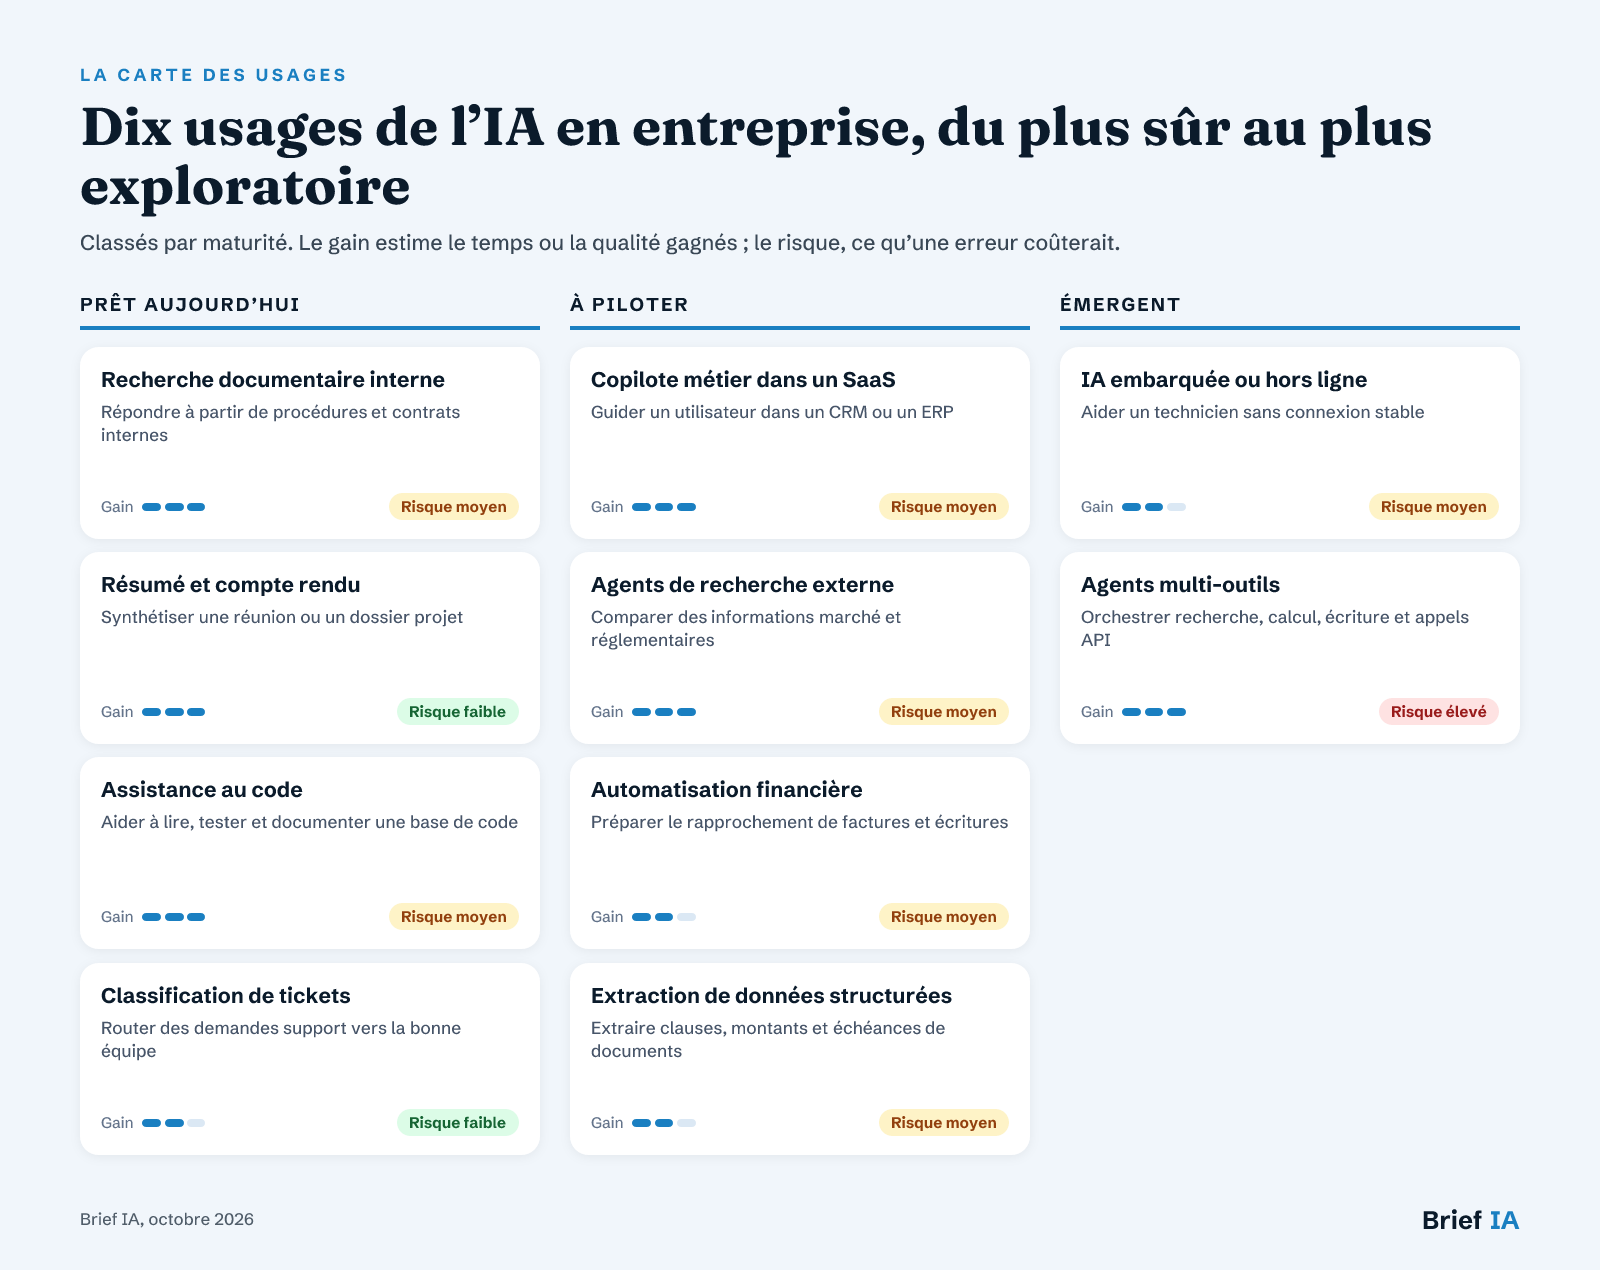 Carte des usages de l’IA pour les DSI et les équipes produit
Les usages classés par maturité, avec le gain attendu et le risque en cas d’erreur.
Les usages prêts à l’emploi
Recherche documentaire interne. Un modèle compact couplé à une base documentaire suffit souvent pour interroger procédures, contrats, spécifications et tickets. Le critère décisif n’est pas seulement la qualité du modèle, mais la qualité du découpage, du filtrage, des droits d’accès et de la citation des sources. Pour les documents sensibles, privilégiez un hébergement contrôlé ou un cloud dont la résidence des données est contractualisée.
Résumé et compte rendu. Le résumé est un bon premier cas d’usage si la sortie ne déclenche pas automatiquement une décision. Il faut imposer un format, conserver le document source et prévoir une validation humaine pour les comptes rendus diffusés. Un modèle généraliste via API convient au démarrage ; un modèle compact devient pertinent lorsque les volumes sont réguliers ou que les textes restent internes.
Assistance au code. Les modèles spécialisés dans le code sont utiles pour expliquer une fonction, générer des tests, proposer une documentation ou accélérer la revue. Le risque principal tient à l’intégration de code non validé et à l’exposition de dépôts privés. Limitez les accès, journalisez les requêtes, imposez une revue développeur et testez séparément les modèles pour génération, explication et correction.
Classification de tickets. La classification, le routage et l’extraction de champs sont adaptés aux modèles compacts, car les catégories sont finies et les erreurs mesurables. Définissez un jeu de test représentatif, mesurez précision et taux d’escalade, puis gardez une file de contrôle humain pour les cas ambigus. Ce cas permet de calculer rapidement un coût par ticket traité.
Les usages à piloter
Copilote métier dans un SaaS. Un copilote produit doit être conçu comme une interface d’action, pas comme un simple chat. Le modèle doit connaître les permissions, appeler des fonctions limitées et expliquer ses propositions avant exécution. Commencez en mode recommandation, sans action automatique. Le passage à l’action nécessite des journaux, des seuils d’autorisation et des tests par scénario métier.
Agents de recherche externe. Les agents de recherche peuvent réduire le temps d’analyse, mais ils consomment vite du contexte et multiplient les appels. Notre analyse sur Search as Code montre une autre voie : rendre la recherche programmable, avec récupération, filtrage, classement et vérification. À tester d’abord sur des sujets où les réponses peuvent être contrôlées par des sources identifiées.
Automatisation financière. Pour la comptabilité, la prévision de trésorerie ou la détection d’anomalies, l’AI Act ne classe pas ces outils comme systèmes à haut risque lorsqu’ils n’ont pas d’usage à haut risque. Il reste nécessaire de sécuriser les données, de tracer les corrections et d’éviter les validations automatiques non contrôlées. Les modèles doivent être évalués sur des écritures réelles anonymisées ou cloisonnées.
Extraction de données structurées. L’extraction fonctionne si le format attendu est strict et si un contrôle de cohérence vérifie les montants, dates et champs obligatoires. L’actualité sur TOON rappelle qu’un format plus économe que JSON peut réduire la répétition des champs dans des données structurées répétitives. Gardez JSON lorsque la sortie doit être analysable sans ambiguïté.
Les usages émergents
IA embarquée ou hors ligne. Les modèles compacts exécutés localement ouvrent des usages dans les postes de travail, ateliers, agences ou environnements sans connexion continue. L’intérêt porte sur la confidentialité, la latence et la continuité de service. Le risque se déplace vers les mises à jour, la distribution des modèles, la mesure de performance sur matériel hétérogène et la protection des données stockées localement.
Agents multi-outils. Les agents qui enchaînent plusieurs outils peuvent apporter des gains importants, mais ils concentrent les risques : dérive de coût, actions non souhaitées, erreurs difficiles à attribuer. Un pilote doit limiter le nombre d’outils, imposer des plafonds de tokens, simuler les actions avant exécution et prévoir un arrêt automatique. Ce n’est pas un premier projet de production.
Les outils à connaître
Il n’existe pas de palmarès universel : il faut choisir une famille d’outils selon le flux, les données, le budget et le niveau d’exploitation accepté.
- Les API de modèles généralistes et spécialisés. Elles accélèrent les prototypes et les tâches complexes, avec une facturation au volume de tokens ou à l’abonnement. Notre analyse sur Mistral AI en 2026 détaille une offre mêlant modèles à poids ouverts, API et plans d’accès pour équipes produit. À exiger : clauses de données, résidence, journaux d’usage, plafonds de coûts, réversibilité.
- Les modèles compacts auto-hébergés. Ils conviennent aux usages réguliers, sensibles ou répétitifs, à condition d’assumer l’exploitation. Notre article sur l’auto-hébergement rappelle l’intérêt en coût et en protection des données, tandis que les limites matérielles restent à tester. À exiger : bancs d’essai internes, supervision, mises à jour, mesure de latence, plan de secours cloud.
- Les clouds souverains et environnements contrôlés. Ils répondent aux besoins de résidence des données, de conformité et de maîtrise contractuelle. Notre analyse sur l’IA managée sur cloud souverain en France compare notamment les familles d’offres pour workloads d’IA sensibles. À exiger : localisation, qualification, conditions de sous-traitance, chiffrement, sortie des données.
- Les plateformes d’accès multicloud et de routage. Elles permettent de choisir un point de terminaison, une région ou un chemin réseau selon le cas d’usage. Notre analyse sur Microsoft Foundry et Google Cloud AI montre que le routage, l’identité et la résidence comptent autant que le modèle. À exiger : routage documenté, gestion des identités, traçabilité, tests de bascule, compatibilité fonctions.
- Les outils de comptage et de maîtrise des tokens. Ils évitent les surprises budgétaires et facilitent la comparaison entre modèles. La version 0.30 de llm-anthropic ajoute par exemple une commande de comptage de tokens avant envoi. À exiger : estimation avant appel, budgets par projet, alertes, ventilation par usage, conservation des métriques.
L’IA appliquée, concrètement ?
Les cas d’usage qui marchent vraiment, décryptés chaque soir en 5 min. Gratuit.
Inclus dès l'inscription : notre sélection des meilleurs guides & comparatifs IA.
Choisissez votre rythme
Gratuit · Pas de spam · Désabonnement en 1 clic
Le cadre : AI Act, données, cybersécurité et responsabilité
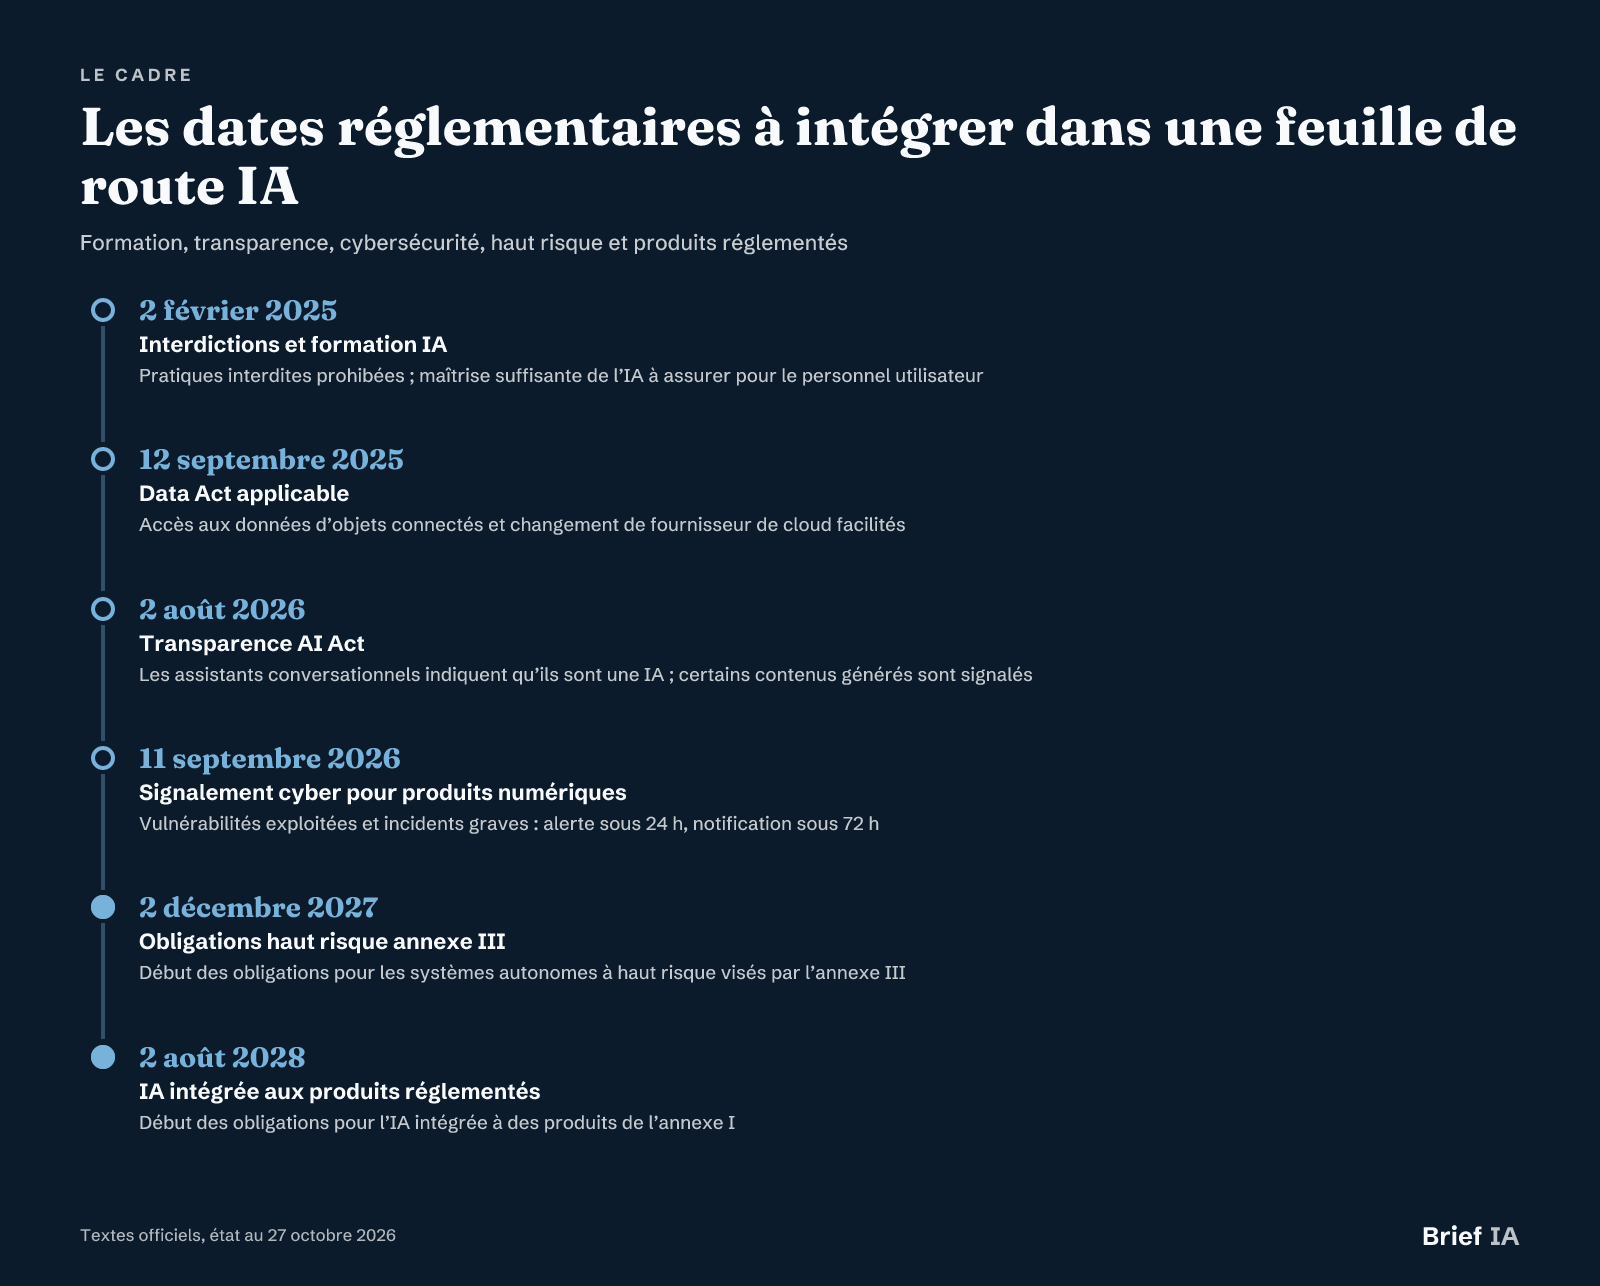 Les dates réglementaires à intégrer dans une feuille de route IA
Les dates clés, état au 27 octobre 2026.
AI Act déjà applicable
L’AI Act est entré en vigueur le 1er août 2024 et s’applique par étapes. Depuis le 2 février 2025, les pratiques interdites sont prohibées et toute organisation utilisant des systèmes d’IA doit assurer un niveau suffisant de maîtrise de l’IA de son personnel. Depuis le 2 août 2026, les obligations de transparence s’appliquent : un assistant conversationnel doit indiquer qu’il est une IA, et certains contenus générés doivent être signalés comme tels.
Haut risque : l’échéance 2027
Les systèmes à haut risque autonomes de l’annexe III couvrent notamment l’emploi, l’éducation, les infrastructures critiques, certains accès aux services essentiels, la police, la migration, la justice et les processus démocratiques. Depuis le Digital Omnibus, publié le 24 juillet 2026 et entré en vigueur le 27 juillet 2026, leurs obligations s’appliquent à partir du 2 décembre 2027. Les outils de rédaction, synthèse, comptabilité, prévision de trésorerie ou détection de fraude sans usage à haut risque relèvent seulement des obligations générales.
Données et décisions automatisées
Le RGPD est en application depuis le 25 mai 2018. Son article 22 encadre les décisions fondées exclusivement sur un traitement automatisé qui produisent des effets juridiques ou significatifs sur une personne. Dans un projet IA, qualifiez les données, limitez les accès, documentez les traitements et prévoyez une intervention humaine lorsque l’outil peut affecter une personne. Le CSE doit aussi être informé et consulté lors de l’introduction de nouvelles technologies dans l’entreprise.
Cloud, produits et incidents
Le Data Act s’applique depuis le 12 septembre 2025 et facilite notamment le changement de fournisseur de cloud. Depuis le 11 septembre 2026, le Cyber Resilience Act impose aux fabricants de produits comportant des éléments numériques de signaler les vulnérabilités activement exploitées et les incidents graves, avec alerte sous 24 heures et notification sous 72 heures. La directive sur la responsabilité du fait des produits défectueux inclut les logiciels, y compris les systèmes d’IA, et doit être transposée au plus tard le 9 décembre 2026.
Les pièges à éviter
Comparer seulement les benchmarks. Un score général ne dit rien sur vos documents, vos langues, vos formats et vos contraintes de latence. Construisez un jeu d’essai interne avec exemples faciles, cas limites, données longues et sorties attendues. Le modèle retenu doit gagner sur vos tâches, pas sur une moyenne abstraite.
Oublier le coût complet. Le prix par million de tokens ne couvre pas tout. Ajoutez stockage, orchestration, GPU, électricité, surveillance, sécurité, support et temps d’équipe. Pour le local, mesurez aussi l’énergie réelle et le débit, car le modèle le moins coûteux à exécuter n’est pas nécessairement le plus petit.
Surdimensionner les modèles. Un modèle très puissant pour classer des tickets ou reformuler des textes crée souvent un coût inutile. Testez d’abord un modèle compact, puis escaladez uniquement les cas difficiles vers un modèle plus puissant. Cette architecture en cascade réduit la facture et clarifie les niveaux de risque.
Négliger la réversibilité. Un fournisseur peut modifier prix, modèle, région, quotas ou fonctionnalités. Préservez des prompts portables, des jeux de tests, une couche d’abstraction et un second modèle qualifié. La réversibilité doit être testée avant la production, pas seulement inscrite dans un contrat.
Confondre assistance et décision. Un assistant qui rédige, résume ou suggère n’a pas le même risque qu’un système qui décide seul. Dès que l’outil affecte une personne ou une opération critique, renforcez les contrôles, la traçabilité, l’explicabilité opérationnelle et l’intervention humaine.
Passer à l’action : le plan en 90 jours
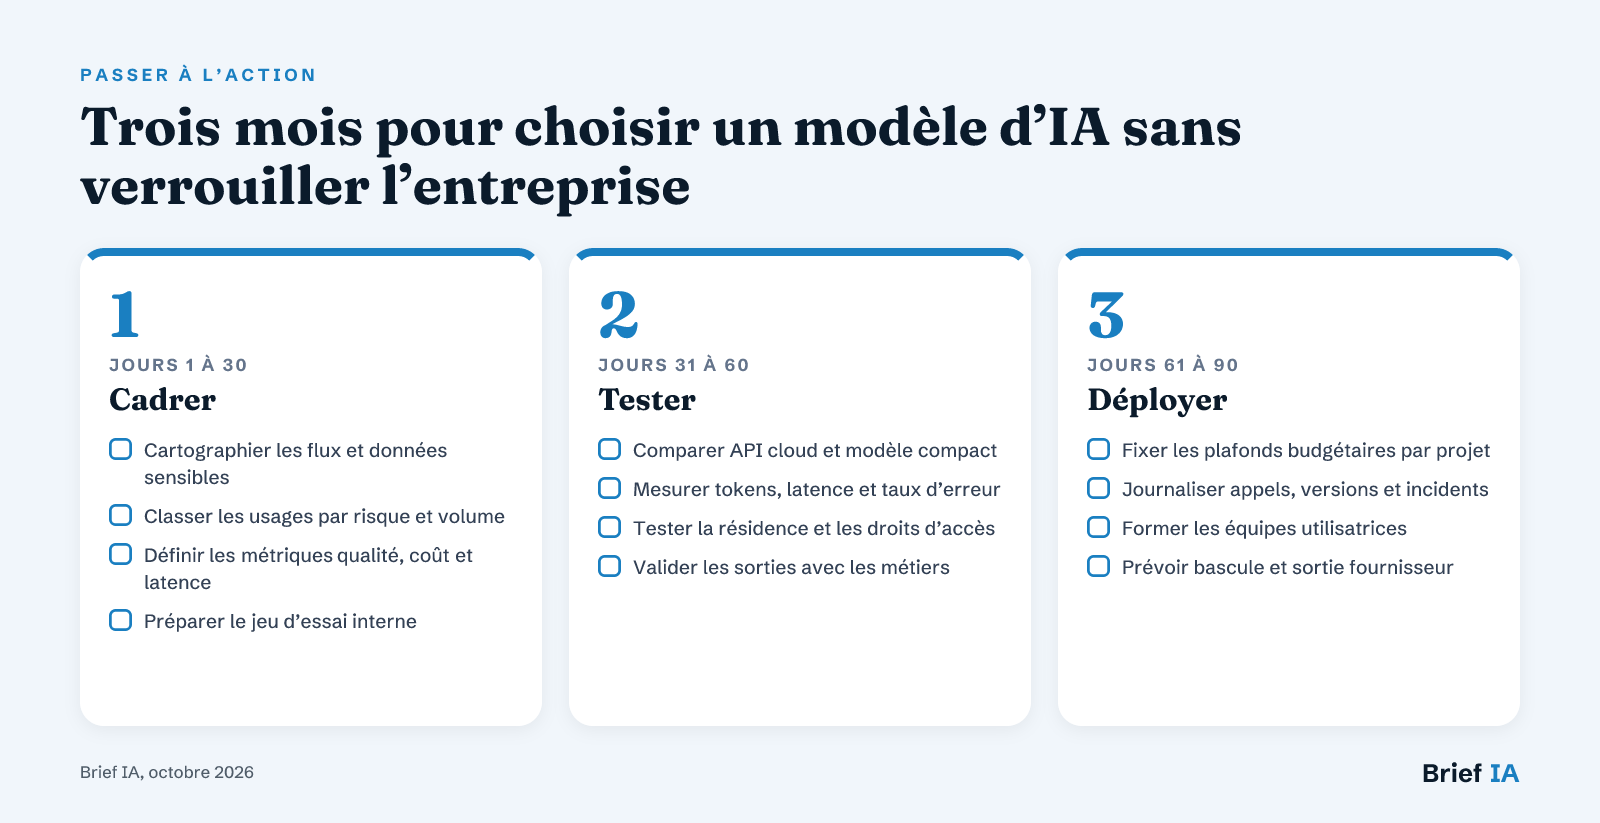 Trois mois pour choisir un modèle d’IA sans verrouiller l’entreprise
Trois étapes : cadrer, tester, déployer.
Commencez par des flux métiers à volume réel, couvrant productivité, documentaire et intégration dans un produit. Pendant trois mois, mesurez qualité, coût, latence, incidents et effort d’exploitation sur une API managée et un modèle compact contrôlé. Décidez ensuite par famille d’usage, sans chercher un modèle unique pour toute l’entreprise.
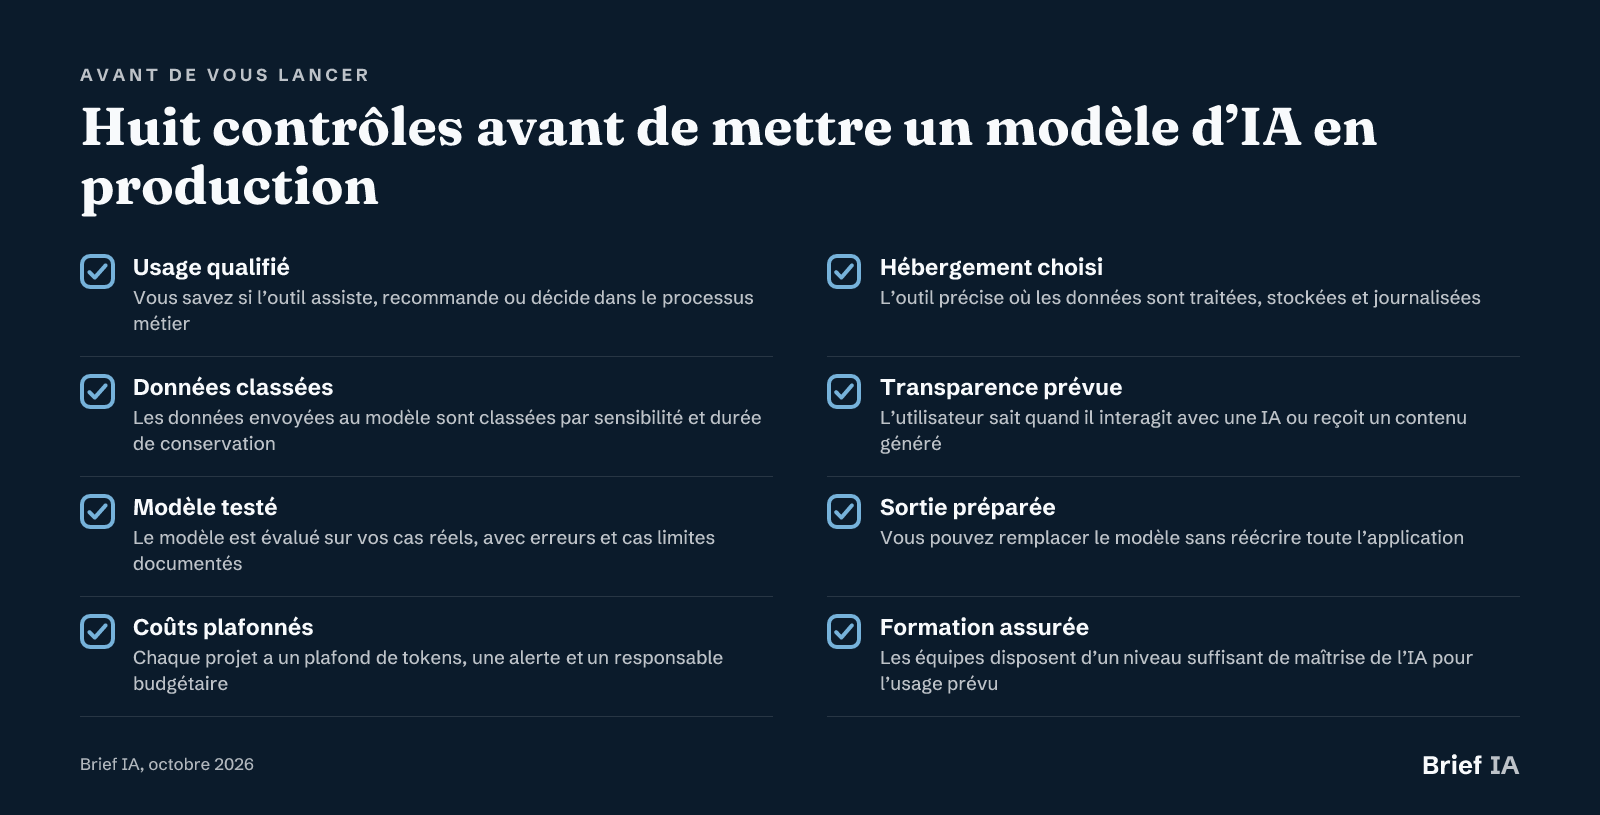 Huit contrôles avant de mettre un modèle d’IA en production
Huit vérifications à faire avant chaque nouvel usage.
Pour aller plus loin
Nos analyses pour les DSI et les équipes produit
- Pourquoi les modèles compacts changent l’économie des projets IA. Comprendre quand un petit modèle suffit et pourquoi coût, latence et confidentialité deviennent décisifs.
- IA locale ou cloud : la grille de décision opérationnelle. Comparer coût marginal, confidentialité, charge d’usage et puissance de raisonnement avant de choisir.
- Déployer une IA managée sur cloud souverain en France. Identifier les critères d’hébergement, de qualification et d’architecture pour des workloads sensibles.
- Microsoft Foundry ou Google Cloud AI : choisir son accès modèle. Voir comment endpoints, régions, identité et routage influencent la gouvernance d’un projet IA.
- Search as Code face aux API LLM classiques. Mesurer l’intérêt d’une recherche programmable pour les agents et les usages documentaires complexes.
- Pourquoi les modèles ouverts perdent du terrain. Comprendre les effets des coûts, licences, API et canaux de distribution sur la stratégie modèle.
L’actualité à retenir
- Auto-hébergement de LLM : maîtriser ses données et réduire certains coûts
- LLM auto-hébergés : les limites matérielles à anticiper en production
- Coût énergétique des LLM locaux mesuré sur RTX 3090
- Ollama, LM Studio et llama.cpp comparés pour les moteurs d’exécution IA
- TOON propose de réduire les tokens dans les données structurées répétitives
- llm-anthropic 0.30 ajoute actualisation des modèles et comptage de tokens
Vous éditez une solution pour les projets d’IA en entreprise ?
Ce guide est lu par des DSI, des architectes IT, des responsables data et des équipes produit. Brief IA propose aux éditeurs de solutions d’IA, plateformes cloud, fournisseurs de modèles et outils de gouvernance des articles dédiés, des encarts dans le brief du soir et une mise en avant dans l’annuaire. Formats et tarifs sur briefia.fr/partenaires.
L’essentiel en questions
Quel modèle d’IA choisir pour une entreprise en 2026 ?
Il faut partir du cas d’usage, pas du nom du modèle. Un résumé interne, une recherche documentaire, un copilote produit et un agent multi-outils n’ont pas les mêmes exigences. Comparez un modèle managé et un modèle compact sur vos données, avec mesures de qualité, coût, latence, confidentialité et réversibilité.
Faut-il privilégier un modèle ouvert ou propriétaire ?
Un modèle propriétaire simplifie souvent le démarrage, l’accès aux modèles puissants et l’exploitation. Un modèle ouvert donne davantage de maîtrise, notamment pour l’hébergement contrôlé et la personnalisation. Le bon choix dépend du volume, des données sensibles, des compétences internes et du besoin de changer de fournisseur sans refondre l’application.
Quand l’auto-hébergement d’un LLM devient-il intéressant ?
L’auto-hébergement devient pertinent lorsque l’usage est régulier, volumineux ou sensible. Il peut réduire la dépendance aux API et garder les données dans un environnement contrôlé. Il impose toutefois matériel, supervision, mises à jour, mesure énergétique et compétences d’exploitation. Un pilote doit mesurer le coût complet, pas seulement l’absence de facture API.
Un outil d’IA interne est-il un système à haut risque ?
Pas nécessairement. Les outils de rédaction, synthèse, comptabilité, prévision de trésorerie ou détection de fraude sans usage à haut risque ne sont pas classés comme systèmes à haut risque par l’AI Act. En revanche, certains usages dans l’emploi, l’éducation, les infrastructures critiques ou l’accès à des services essentiels peuvent relever de l’annexe III.
Comment éviter une facture IA incontrôlée ?
Il faut compter les tokens avant envoi lorsque c’est possible, limiter les contextes, choisir des formats sobres, fixer des plafonds par projet et journaliser les appels par usage. Les modèles compacts et les architectures en cascade réduisent aussi la facture : les tâches simples restent sur un modèle économique, les cas difficiles montent vers un modèle plus puissant.