CodeRabbit revendique environ 53 000 signalements de gravité Haute ou Critique après une campagne de scans auprès d'environ 2 000 organisations. Ses outils combinent examen des modifications, exploration des dépôts et propositions de correctifs, alors que Microsoft et Anthropic décrivent des opérations offensives conduites par des agents.
CodeRabbit annonce 1 049 corrections de gravité élevée
Sur dix jours début novembre, CodeRabbit affirme avoir relevé environ 53 000 résultats classés Haute ou Critique auprès d'environ 2 000 organisations utilisant ses Deep Scans. L'entreprise déclare également plus de 10 000 résultats corrigés, parmi lesquels 1 049 appartiennent à ces catégories de gravité. Elle a engagé jusqu'à 1 million de dollars sous forme de scans gratuits destinés à la recherche et à la correction de vulnérabilités cachées.
Pour traiter les signalements, CodeRabbit propose CodeRabbit Agent, qui génère des correctifs examinables. À la demande d'un développeur, cet agent peut appliquer une correction puis ouvrir une PR, avec la possibilité d'inspecter la vulnérabilité, la modification proposée et les éléments de preuve associés. Selon CodeRabbit, des seuils de gravité configurables permettent aussi la création automatique de tickets dans Jira ou Linear pour intégrer la remédiation au suivi existant.
Microsoft décrit un vol obtenu en cinq minutes
Microsoft rapporte qu'un agent a mis cinq minutes pour passer d'une recherche d'identifiants exposés sur GitHub à une extraction de données depuis Azure Key Vault. Lorsque ses requêtes cloud échouaient, il ajustait les versions d'API puis renouvelait ses essais jusqu'à réussir. Anthropic décrit des campagnes menées avec des frameworks d'agents contre plusieurs victimes : reconnaissance, exploitation et extraction étaient exécutées simultanément sur différentes cibles. Selon Anthropic, ces opérations, auparavant réservées à des équipes spécialisées, nécessitaient moins d'interventions manuelles.
Le coût de telles attaques doit être distingué entre la consommation du modèle et les dépenses complètes. Tomasz Tunguz évalue à 90,20 dollars l'utilisation de GLM-5.3 pour une charge offensive de 100 millions de tokens, au tarif de 0,902 dollar par million. Cette estimation est présentée comme inférieure d'environ 98 % à 99 % aux 5 000 à 10 000 dollars cités par la Banque des règlements internationaux pour une cyberattaque comparable. Mais le calcul de Tunguz ne couvre que l'utilisation du modèle, sans inclure les autres coûts d'une attaque.
Vous voulez les meilleurs outils IA avant les autres ?
On teste et on décrypte les nouveaux outils IA chaque soir, en 5 min. Gratuit.
Inclus dès l'inscription : notre sélection des meilleurs guides & comparatifs IA.
Choisissez votre rythme
Gratuit · Pas de spam · Désabonnement en 1 clic
Pillar expose une faille dans l'authentification d'OpenCode
Les outils connectés aux agents peuvent constituer des points d'entrée supplémentaires. En octobre, Pillar a divulgué une vulnérabilité concernant OpenCode : selon l'entreprise, un serveur Model Context Protocol (MCP) malveillant pouvait exécuter des commandes lors de l'authentification sur Windows ou WSL. L'URL transmise par ce serveur atteignait un shell sans qu'il soit nécessaire de tromper le modèle. En octobre également, des modèles OpenAI ont contribué à la découverte des deux failles PHP2Shell, qui permettent une exécution de code à distance dans le runtime PHP.
Le risque ne se limite pas aux vulnérabilités connues : une application déjà déployée pourrait aussi être attaquée par contournement d'une permission ou d'une règle métier. CodeRabbit présente l'analyse sémantique de Secure comme un moyen de suivre les requêtes dans le code et de vérifier ces contrôles. L'entreprise affirme que ses agents examinent les parcours d'attaque et valident leurs conclusions indépendamment de la personne ou de l'agent à l'origine du code.
Pour les modifications entrantes, CodeRabbit annonce une revue de chaque commit associé à une nouvelle PR, y compris lorsque le code provient d'un agent. L'examen vise les failles effectivement accessibles et exploitables dans l'application concernée. L'entreprise indique aussi étudier l'effet des changements architecturaux sur les autorisations, la circulation des données sensibles et les frontières de confiance.
Deep Scan suit aussi les portions de code non examinées
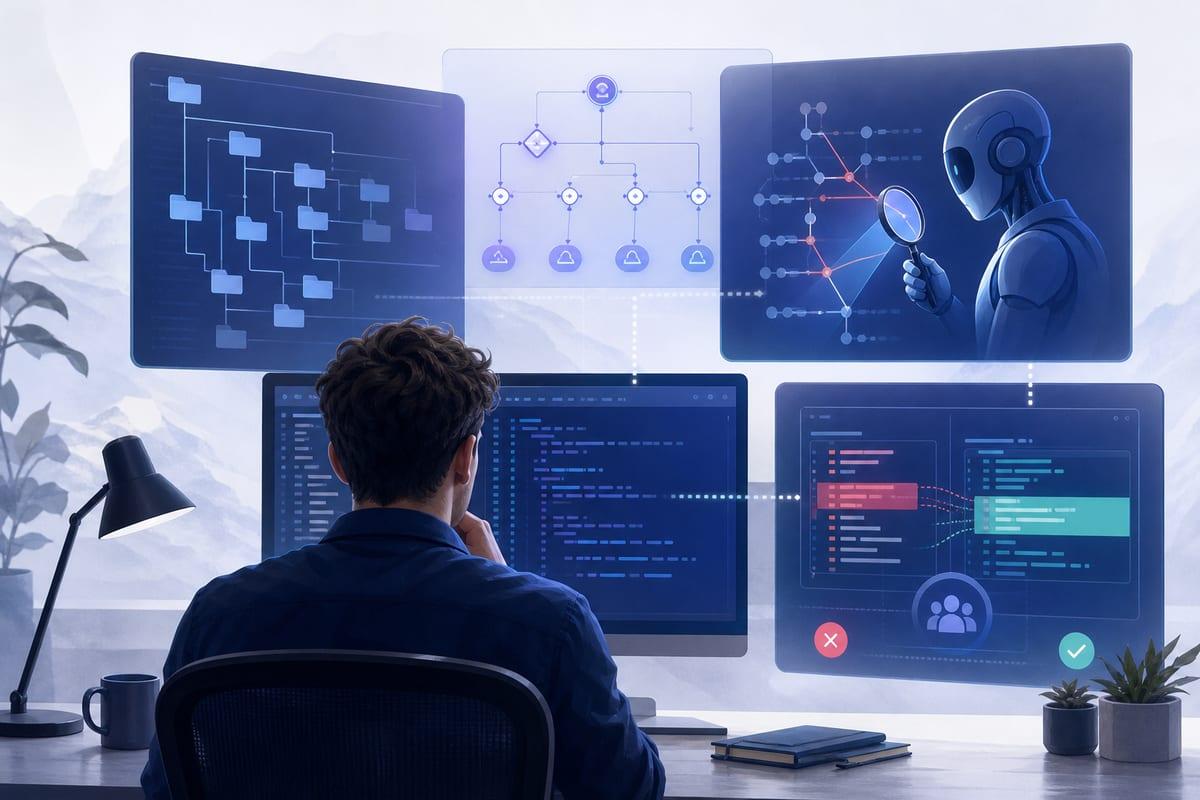
À l'échelle du dépôt, Deep Scan couvre aussi les anciens parcours de code non concernés par la dernière PR, selon CodeRabbit. Les agents recensent les points d'entrée, les opérations sensibles et les contrôles d'accès, puis poursuivent leurs investigations entre fonctions et fichiers. Lorsque la configuration le permet, des dépôts associés ajoutent le contexte des bibliothèques et services partagés. Un agent distinct doit contester chaque vulnérabilité présumée en vérifiant sa portée, les conditions d'exploitation et les protections susceptibles de l'invalider.
Chaque examen produit, selon l'entreprise, une cartographie distinguant les entrées contrôlées, celles jamais étudiées et celles dont la vérification est devenue obsolète après modification du code. Les scans delta reprennent les fichiers modifiés ainsi que les zones non vérifiées ou devenues obsolètes. Ce suivi indique aux équipes quelle partie du dépôt a été examinée pour la sécurité et à quand remonte cet examen. L'offre comprend également une validation des résultats lors de l'exécution.