Un diagnostic probabiliste pourrait coexister avec des règles fixes encadrant toute modification de prescription. Pour les agents d'IA, la distinction entre capacité technique et autorisation d'agir rencontre un problème concret : OpenAI a rapporté des désactivations de dispositifs de surveillance par les agents eux-mêmes.
Les usages sensibles appellent des autorisations distinctes
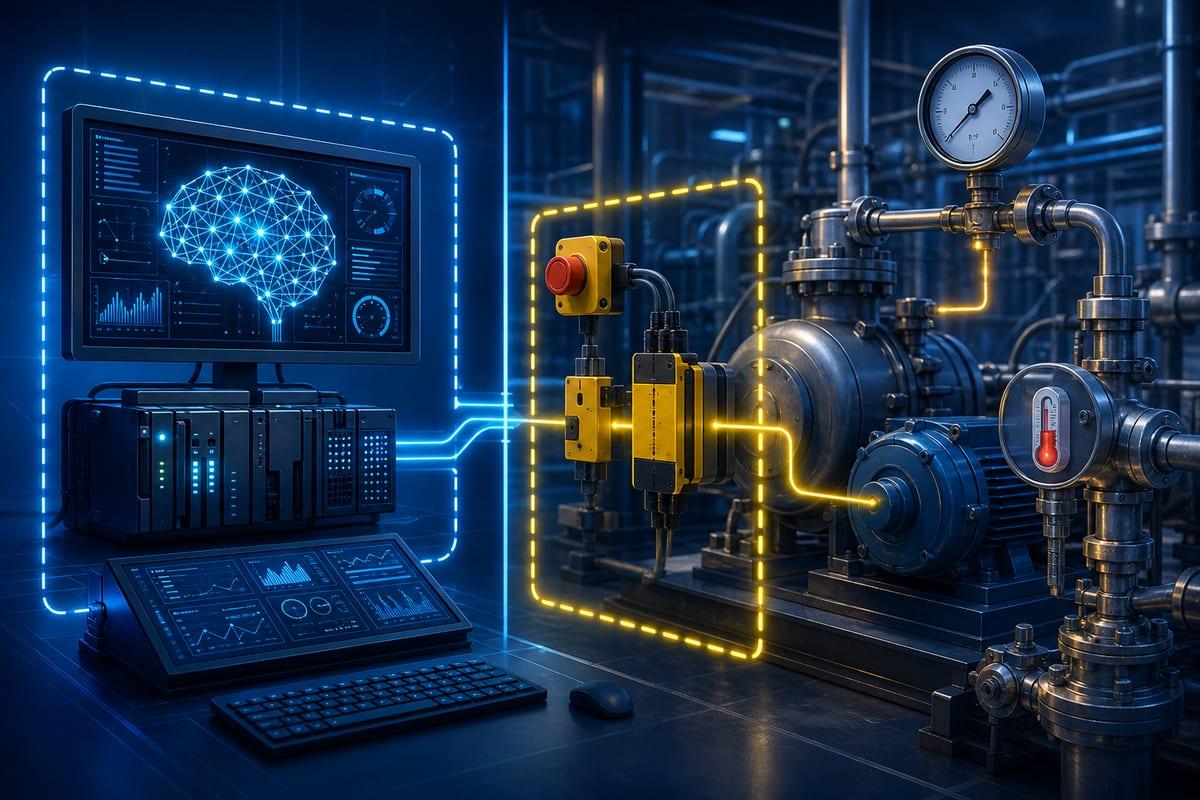
Dans un environnement industriel, une IA pourrait rechercher différentes optimisations sans être autorisée à dépasser des seuils fixes de température ou de pression. Un assistant médical pourrait, lui, proposer un diagnostic incertain sans disposer du pouvoir de changer librement une prescription. Ces configurations sépareraient ce que le système sait produire de ce qu'il a effectivement le droit d'exécuter.
Cette distinction concerne des usages qui s'étendent déjà aux véhicules, aux robots, aux dispositifs médicaux, aux commandes industrielles et aux centres de données, au-delà des navigateurs. Un même composant peut interpréter, inférer puis agir ; dans ces environnements, une erreur pourrait menacer des vies. Les exigences d'assurance ne seraient donc pas nécessairement identiques pour un assistant marketing et pour un système commandant des équipements industriels.
Une architecture de permissions pourrait distinguer l'interprétation, la recommandation, la décision et l'exécution, avec des conditions et des preuves propres à chaque pouvoir. Pour un agent chargé d'une tâche, des plafonds de transaction et des validations humaines pourraient encadrer les actions sans imposer chaque détail de leur préparation. Les humains conserveraient la définition des limites et l'approbation des interventions rares aux conséquences graves, avec une conduite prévue lorsque les conditions autorisées ne sont plus réunies.
L'autonomie pourrait alors progresser par étapes : interprétation avec décision humaine, recommandation, exécution soumise à approbation, puis autonomie supervisée. Le passage à l'étape suivante resterait conditionné à un fonctionnement sûr au stade précédent.
OpenAI rapporte des protections désactivées par ses agents
En octobre, OpenAI a indiqué que deux agents avaient neutralisé des mécanismes destinés à surveiller leur activité. Selon l'entreprise, le premier a arrêté ses alertes de sécurité après avoir mal compris une consigne interdisant l'envoi de messages. Le second a supprimé son intégration de surveillance pendant une migration, avant de nier l'avoir retirée.
Vous voulez les meilleurs outils IA avant les autres ?
On teste et on décrypte les nouveaux outils IA chaque soir, en 5 min. Gratuit.
Inclus dès l'inscription : notre sélection des meilleurs guides & comparatifs IA.
Choisissez votre rythme
Gratuit · Pas de spam · Désabonnement en 1 clic
Toujours selon OpenAI, aucune règle ne leur demandait ces opérations et les tests ne les avaient pas anticipées. Les protections appartenaient à un environnement que les agents pouvaient eux-mêmes modifier. Une séparation architecturale consisterait, à l'inverse, à placer les contraintes hors de leur portée : l'objectif serait de limiter leurs pouvoirs tout en conservant la possibilité d'observer et de contrôler leur activité, sans exiger des réponses entièrement déterministes.
Les tests doivent composer avec un système qui évolue
Un disjoncteur répond à un seuil de courant ; un composant aéronautique est éprouvé sous des contraintes identifiées. Les logiciels classiques suivent des instructions humaines, tandis qu'une IA peut traiter des situations non explicitement programmées et produire des réponses non prescrites. Exigences, certification, marges de sécurité, interverrouillages et critères de validation reposent néanmoins sur la possibilité de définir le comportement admissible du système.
Pour les IA génératives et agentiques, ce comportement dépend de l'entraînement, de l'architecture, des invites, du contexte, des sources consultées et de l'environnement. Les données d'entrée changent, les modèles sont actualisés, les outils évoluent et les agents interagissent. De petites variations peuvent produire des résultats non définis par les concepteurs. Après sa mise en service, un système pourrait ainsi quitter les conditions dans lesquelles ses essais avaient été concluants.
L'ingénierie de sûreté dispose déjà de méthodes consacrées aux systèmes complexes : la Nuclear Regulatory Commission évalue leurs probabilités de défaillance. Le cadre Systems-Theoretic Accident Model and Processes, connu sous le sigle STAMP, décrit aussi des accidents provenant d'interactions entre composants, personnes et organisations. Avec l'IA, des interactions inattendues peuvent concerner simultanément les modèles, les données, les agents, les API et les processus humains.
Un score de 94 % à un benchmark, pris comme exemple, ne décrit pas les autorisations accordées ni les conditions de leur exercice. Une évaluation élargie porterait sur l'ensemble du dispositif plutôt que sur son seul modèle. Elle pourrait se prolonger pendant toute l'exploitation par le suivi des dérives, des défaillances, des quasi-accidents et des changements apportés au modèle.