Un agent de codage comme Claude Code repose sur une boucle d'appels API intégrée dans un cadre logiciel. Voici ce que cela implique concrètement, des prérequis à l'exécution locale, ainsi que les mécanismes d'outillage, de dialogue avec les modèles et les limites de contexte et de mémoire.
Exécuter l’agent en local avec un seul fichier Python
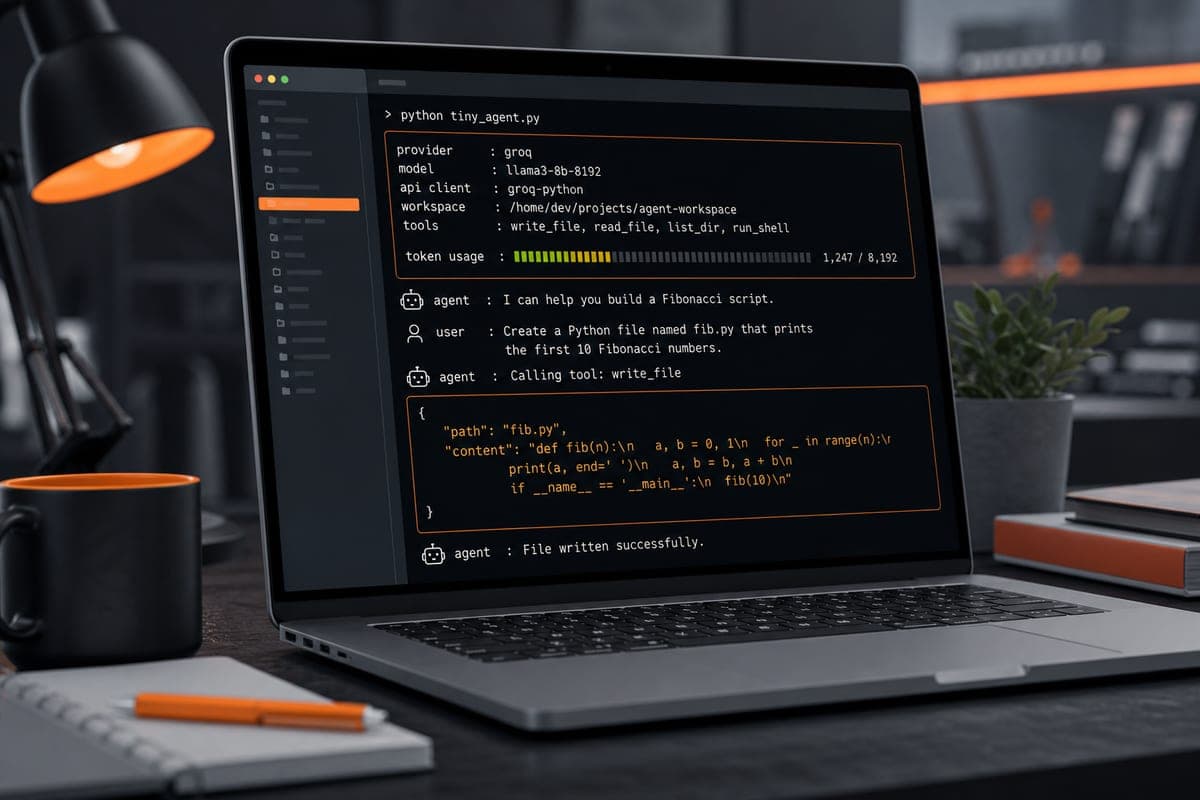
Un agent minimal tient dans un unique fichier, tiny_agent.py. Il nécessite Python 3.10 ou une version plus récente et n'ajoute aucune autre dépendance. La configuration peut passer par un fichier .env avec AGENT_PROVIDER=groq et une GROQ_API_KEY, ou se faire sans clé en tirant un modèle local via Ollama (ollama pull qwen3:4b) puis en lançant python tiny_agent.py -p ollama. Le même client peut cibler plusieurs fournisseurs, dont Groq, OpenRouter, NVIDIA ou un moteur local, en ne modifiant que les paramètres requis. En session, l'interface signale le fournisseur groq, le modèle openai/gpt-oss-120b, le mode ask et une estimation comme ~8/16 000 tokens disponibles. Elle affiche un workspace, propose /help pour les commandes et exit pour quitter. Un ordre tel que « créez fib.py qui imprime les 10 premiers nombres de Fibonacci, puis exécutez-le » peut conduire l'agent à produire un appel d'outil write_file avec des arguments JSON path et content. Le programme s'organise autour de cinq petites classes surmontées d'une ligne de commande fine.
Ce qui fait un agent: boucle, outils, règles, mémoire et interface
La différence entre un simple chatbot et un agent réside dans la capacité d'appeler des outils. Un modèle ne fait que générer du texte : il ne lit pas un fichier ni n'exécute une commande par lui-même. Les outils sont décrits au modèle sous forme JSON, avec leur nom et les paramètres attendus. Lorsqu'il décide d'en user, le modèle retourne un JSON structuré au lieu d'une réponse ordinaire ; le code hôte exécute alors la fonction réelle et lui renvoie le résultat comme message d'outil, que le modèle lit avant de décider de la suite. En pratique, un agent s'apparente à une boucle while autour d'un appel API, le reste relevant des garde-fous, de la mémoire, et d'une interface. Un même modèle peut se comporter très différemment selon ce cadre : la sélection des outils, ce qui entre dans le contexte et les règles d'autorisation conditionnent les résultats.
La recherche en IA vous passionne ?
Les papers et avancées qui comptent, expliqués simplement, chaque soir. Gratuit.
Inclus dès l'inscription : notre sélection des meilleurs guides & comparatifs IA.
Choisissez votre rythme
Gratuit · Pas de spam · Désabonnement en 1 clic
Dialoguer avec les modèles: JSON standard et fournisseurs interchangeables
L'échange avec un modèle hébergé se fait par une API web : un JSON envoyé, un JSON reçu. Un exemple concret est un POST vers https://api.groq.com/openai/v1/chat/completions avec une autorisation Bearer, un nom de modèle et une liste de messages. Le format dit OpenAI chat completions est accepté par de nombreux fournisseurs, rendant le client largement portable. Changer de fournisseur se limite à trois éléments : l'URL, la clé API et le nom du modèle. Les niveaux gratuits imposent des limites de taux par minute ou par jour ; au-delà, le service peut renvoyer 429 Too Many Requests et un en-tête Retry-After avec un délai à respecter. Un client robuste attend ce délai puis réessaie au lieu de s'interrompre.
Les modèles de langage prédisent chaque token de manière séquentielle
Un grand modèle de langage comme Claude, Gemini ou GPT ne fait qu'une chose : prédire le prochain token. Les systèmes manipulent des tokens plutôt que des mots ; on peut retenir qu'un token correspond en moyenne à environ trois quarts d'un mot anglais, qu'un millier de mots équivaut à environ 1 300 tokens, et qu'une règle d'ordre de grandeur tient à quatre caractères par token. La quantité d'information utilisable en une fois dépend de la fenêtre de contexte : instructions, échanges, fichiers lus et sorties d'outils doivent tenir ensemble pour être pris en compte. Ce qui n'y figure pas est invisible au modèle. Entre deux appels, le modèle n'a aucune mémoire, ce qui décale la responsabilité de la mémoire vers l'application. Les conversations longues coûtent davantage, car réexpédiées en entier à chaque requête, et finissent par dépasser la fenêtre disponible, imposant de résumer ou d'écarter des éléments.