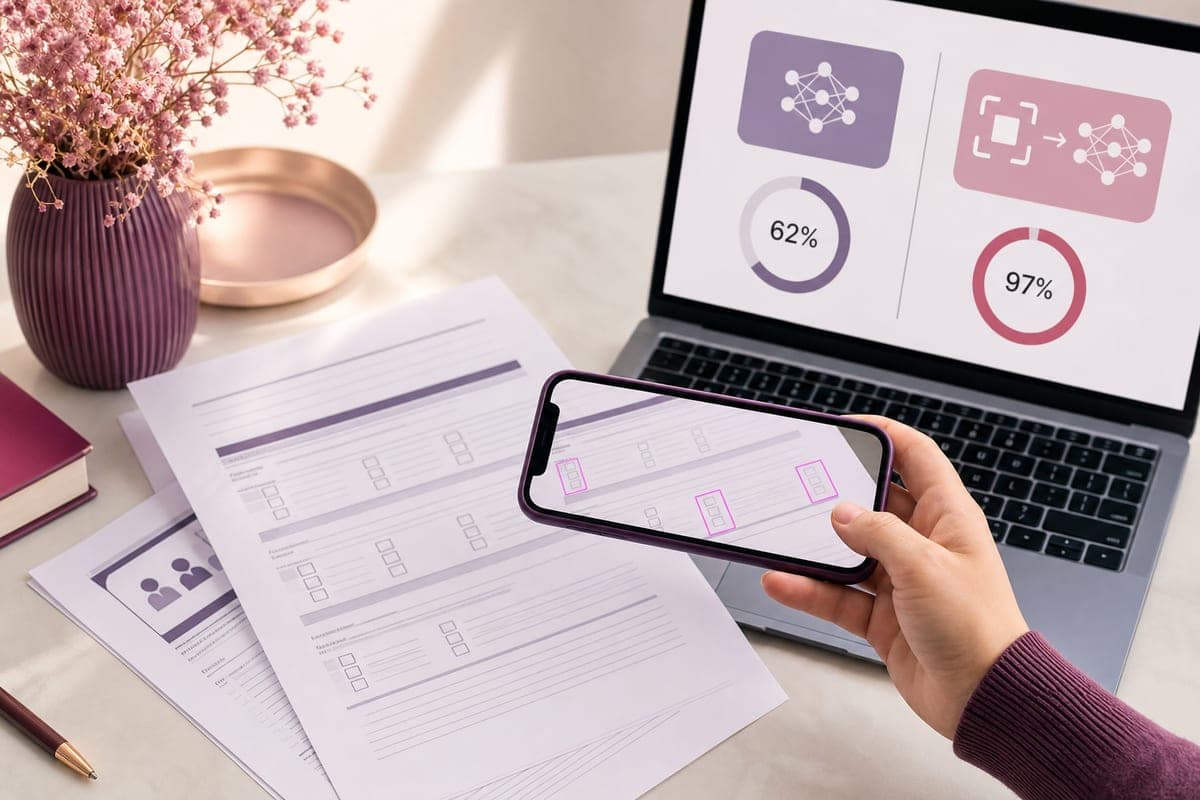
Un développeur a conçu PaperKit, une application qui sépare détection et compréhension pour remplir des formulaires. Sur des mises en page jamais vues, l'ajout d'un détecteur en amont d'un modèle de vision porte la détection de cases vides à 97 %, contre 62 % pour le modèle seul. L'auteur détaille une exécution réelle, tout en pointant des échecs marginaux et des incertitudes d'évaluation.
Limites reconnues et cas concrets d’échec
L’auteur signale plusieurs échecs observés en pratique : des cases mal alignées, des sections entières sautées, une dérive sur des mises en page non vues et des ambiguïtés sur les formulaires à deux parents. Il précise que l’ensemble de réglage utilisé est de petite taille, qu’un seul modèle de référence a été correctement testé et qu’une évaluation plus approfondie reste nécessaire. Une exécution réelle sur un formulaire de garde d’enfants en Floride est décrite, avec des indications sur les temps et les coûts associés.
Approche retenue : séparer localisation et étiquetage
Remplir un formulaire nécessite d’identifier la nature de chaque champ et de localiser précisément sa position. Pour cela, PaperKit fait appel à un détecteur abordable qui génère un grand nombre de cases potentielles, quitte à en proposer davantage afin de ne pas en oublier. Un modèle de vision associé à un LLM passe ensuite en revue chaque proposition et assigne à chacune un type de champ ainsi qu’une propriété, pendant que le téléphone assure le remplissage. L’application a été développée à l’aide de Claude Code, et un assistant IA a pris en charge les tests sur le portable de l’auteur tout en participant à la rédaction du brouillon.
La recherche en IA vous passionne ?
Les papers et avancées qui comptent, expliqués simplement, chaque soir. Gratuit.
Inclus dès l'inscription : notre sélection des meilleurs guides & comparatifs IA.
Choisissez votre rythme
Gratuit · Pas de spam · Désabonnement en 1 clic
Comparaisons sur pages tenues de côté et résultats chiffrés
Une évaluation a été réalisée sur des pages modifiées et mises de côté entre une méthode reposant uniquement sur le modèle et le pipeline combinant détecteur et modèle. La méthode basée uniquement sur le modèle montre des résultats décevants pour l’identification des cases à cocher et le positionnement exact des boîtes, tandis que le pipeline affiche une bien meilleure précision, atteignant 97 % de détection des cases vides lorsque le détecteur intervient avant le modèle. Sur des formulaires inconnus, le modèle de vision seul identifie 62 % des cases vides, contre 97 % avec détecteur en amont. L’auteur a créé l’application et indique que les chiffres et captures d’écran proviennent de véritables exécutions. Il rapporte qu’un formulaire scolaire a pris 30 minutes à remplir manuellement et qu’une approche IA générique a manqué 4 cases sur 10 lors d’un essai.