Un cadre d’évaluation des modèles de langage en Python, structuré autour de quatre modules, vise à combiner des métriques standardisées et des critères adaptés à chaque usage. Il reçoit un accueil favorable et pourrait, s’il se diffuse, rapprocher les pratiques d’évaluation entre acteurs.
Vers une adoption favorable et une possible standardisation
L'accueil réservé aux cadres d'évaluation personnalisés est décrit comme globalement positif. Des spécialistes de l'intelligence artificielle insistent sur la nécessité d'outils adaptés aux particularités des modèles de langage, et des forums ainsi que des conférences mettent cette approche en avant. À plus long terme, d'autres organisations, y compris des entreprises concurrentes, pourraient développer leurs propres dispositifs. Cette dynamique pourrait conduire à une standardisation des pratiques d'évaluation, facilitant la comparaison entre différents modèles et approches.
Quatre modules en Python pour structurer l’évaluation
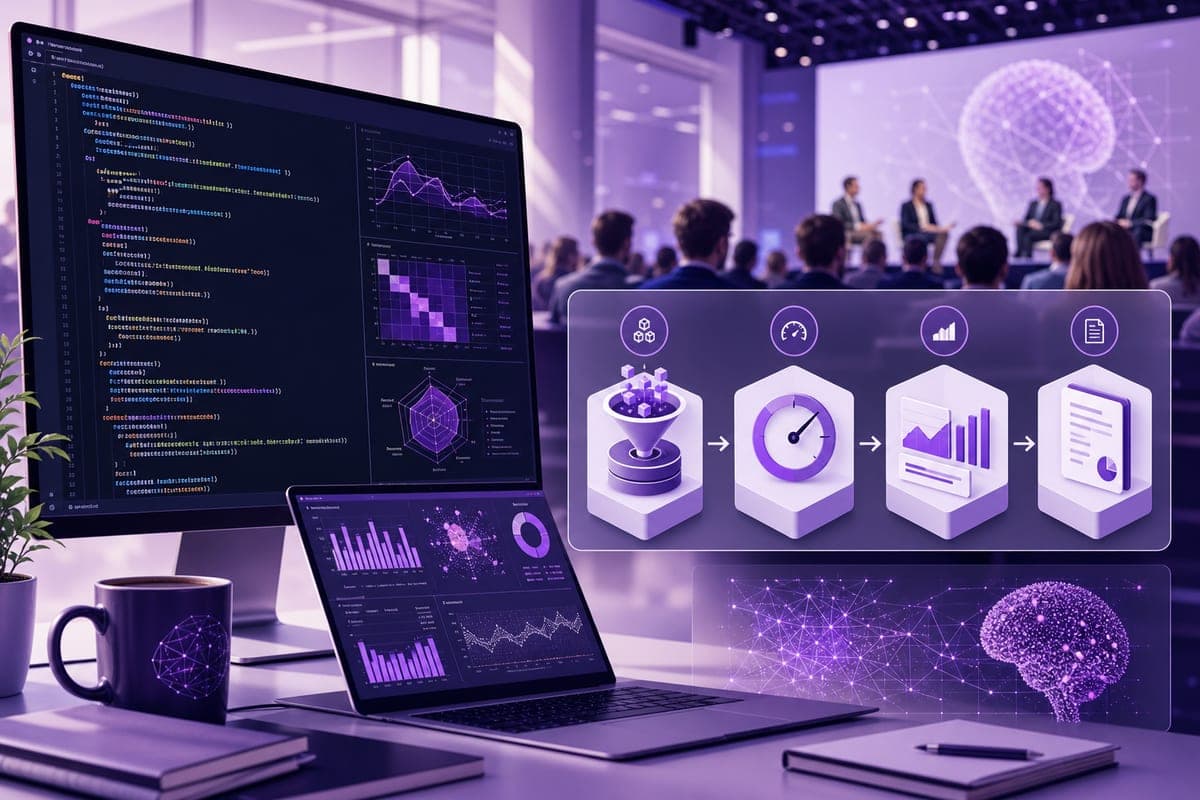
Ce cadre s’appuie sur une structure modulaire en Python, pensée pour pouvoir être ajustée selon les spécificités de chaque projet. Il se compose de quatre modules essentiels : un module dédié au prétraitement des données, un autre à l’évaluation des performances, un troisième à la visualisation des résultats et un dernier à la production automatique de rapports. Le module de prétraitement a pour fonction d’optimiser les données d’entrée destinées au modèle à tester, tandis que l’ensemble du dispositif autorise une évaluation des modèles selon des critères à la fois standards et propres à chaque application.
La recherche en IA te passionne ?
Les papers et avancées qui comptent, expliqués simplement, chaque soir. Gratuit.
Inclus dès l'inscription : notre sélection des meilleurs guides & comparatifs IA.
Choisis ton rythme
Gratuit · Pas de spam · Désabonnement en 1 clic
Métriques mobilisées et gains de fiabilité rapportés
Pour mesurer les performances des modèles de langage, le module d’évaluation s’appuie sur des indicateurs établis comme la perplexité et le score BLEU. D’après plusieurs études, recourir à des cadres d’évaluation sur mesure permettrait d’augmenter la fiabilité des modèles de 20 à 30 %. Ce gain est considéré comme particulièrement important dans des domaines tels que la santé, la finance ou l’éducation, où l’exactitude des modèles revêt un caractère crucial.
Qualité, transparence et exigences d’usage
Les sociétés qui mettent en place ce genre d’outil peuvent voir la qualité de leurs produits progresser, ce qui peut entraîner une hausse de la satisfaction des clients et une diminution des risques associés à des décisions appuyées sur des modèles défaillants. Ce cadre d’évaluation peut également favoriser la transparence des modèles de langage, en mettant à disposition des résultats lisibles et accessibles qui facilitent la justification des choix technologiques et renforcent la confiance des utilisateurs. Dans un contexte de préoccupations éthiques et réglementaires croissantes, les développeurs et chercheurs sont encouragés à partager leurs retours d'expérience et à contribuer à l'amélioration continue du cadre. La nécessité d'évaluations rigoureuses et adaptées devrait s'accentuer avec l'évolution et l'intégration des modèles de langage, et la création d'un tel cadre est présentée comme un enjeu majeur pour l'avenir de l'intelligence artificielle.