Tu veux les meilleurs outils IA avant les autres ?
On teste et on décrypte les nouveaux outils IA chaque soir, en 5 min. Gratuit.
Inclus dès l'inscription : notre sélection des meilleurs guides & comparatifs IA.
Choisis ton rythme
Gratuit · Pas de spam · Désabonnement en 1 clic
GitHub a introduit des garde-fous contre les pull requests automatisées, symptôme d’un volume inédit de contributions générées par des modèles. En réponse, une approche se dessine : donner aux agents des postes de travail isolés, les encadrer via un kanban à deux portes d’approbation et déplacer l’effort humain vers la lecture de spécifications. L’organigramme, plutôt que l’« essaim », sert de boussole pour orchestrer ces collègues non humains.
GitHub restreint les flux : désactivation des PR et limites comptant l’IA
En février 2026, GitHub a introduit un paramètre permettant de désactiver complètement les pull requests ou de les limiter aux collaborateurs disposant d’un accès en écriture. L’équipe produit a qualifié le problème visé de « saleté d’IA à grande échelle », évoquant des mainteneurs submergés par des soumissions de faible qualité générées par des modèles, rapides à produire mais longues à examiner. GitHub a ensuite instauré des plafonds sur le nombre de pull requests qu’une personne peut ouvrir, en précisant que celles créées par Copilot ou d’autres agents IA sont incluses dans ce calcul. D’ici juin, des restrictions similaires ont été appliquées aux issues. Selon l’auteur, le volume de travail généré par l’IA déplace le goulot d’étranglement vers l’attention humaine disponible, et non plus vers la vitesse de production.
Quand l’IA code, l’humain arbitre : cas Bun et déplacement du goulot
Bun, décrit comme un environnement d’exécution JavaScript désormais détenu par Anthropic, illustre ce déplacement : son créateur a constaté que des milliers d’issues ouvertes sur GitHub étaient déjà formulées comme des requêtes pour un agent, et a proposé de les confier à Claude pour générer des pull requests, invitant publiquement à soumettre des bugs bien reproduits. Selon l’auteur, dans une équipe concernée, le problème ne disparaît pas mais se déplace vers la revue humaine. Cette équipe aurait déclaré ne plus écrire de code elle-même depuis des mois et avoir réécrit environ 960 000 lignes de Zig vers Rust en une semaine, principalement avec l’IA. Le goulot d’étranglement devient alors l’examen et la validation du travail produit.
Donner un poste à chaque agent : conteneurs Linux et supervision en direct
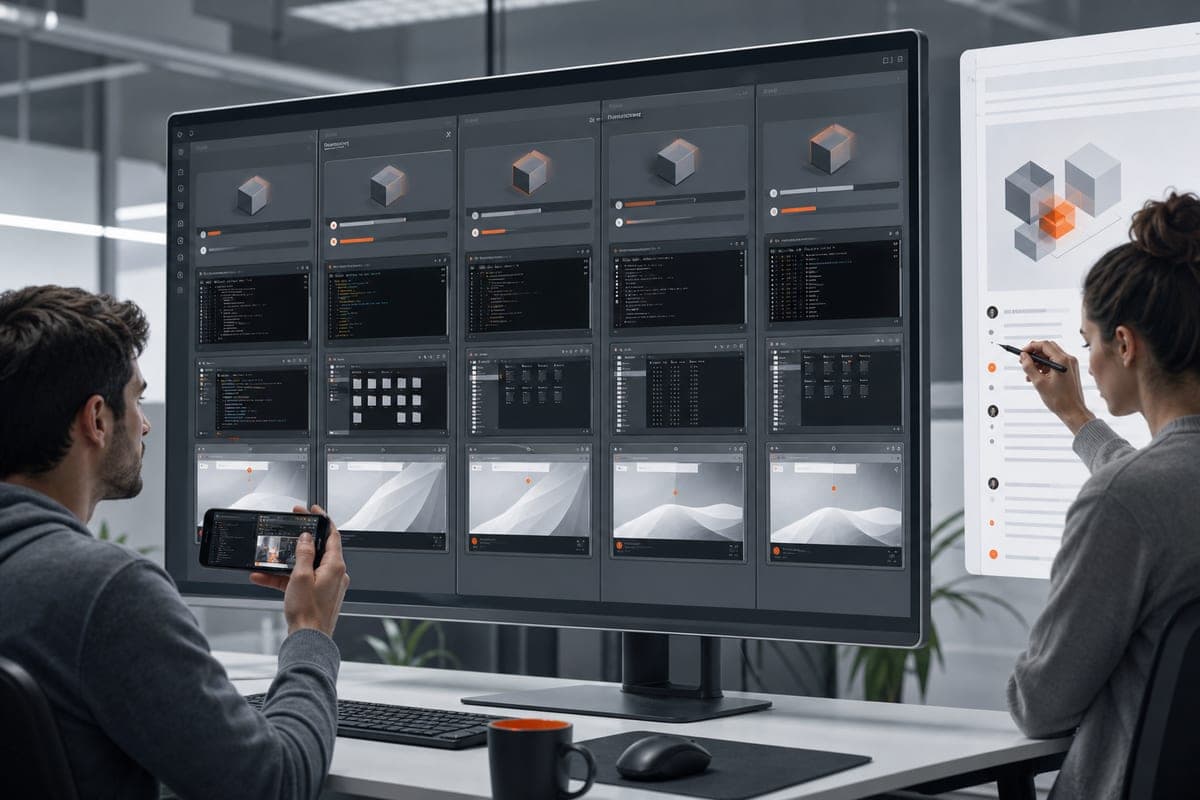
Une équipe suivie a constaté les limites de la cohabitation de plusieurs agents dans un même dépôt, avec des commandes destructrices lancées sans coordination. Elle a choisi d’isoler chaque agent dans un bureau virtuel distinct, sous la forme d’un conteneur Linux doté de son propre système de fichiers, navigateur, terminal et éditeur, où il peut installer ses dépendances. Le rendu, accéléré par GPU et utilisant des techniques de streaming proches du cloud gaming, permet d’observer l’activité en direct, y compris depuis un téléphone. Pour le développement front-end, le fait que l’agent puisse voir et tester ce qu’il construit dans un vrai navigateur est jugé essentiel. Ce modèle facilite aussi la relève entre fuseaux horaires et la compréhension de la base de code en observant la navigation de l’agent dans l’éditeur. Regarder le travail des agents aide à rester impliqué dans le processus d’ingénierie.
Du on-prem à un kanban à deux portes : spécifier, valider, coder, fusionner
Partie d’une solution on-premise pour exécuter des modèles sur serveurs internes, l’équipe a été amenée à se concentrer sur le codage, constatant que les outils existants étaient peu adaptés au travail en équipe. Elle a ajouté une couche kanban au-dessus des bureaux virtuels, chaque carte représentant une tâche de la taille d’une histoire utilisateur. Le cycle commence par une requête simple, puis un agent lit la base de code et rédige une spécification en trois parties : exigences, design technique, plan d’implémentation. Un humain valide la spécification, l’agent construit, puis une revue de code précède la fusion. Deux portes d’approbation structurent le flux : spécification et code. La première, courte et en Markdown, est destinée aux humains, tandis que la pull request peut s’étendre sur des milliers de lignes. Repérer une erreur tôt coûte moins cher. Pour faciliter cela, l’équipe a développé une vue collaborative permettant d’annoter la spécification ligne par ligne ; ces commentaires sont transmis à l’agent comme contraintes. Des ingénieurs décrivent leur activité principale comme la recherche des quelques lignes mal comprises dans ces documents.
Ce qui marche et ce qui coince : tâches cadrées oui, exploration non
Selon l’auteur, cette méthode fonctionne particulièrement bien pour des tâches avec un résultat clair. Dès que l’activité devient créative ou exploratoire, elle rencontre des difficultés.
Automatiser le processus, pas seulement le flux : l’organigramme plutôt que l’essaim
L’auteur situe la véritable limite dans les portes de décision qui jalonnent tous les métiers de l’information : collecter, décider, agir pour un manager ; construire, tester, approuver, livrer pour un quant. Il distingue le flux de travail, séquence fixe d’étapes, du processus, qui ajoute jugement et arbitrages pour atteindre un objectif plus large. Les outils d’automatisation traditionnels modélisent le premier, mais échouent dès que la suite dépend du contexte. À l’inverse, les grands modèles de langage répondent mieux à des objectifs de haut niveau, permettant d’automatiser des processus intégrant du jugement. L’auteur critique le modèle des essaims d’agents, qu’il juge sans contexte partagé ni amélioration globale, et propose de s’appuyer sur l’organigramme, modèle universel de délégation et de responsabilité, en y intégrant des collègues non humains. Cette vision s’inscrit dans un spectre d’adoption de l’IA, et dans l’idée de traiter les agents comme des entités à « embaucher », dans un contexte où le défi principal devient l’attention humaine et la vérification.