Fractile atteint 7 milliards de dollars de valorisation après une levée de 720 millions de dollars, quatre ans après sa création. Aucune puce n’est encore déployée en centre de données et les premières livraisons sont prévues en 2027. L’entreprise promet des temps de réponse divisés par dix grâce à une mémoire empilée, une affirmation qui attend des mesures indépendantes.
Un calendrier à 2027 et des preuves attendues avant tout déploiement
La valorisation de Fractile intervient avant la commercialisation de ses premières puces, dont la disponibilité est annoncée pour 2027. La société dépendra de fondeurs asiatiques pour la fabrication. À ce jour, aucune puce Fractile n’est en fonctionnement dans un centre de données. Les systèmes actuellement évalués par des benchmarks vérifiés comme MLPerf Inference de MLCommons concernent des offres Nvidia déjà en production commerciale. Il est donc nécessaire de distinguer les annonces des mesures réalisées en conditions réelles. En attendant, les équipes informatiques doivent conserver leurs serveurs existants et suivre le calendrier de Fractile, tandis que l’adaptation des outils logiciels à ces puces alternatives d’ici deux ans reste incertaine.
Un tour de table qui propulse la valorisation de 1,1 à 7 milliards de dollars
Le 11 novembre, Fractile a finalisé une levée de fonds de 720 millions de dollars, portant sa valorisation à 7 milliards de dollars. En mai, l’entreprise était valorisée 1,1 milliard de dollars. Basée à Londres et Bristol, Fractile a réuni CapitalG, Thrive Capital, Founders Fund, Lightspeed Venture Partners, Conviction et des fonds publics britanniques pour ce tour de table. Cette progression intervient quatre ans après la création de la société.
L’IA qui transforme le business ?
Stratégies, mouvements et levées IA décryptés, chaque soir en 5 min. Gratuit.
Inclus dès l'inscription : notre sélection des meilleurs guides & comparatifs IA.
Choisissez votre rythme
Gratuit · Pas de spam · Désabonnement en 1 clic
Le pari mémoire-empilée et la promesse de temps divisés par dix
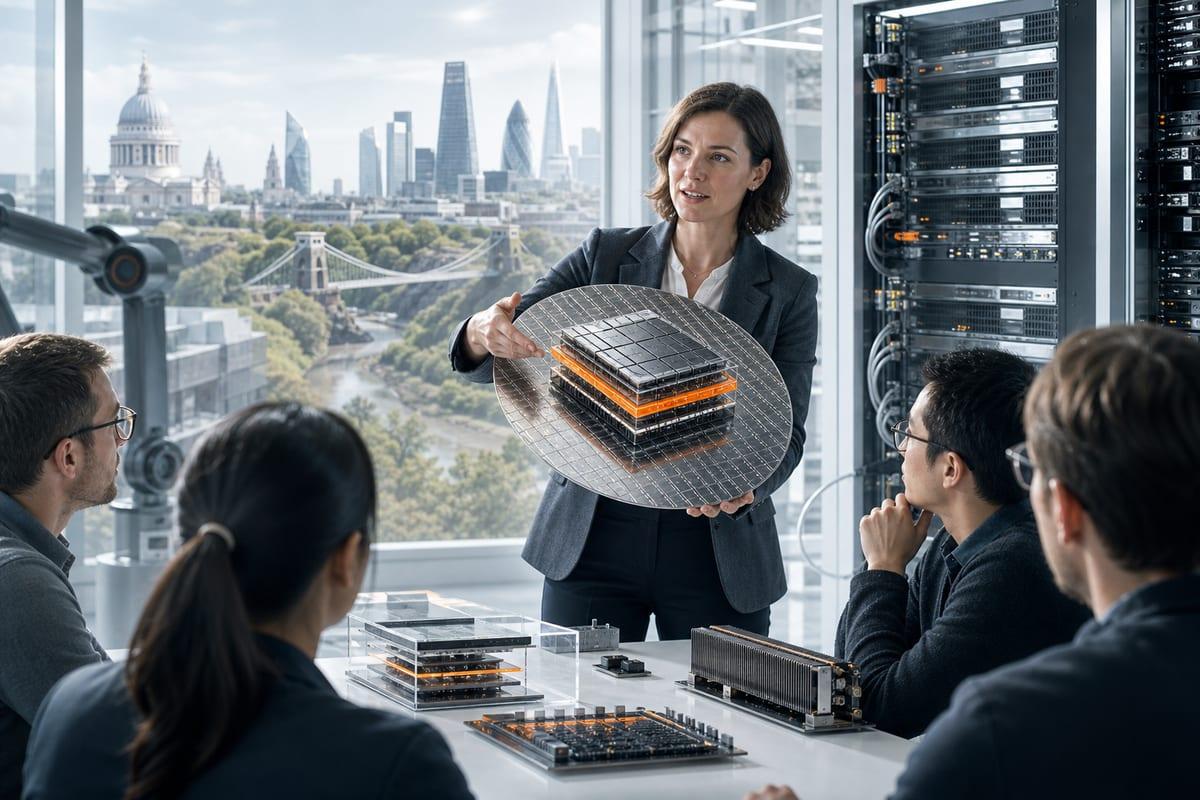
Fractile annonce une architecture qui empile la mémoire directement sur le silicium de calcul et promet de diviser par dix les temps de réponse, une affirmation qui relève d’une annonce fournisseur et reste à vérifier, notamment sur la stabilité thermique à grande échelle. L’exécution des grands modèles de langage sur les serveurs actuels nécessite de transférer en continu des milliards de paramètres entre unités de calcul et mémoire, un fonctionnement illustré dans la documentation Nvidia Blackwell et coûteux en énergie. Les GPU Nvidia actuellement disponibles sur le marché reposent sur une mémoire externe HBM et sont conçus pour assurer à la fois l’entraînement et l’inférence, alors que Fractile développe une puce spécifiquement dédiée à l’inférence des LLM. Walter Goodwin, fondateur de Fractile, met en avant que la puissance de calcul en virgule flottante des puces les plus performantes a été multipliée par un million en vingt-cinq ans, tandis que la bande passante mémoire n’a augmenté que d’un facteur quarante, ce qui aboutit à un différentiel de 25 000 fois. Ce choix technologique intervient dans un contexte où chaque requête d’inférence entraîne une consommation d’énergie et de matériel, et où réduire la dépense par réponse contribuerait à diminuer les coûts d’infrastructure sur plusieurs années. Toutefois, la rentabilité d’une puce spécialisée impose des conditions strictes : des modèles utilisés en continu à plus de 80 % de capacité et un amortissement matériel sur trois à cinq ans, avec un intérêt financier limité pour les tâches d’apprentissage automatique classiques sur des serveurs déjà amortis.