À SC26, Google Cloud détaille une approche agentique du calcul intensif combinant des compétences prêtes à l’emploi, une boucle d’optimisation AlphaEvolve sur Batch et un socle HPC/IA unifié. L’objectif affiché est d’encadrer les agents par des garde-fous opérationnels tout en leur donnant accès à des ressources de supercalcul et de stockage conçues pour des charges hybrides.
Un socle HPC/IA chiffré et unifié, du CPU aux TPUs
Google Cloud met en avant un stockage parallèle à latence sub-milliseconde avec Managed Lustre, annoncé jusqu’à 10 To/s en lecture, GPUDirect Storage via RDMA et un Dynamic Tier de 80 Po avec Cloud Storage Mirroring, pouvant être épaulé par un cache SSD local Cloud Storage FUSE. Côté calcul, des instances H4D à processeurs AMD EPYC 5e génération et Cloud RDMA, incluant des profils à 3 To de mémoire, ciblent les simulations MPI et les grands modèles d’ingénierie, tandis que des C4A basées Arm et propulsées par Google Axion cherchent un meilleur ratio performance/consommation. Pour l’accélération GPU, les A4 et A4X s’appuient sur NVIDIA Blackwell B200 et GB200 NVL72, et de nouvelles A5X bare metal bâties sur la plateforme NVIDIA Vera Rubin NVL72 visent l’entraînement et le raisonnement IA intensifs, quand les G4 à GPU NVIDIA RTX PRO 6000 Blackwell ciblent CAE, CFD et visualisation 3D. Les TPUs de 8e génération sont distingués entre TPU 8t pour le pré-entraînement, le RL et la ModSim, et TPU 8i pour le raisonnement à haut débit et l’inférence agentique ; Batch annonce par ailleurs l’exécution de tâches sur des tranches TPU à hôte unique. L’ensemble est orchestré dans un tissu matériel et logiciel unifié géré par Cluster Director pour des charges mêlant solveurs, modèles de fond de domaine et entraînement à grande échelle.
Des garde-fous intégrés pour opérer des agents en production
Le dispositif présenté encadre l’action des agents via des limites IAM, des quotas Kueue et des plafonds budgétaires. Chaque opération bénéficie d’une traçabilité complète dans Cloud Logging, et des compétences de dépannage structurées, dont gke-kueue-debugging, sont prévues pour corriger automatiquement des files d’attente bloquées ou des drains de nœuds. Google souligne que la robustesse de ces flux autonomes dépend directement de l’infrastructure qui les supporte.
Des compétences réutilisables adossées à Cluster Toolkit
Les déploiements HPC reposent sur Cluster Toolkit et des plans YAML déclaratifs, que Google associe désormais à des compétences d’agent composables et testées de bout en bout, diffusées via Google Skills et DeepMind Science Skills. Avant tout déploiement, une compétence effectue des audits de quotas calcul et stockage, des vérifications de capacité régionale, rattache la charge à un plan Cluster Toolkit validé et recueille une approbation humaine, puis lance gcluster deploy. Une fois le cluster prêt, des compétences de domaine guident la configuration d’OpenFOAM et de Siemens STAR-CCM+ pour la CFD, le réglage de pipelines GROMACS et AlphaFold 3, ou le lancement de simulations sous-surface avec Devito et OPM, avec une visualisation 3D directement dans le navigateur.
Vous voulez les meilleurs outils IA avant les autres ?
On teste et on décrypte les nouveaux outils IA chaque soir, en 5 min. Gratuit.
Inclus dès l'inscription : notre sélection des meilleurs guides & comparatifs IA.
Choisissez votre rythme
Gratuit · Pas de spam · Désabonnement en 1 clic
AlphaEvolve sur Batch pour évaluer des centaines de variantes
Développé par Google DeepMind, AlphaEvolve s’appuie sur Gemini pour faire évoluer de manière itérative du code et des paramètres 3D selon des métriques cibles. La déclinaison sur Cloud Batch vise à passer d’un prototype local à des campagnes d’expérimentation massives : un seul plan gcluster installe l’environnement contrôleur et Batch évalue en parallèle des centaines de candidats, sur VM uniques ou en groupes de tâches MPI multi-nœuds. Les chercheurs pilotent ces cycles depuis des notebooks Python hébergés ou les intègrent à leurs charges CLI et outils pilotés par agents. Google met en avant qu’une évaluation sur des instances avec Cloud RDMA et Managed Lustre, en combinant Spot VMs ou DWS pour équilibrer coûts et délais, permet d’identifier des algorithmes adaptés aux tissus de supercalcul et de réduire durablement le coût des exécutions futures.
Pourquoi encadrer les agents: limites des approches non guidées
Si les équipes R&D exploitent déjà des agents pour absorber la littérature, suggérer des optimisations et piloter des simulations, Google estime qu’un système agentique fiable en production requiert davantage qu’un modèle généraliste. Des agents non guidés peuvent mal assortir stockage et calcul, ignorer des règles de placement ou échouer au diagnostic d’incidents MPI multi-nœuds. L’initiative décrite consiste à formaliser l’ingénierie HPC dans des compétences réutilisables et à combiner Gemini, des compétences Cluster Toolkit, l’optimisation sur Batch et un matériel dédié afin de recentrer les équipes sur l’exploration scientifique.
SC26 à Chicago: démonstrations et ressources pratiques
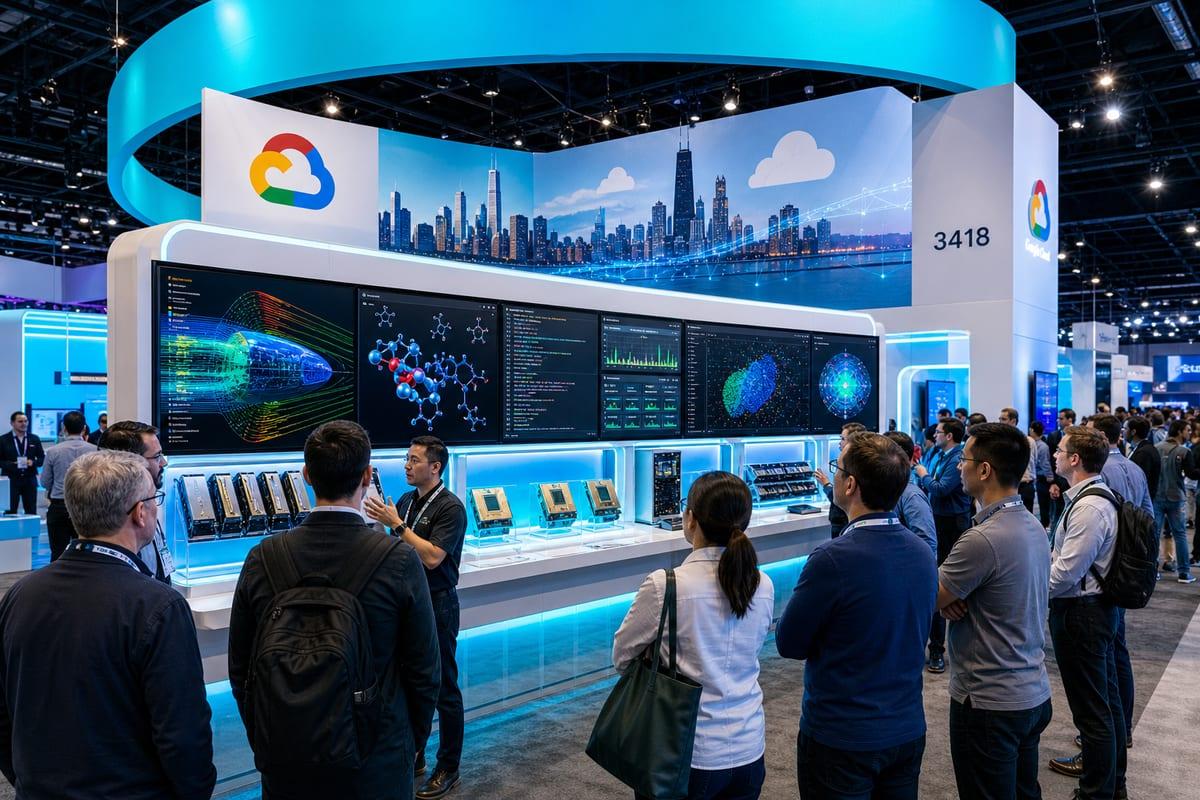
Les annonces sont présentées à SC26, au McCormick Place West à Chicago, du 15 au 20 novembre, sur le stand 3418. Des démonstrations portent sur Antigravity for HPC, le HPC Prompt Playground et AlphaEvolve for HPC, avec un atelier communautaire sur l’informatique avancée et une session Agentic and Hybrid HPC Birds of a Feather. Google met à disposition Cluster Toolkit et les solutions Google Cloud HPC, ainsi que des modèles validés à télécharger sur les dépôts Google Skills et DeepMind Science Skills.