Humanizer propose de réécrire localement du texte généré par l’IA, sans abonnement ni envoi vers un service tiers. Le développeur revendique des scores élevés face à Originality.ai, tandis que des essais décrivent des résultats fluctuants selon le contenu et les détecteurs. Le modèle s’exécute sur PC, avec application dédiée ou via des moteurs d’inférence locaux.
Des tests rapportent des résultats variables face aux détecteurs
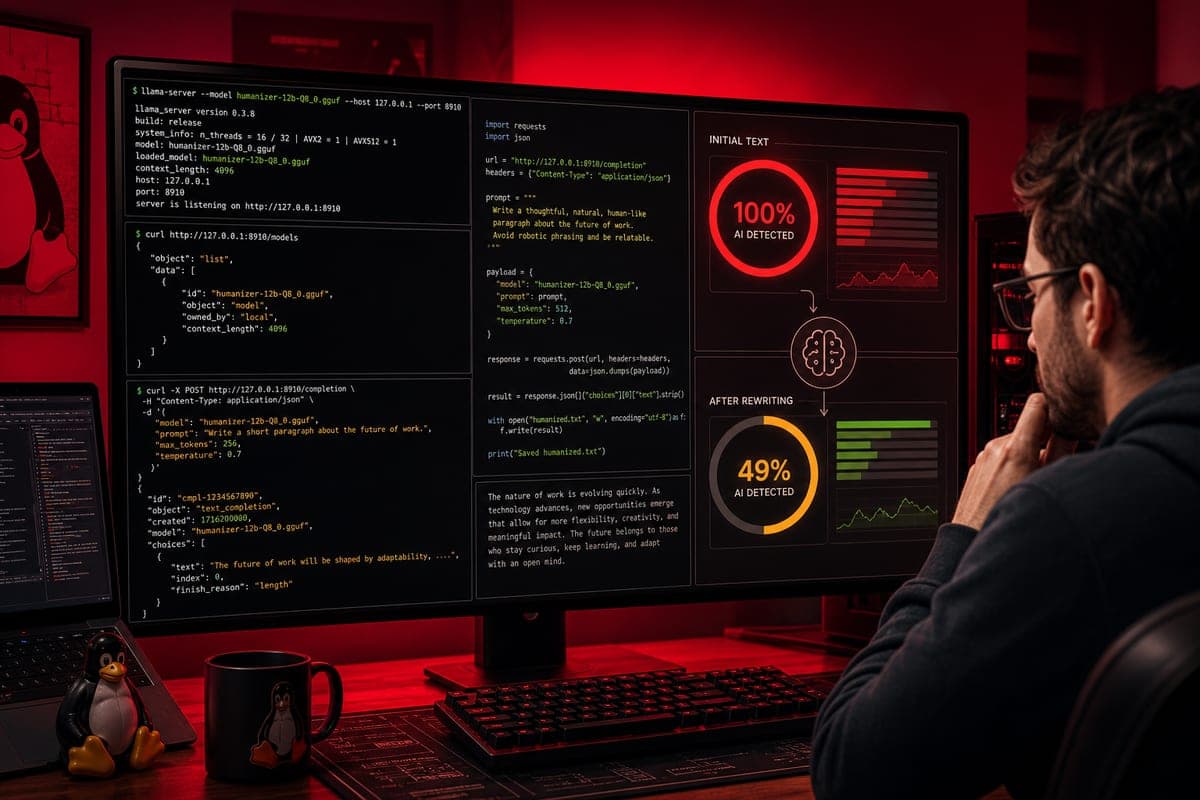
Sur un article d’environ 200 mots initialement jugé 100 % généré par l’IA par GPTZero, la réécriture via Humanizer a fait tomber la détection à 49 % et monter le score d’écriture humaine à 51 %. GPTZero est resté incertain, tout en indiquant que le texte serait probablement considéré comme humain. Des essais sur plusieurs textes générés par l’IA ont conduit à des classements jugés aléatoires par l’auteur du test, qui estime avoir 50 % de chances d’obtenir un bon résultat. Malgré le suivi des instructions et paramètres recommandés, ces performances n’ont pas été reproduites de manière cohérente par rapport aux chiffres annoncés. Les détecteurs d’IA pouvant produire des faux positifs, l’évaluation de l’efficacité d’un « humanizer » par leurs seuls scores reste incertaine. Le modèle peut par ailleurs introduire des erreurs factuelles et ses résultats varient selon les détecteurs.
Des promesses élevées revendiquées par le développeur
Le développeur affirme que 95 % des 210 réécritures en anglais ont été classées comme humaines par Originality.ai. Il attribue environ 93 % à la version quantifiée Q8_0. Ces performances ne font pas l’objet d’une vérification indépendante. Les chiffres avancés décrivent une capacité de contournement importante, mais restent des déclarations du développeur.
Conception du modèle et choix d’entraînement
Humanizer s’appuie sur une base Gemma 4 12B et totalise 12 milliards de paramètres. Il a été affiné pour réécrire des textes générés par l’IA dans un style plus naturel, en cherchant à préserver sens et faits. Son entraînement rassemble 28 598 paires IA-vers-humain provenant d’articles académiques, de rapports gouvernementaux, d’e-mails et de plateformes comme Reddit et Hacker News. Après un affinement supervisé, les développeurs ont appliqué une Optimisation de Préférence Directe avec 3 918 paires, puis une Optimisation de Politique Relative de Groupe, un LLM évaluant les réécritures selon l’exactitude factuelle, la copie inutile et les changements de sens. Aucun détecteur d’IA n’a été employé lors de la phase d’entraînement, la priorité ayant été donnée à la qualité rédactionnelle et à la cohérence des faits. Lors de la génération, le modèle modifie l’agencement des phrases, élimine les répétitions typiques de l’IA, varie la longueur des phrases et s’efforce de conserver les informations initiales.
Vous codez avec l’IA ?
Outils, agents et nouveautés dev IA décryptés, chaque soir en 5 min. Gratuit.
Inclus dès l'inscription : notre sélection des meilleurs guides & comparatifs IA.
Choisissez votre rythme
Gratuit · Pas de spam · Désabonnement en 1 clic
Exécution locale : application, moteurs pris en charge et quantification
Humanizer peut fonctionner localement sans abonnement ni appels d’API, soit via une application de bureau Windows et macOS utilisable hors ligne, soit à travers des moteurs d’inférence tels que llama.cpp, Ollama, Transformers, MLX ou vLLM. llama.cpp permet d’exécuter des LLM localement via une API HTTP exposée par llama-server. La version quantifiée 8 bits Q8_0 est disponible et présentée comme un compromis entre qualité et mémoire, la quantification réduisant les exigences matérielles. Q8_0 nécessite toutefois une VRAM substantielle, et une variante humanizer-12b-Q6_K est suggérée sur des GPU plus limités. Le serveur local publie notamment les endpoints /completion et /models.
Mise en place type avec llama.cpp et paramètres recommandés
Sur Linux avec NVIDIA CUDA, llama.cpp peut être compilé avec accélération GPU après récupération du dépôt. La construction de llama-server se vérifie via l’option --version, un exemple affichant built with GNU 13.3.0 for Linux x86_64. Les poids et le format de prompt s’obtiennent avec le client Hugging Face, puis le serveur se lance en chargeant le fichier .gguf et en liant l’hôte à 127.0.0.1. Des options permettent de décharger les couches sur GPU, de fixer une fenêtre de contexte à 8192 et d’activer Flash Attention. Le service écoute en local sur le port 8910, avec un endpoint /models pour vérifier le chargement. Un brouillon d’environ 200 mots est placé dans draft.txt et, dans le script humanize.py, le prompt officiel est concaténé au texte avant envoi vers /completion. Les paramètres incluent temperature à 1.0, repeat_penalty à 1.0, n_predict à 2048 et un top_p de 0.95, en cohérence avec les recommandations mentionnées. La requête JSON définit un timeout de 600 secondes et le résultat est sauvegardé dans humanized.txt. L’article utilisé pour le test traitait de l’exécution locale de modèles d’IA et avait été initialement détecté à 100 % comme généré par l’IA par GPTZero.
Adoption communautaire et périmètre d’usage
Début octobre 2026, Humanizer cumule plus de 143 000 téléchargements et 2 100 likes sur Hugging Face. Son exécution locale, sans abonnement ni appel d’API, en fait une option accessible pour réécrire des textes tout en gardant les données sur la machine de l’utilisateur.