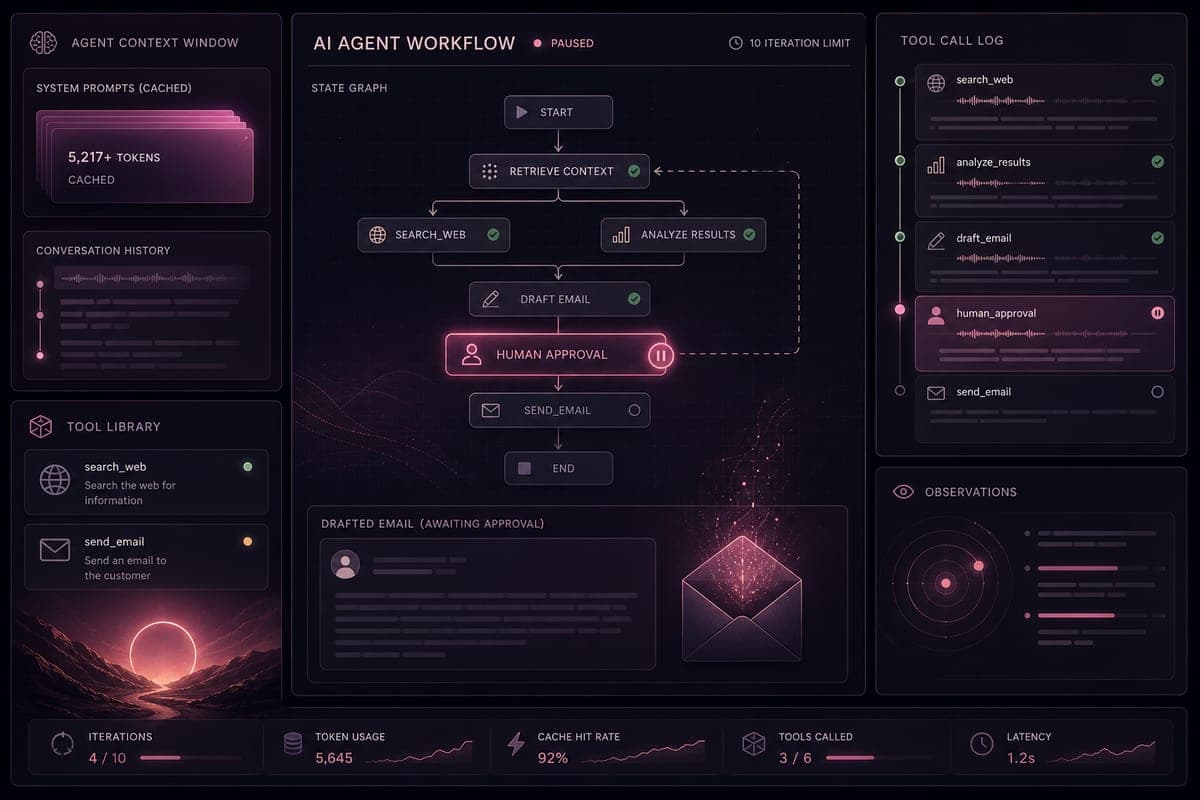
Déployer des agents IA en production ne relève pas d’une simple boucle autonome. Supervision humaine, décisions déléguées, gestion millimétrée du contexte et mise en cache conditionnent la sécurité et les coûts. Le modèle ReAct sert de fondation, mais ses promesses de flexibilité se paient en latence et en tokens.
Superviser avant d’exécuter : le passage obligé du HITL
Les applications d’entreprise ne délèguent pas des actions sensibles à des agents sans contrôle. Les modèles de langage étant non déterministes, toute opération autre que la lecture peut devenir problématique, comme supprimer une table SQL, autoriser un paiement ou expédier un e-mail à un client. Le mécanisme Humain dans la boucle interrompt explicitement l’exécution et attend un examen. Dans une implémentation de graphe d’état, par exemple avec LangGraph, l’invocation d’un outil précis peut stopper le graphe. L’état est sérialisé dans une base de données et l’exécution suspendue. Un examinateur vérifie alors la production (par exemple un e-mail rédigé), peut l’éditer, puis approuve pour que l’orchestrateur reprenne avec l’état validé.
Coût et latence : la mise en cache et l’élagage comme leviers
L’Ingénierie du Contexte est centrale pour la production. Le contexte d’un agent évolue en permanence, accumulant observations, erreurs et pensées intermédiaires. Charger systématiquement ces données gonfle la fenêtre de contexte, augmente la latence et les coûts, et peut faire perdre au modèle des éléments fins, avec des réponses inexactes pour des agents en aval. Des fournisseurs proposent la mise en cache de prompt : des instructions système et définitions d’outils, qui peuvent dépasser 5 000 tokens, sont placées en tête du contexte afin de réutiliser des états d’attention en cache clé‑valeur. Lors de boucles répétées, seules les nouvelles observations sont facturées, ce qui peut réduire sensiblement les coûts d’inférence. À l’échelle de la requête, l’élagage des observations évite qu’un document volumineux (comme une page HTML) ne sature la fenêtre. La compression des étapes passées, par exemple en résumant les 5 derniers résultats de recherche avec un modèle plus petit et moins coûteux, s’ajoute à ces gains.
Décider moins cher : déporter le déterminisme hors du LLM
Un système agentique doit trancher fréquemment sur la suite d’un flux de travail : étape suivante, délégation à un agent, outil à mobiliser, suffisance du contexte. Des modèles de décision calibrés et peu coûteux, tels que TypeSafe’s JEV, prennent en charge une partie de ces choix déterministes. Cette approche vise à laisser aux modèles de langage les tâches de raisonnement et de synthèse. En parallèle, les architectures s’éloignent des boucles d’agent unique vers des flux multi‑agents contraints, dans la lignée d’évolutions comme les topologies déterministes spécialisées illustrées par GraphRAG.
La recherche en IA te passionne ?
Les papers et avancées qui comptent, expliqués simplement, chaque soir. Gratuit.
Inclus dès l'inscription : notre sélection des meilleurs guides & comparatifs IA.
Choisis ton rythme
Gratuit · Pas de spam · Désabonnement en 1 clic
Quatre piliers à assembler : modèle, outils, contrôle et mémoire
Un agent repose sur un LLM de base, des outils, un mécanisme de planification et de contrôle, et une mémoire. Le modèle de langage sert de moteur de raisonnement et gagne à supporter nativement l’appel d’outils ou de fonctions, avec des exemples cités comme GPT-5, Claude 5.5 Sonnet ou Llama-4. Les tâches réalisables incluent l’utilisation de wrappers d’API (search_web, query_database, send_email) ainsi que d’interpréteurs Python fonctionnant dans un environnement isolé. Le contrôle s’exerce soit de façon stricte, par le biais d’une machine à états ou d’un DAG, soit de manière souple au moyen d’une boucle ouverte. La mémoire combine fenêtre de prompt à court terme et magasins de vecteurs pour les épisodes passés. Côté contexte, la projection d’état retire du prompt ce qui n’est plus utile, par exemple des journaux de recherche lorsqu’on passe à la rédaction. Des blocs de notes structurés en JSON ou XML rendent le raisonnement filtrable d’un tour à l’autre, tandis que la récupération sémantique ne ramène que les actions historiques pertinentes.
ReAct : fonctionnement, gains et limites opérationnelles
Le modèle ReAct alterne explicitement réflexion et action, enchaînant appels d’outils et observations jusqu’à une réponse finale. L’agent part d’un prompt système qui expose sa personnalité, ses outils et ses règles, puis boucle à chaque itération avec une pensée et une action, l’orchestration exécutant l’outil et retournant l’observation au modèle. Le contexte croît linéairement au fil des tours. Un pseudo‑code illustre une boucle bornée à 10 itérations, résumant les observations au‑delà de 2000 caractères, renvoyant les erreurs d’outils comme observations et arrêtant avec un message si la tâche n’aboutit pas. Les points forts incluent la flexibilité et la récupération d’erreurs, par exemple après une réponse 404 d’API. Les contreparties sont la latence et le coût, une requête pouvant nécessiter 10 appels séquentiels, avec une consommation notable de tokens même avec cache, et des risques de dérive ou d’hallucination sur des tâches complexes. ReAct est indiqué pour des tâches ouvertes orientées recherche, comme l’analyse de données, la recherche web approfondie ou le débogage en bac à sable, et est généralement déconseillé pour des conversations déterministes à faible latence exigeant des réponses précises.
Quand un seul agent ne suffit plus : séquencer et spécialiser
Au-delà d’un certain niveau de complexité, confier une tâche entière à une seule boucle ReAct n’est pas fiable. La décomposition en sous‑tâches et leur traitement par un flux de travail multi‑agent séquentiel permet d’assigner chaque étape à un agent spécialisé.