Tu suis la course aux modèles IA ?
Chaque sortie (GPT, Claude, Gemini, Mistral…) décryptée le soir même, en 5 min. Gratuit.
Inclus dès l'inscription : notre sélection des meilleurs guides & comparatifs IA.
Choisis ton rythme
Gratuit · Pas de spam · Désabonnement en 1 clic
TypeSafe AI propose avec Jev un modèle « System One » focalisé sur des décisions structurées et des probabilités calibrées. Des premiers retours vantent sa vitesse et son coût, tandis que l’éditeur revendique une méthode d’entraînement dédiée. Mais l’ampleur des preuves indépendantes sur sa précision reste limitée.
Les preuves publiques restent partielles et issues de sources limitées
Peu d’éléments techniques détaillés ont été rendus publics sur l’architecture, la configuration d’entraînement et la taille de Jev. Une partie des affirmations à son sujet repose sur des benchmarks communiqués par TypeSafe AI. L’éditeur indique un score d’environ 68% sur une évaluation de flux de travail interne, dont les références proviennent de modèles de pointe, et non de vérités vérifiées de façon indépendante. Des tests externes existent, mais restent réduits : un petit essai de vérification des faits rapporte 96,3% de précision et une autre évaluation sur 275 documents observe un fort accord sur certaines tâches. Ces exercices demeurent toutefois restreints. Les résultats avancés sont jugés prometteurs, mais ne suffisent pas à établir la précision générale, et des benchmarks indépendants supplémentaires sont attendus.
Décisions structurées et probabilités plutôt que texte libre
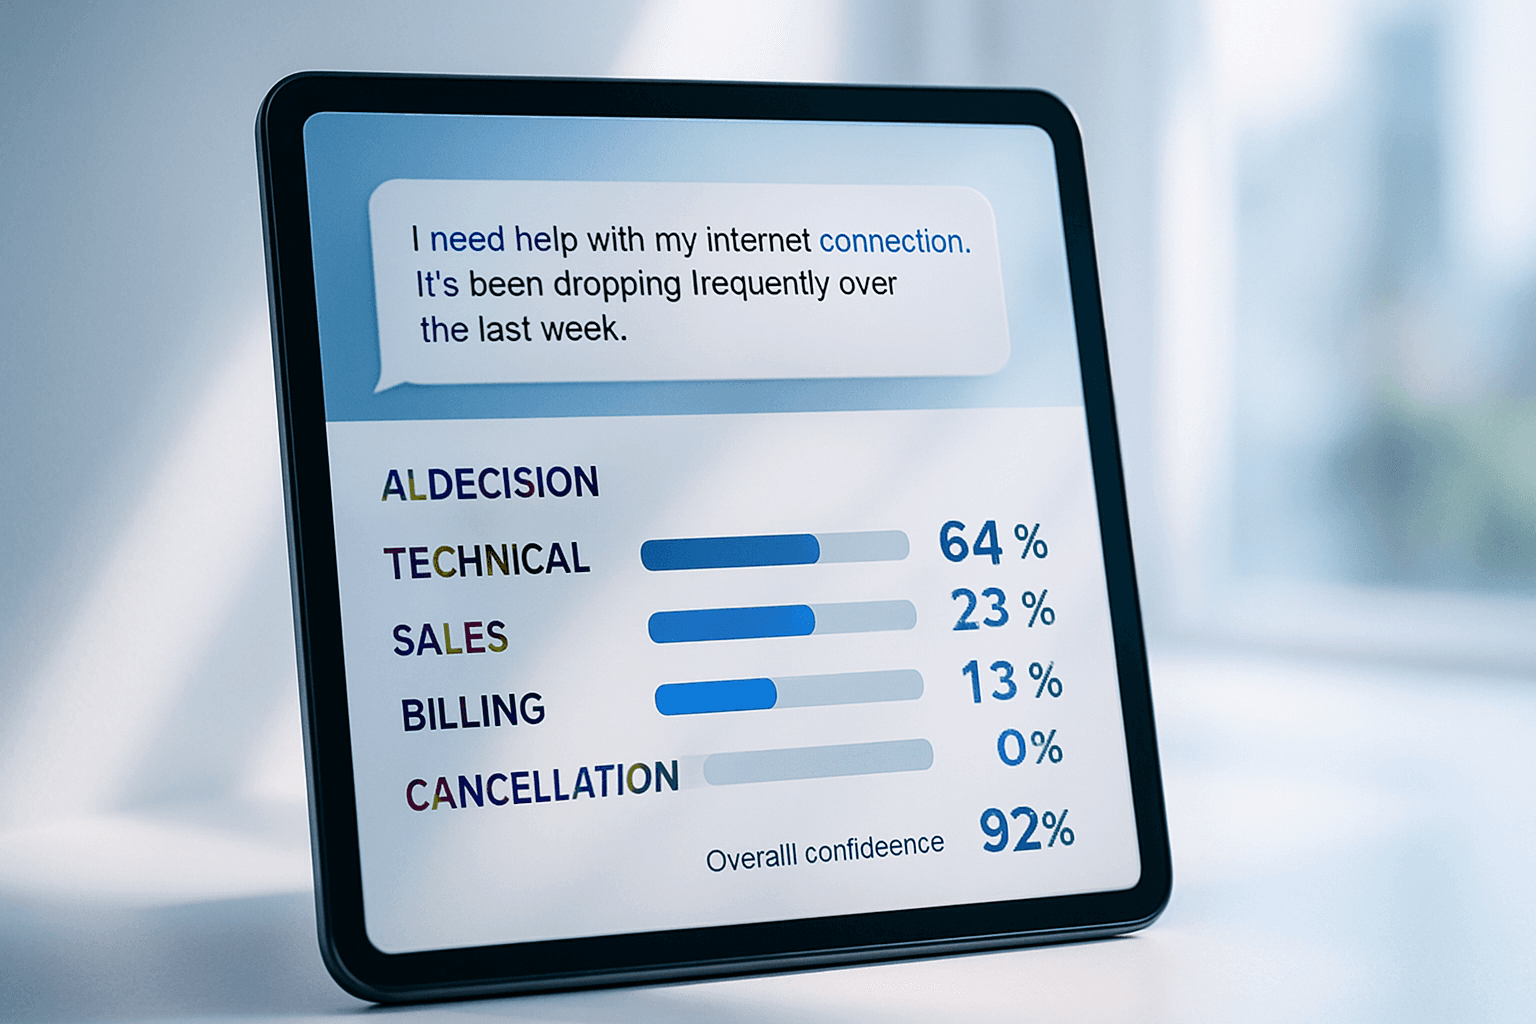
Jev est présenté comme un modèle dédié aux décisions rapides et structurées, à distinguer des modèles génératifs. TypeSafe AI le désigne comme un modèle System One, renvoyant une distribution de probabilité sur un ensemble fixe de choix au lieu d’une longue réponse textuelle. Un exemple de ticket de support illustre une répartition de 64% pour Technique, 23% pour Ventes, 13% pour Facturation et 0% pour Annulation, tout en matérialisant l’ambiguïté. Les probabilités guident l’usage applicatif, par exemple pour router automatiquement ou déclencher une revue humaine selon un seuil de confiance. L’approche concentre Jev sur la transformation du texte en décisions, avec un score de confiance global distinct des pourcentages par étiquette.
Vitesse et coûts : spécialisation et inférence parallèle
TypeSafe AI attribue la rapidité et le faible coût de Jev à une architecture spécialisée, un échantillonnage parallèle et un entraînement orienté calibration. La logique diffère de LLMs polyvalents, coûteux lorsqu’ils sont contraints pour des tâches de classification simples. Des précédents comme facebook/bart-large-mnli illustrent déjà l’intérêt de modèles ciblés pour la classification zéro-shot légère. Dans ce cadre, qu’un modèle spécialisé classe plus vite et moins cher qu’un modèle de pointe est attendu, l’enjeu étant la qualité effective sur les tâches visées.
RLCD : des probabilités censées refléter l’incertitude
TypeSafe AI affirme entraîner Jev avec RLCD, pour Apprentissage par Renforcement de Décisions Calibrées. L’objectif est que les probabilités alignent la confiance affichée avec la fréquence de justesse réelle. Un exemple mentionne des pourcentages par catégorie et un score de confiance global de 53%. Avec une calibration satisfaisante, les prédictions à confiance élevée devraient être correctes plus souvent. Cette propriété rend l’incertitude exploitable dans les logiciels, en permettant d’automatiser au-delà d’un seuil tout en escaladant les cas moins sûrs. L’éditeur oppose cette démarche à RLHF, qui vise des réponses préférées par des annotateurs humains.
Zéro hors schéma ne veut pas dire zéro erreur
Jev ne génère pas de catégories absentes des choix fournis : face à des options comme Facturation, Technique et Ventes, il ne retournera pas Juridique. En revanche, il peut se tromper en sélectionnant une alternative inexacte parmi les étiquettes proposées. L’expression « zéro hallucination » est donc comprise ici comme l’absence de sorties hors schéma, et non comme l’absence totale d’erreurs.
Des usages testés : routage, navigation et analyses à bas coût
Les applications visées incluent des décisions unitaires répétées telles que le routage, la classification, le scoring ou le choix d’action d’un agent. Un utilisateur, blackbarata, rapporte un routage entre agents spécialisés en 145 à 271 millisecondes. Un autre, TigerOk4538, mesure environ 1 seconde pour Jev contre 4 à 14 secondes pour un LLM structuré. Browser Use a conçu jev-ultrafast, où Jev choisit action et élément du navigateur ; une démonstration sur Google Flights a duré environ 7,1 secondes. Matthew Berman mentionne l’analyse de 724 annonces de 37 marques en environ 40 secondes, pour un coût proche de 0,09 dollar. Ces retours décrivent Jev comme une couche de décision intégrée à des systèmes plus larges plutôt que comme générateur final de réponses.
Positionnement face aux LLMs et aux classificateurs zéro-shot
Les tâches traitées par Jev, comme classification ou détection d’intention, sont établies de longue date. TypeSafe AI revendique une approche dédiée, décrite dans le cadre System One/Two, qui oppose décisions rapides et raisonnement délibératif. L’auteur rapproche Jev de la classification zéro-shot, popularisée sous sa forme NLI vers 2019–2020, tout en soulignant que TypeSafe AI met l’accent sur des décisions multiples, l’inférence parallèle et la calibration. Jev n’est pas positionné avec des modèles généralistes comme GPT, Claude ou Gemini, qui ciblent codage, raisonnement, outils et génération ouverte. La question centrale devient la proximité de qualité sur des tâches étroites pour envisager des remplacements d’appels à des modèles plus coûteux. L’auteur ne juge pas Jev révolutionnaire, tout en notant que le travail sur architecture, entraînement, inférence, calibration et expérience développeur peut en faire un produit solide.