La recherche vectorielle rapproche les idées, pas la vérité des faits. Un guide pratique détaille où la similarité cosinus déraille pour la mémoire d’agents, ce qu’il faut réellement indexer et comment l’activer dans un LangGraph. À la clé, des recommandations pour passer d’une mémoire bavarde à des rappels pertinents.
Activer l’indexation dans LangGraph et éviter le piège des épisodes non indexés
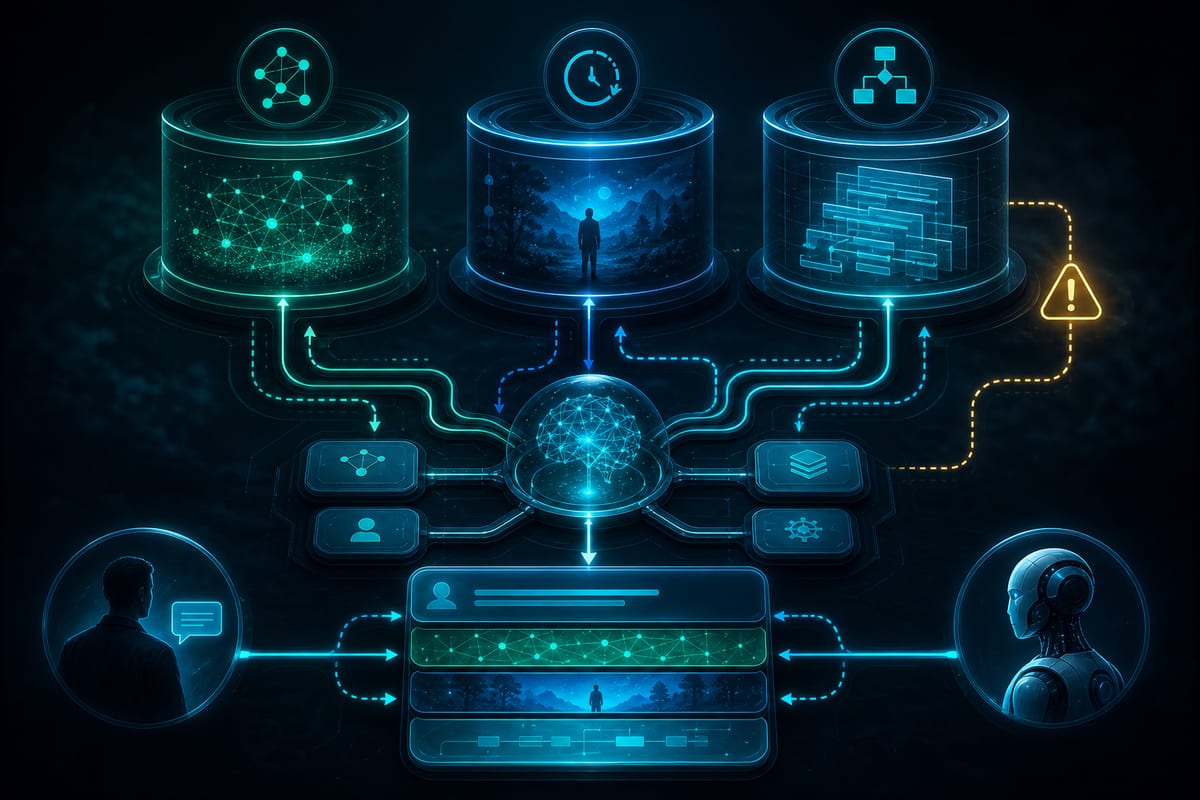
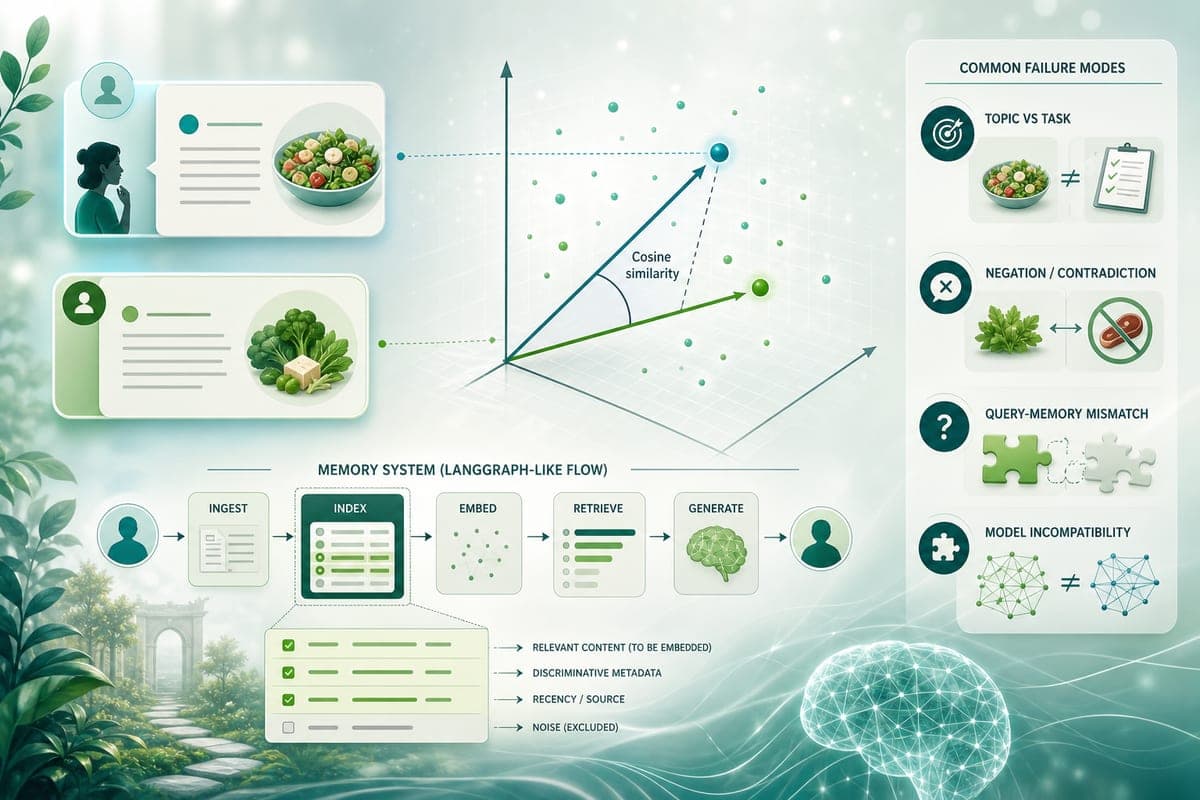
La recherche sémantique peut être activée dans un LangGraph via un index qui précise explicitement quels champs sont convertis en embeddings. Un agent existant est ensuite mis à niveau pour utiliser cette recherche indexée à la fois pour des faits et pour des épisodes, ce qui modifie la façon dont il récupère l’information. Un piège pratique est souligné lorsque des épisodes ne comportent pas de champ sélectionné pour l’indexation : ces contenus ne seront pas retrouvés sémantiquement. Un exercice propose par ailleurs d’évaluer la robustesse du dispositif face aux contradictions, de comparer du texte désordonné à des formulations distillées, et de mesurer la récupération d’épisodes récents par rapport à ceux effectivement indexés.
La recherche en IA vous passionne ?
Les papers et avancées qui comptent, expliqués simplement, chaque soir. Gratuit.
Inclus dès l'inscription : notre sélection des meilleurs guides & comparatifs IA.
Choisissez votre rythme
Gratuit · Pas de spam · Désabonnement en 1 clic
Quand la similarité trompe : quatre modes d’échec récurrents
La proximité dans l’espace des vecteurs répond à la question « de quoi parle ce texte ? », et non à la validité d’un fait récupéré. Quatre modes d’échec typiques sont décrits : une similarité thématique qui n’implique pas la pertinence pour la tâche, des erreurs liées à la négation ou à des contradictions de faits, des écarts entre l’embedding d’une requête et celui de la mémoire, et des incompatibilités entre modèles d’embeddings. Ces limites expliquent pourquoi une requête apparemment proche peut fournir un rappel inadapté ou erroné.
Ce qu’il faut indexer, illustré par l’exemple Priya
Un cas d’usage oppose la demande « Suggérez quelque chose pour le dîner ce soir » et un fait pertinent « Priya est végétarienne », sans mots communs ; une recherche par mots-clés échouerait à relier ces éléments, et injecter tous les souvenirs dans l’invite cesse d’être viable en passant de dix à mille éléments. Les embeddings convertissent le texte en vecteurs rapprochant les contenus sémantiquement similaires, classés typiquement par similarité cosinus. Pour rendre cette mémoire exploitable, il est recommandé d’indexer des déclarations distillées et autonomes, et pour les épisodes de cibler la situation ou la demande plutôt que le résultat. Ce cadrage améliore la récupération par similarité sans dépendre d’un chevauchement lexical.