Un module de mémoire ouvert de l’université de Stanford compresse des collections entières en 16 tokens injectés à un LLM gelé. Des gains sont observés sur FactKG et d’autres jeux d’essai, avec des cas défavorables comme PubMedQA. Le code et les checkpoints sont publiés sous Apache 2.0, mais l’exécution vise des GPU haut de gamme et les chiffres sont auto-rapportés.
Des résultats hétérogènes et des chiffres auto-rapportés
Memorilla se classe derrière sur trois benchmarks. Sur PubMedQA, le module atteint 59,00% quand LLMLingua-2 affiche 69,00%. Ce résultat fait aussi partie des plus faibles relevés, avec 59,00% rapportés face à 69,00% pour LLMLingua-2. L’équipe explique que les résumés de PubMedQA ne totalisent que 324 tokens, laissant peu de marge à la compression. MemoRAG garde l’avantage sur PersonalizationV4 (67,88% contre 66,65%) et sur NarrativeQA en ROUGE-L (20,51 contre 19,31), en mobilisant toutefois environ 690 fois et 50 fois plus de tokens de documents. Tous ces scores et comparaisons sont fournis par l’équipe de recherche, qui précise avoir évalué les baselines sur le même Qwen3-8B gelé.
Code publié sous Apache 2.0 et ressources disponibles
Le projet est accessible sous licence Apache 2.0, avec le code, les recettes d’entraînement et des points de contrôle mis en ligne, dont des checkpoints de 194 millions de paramètres hébergés sur Hugging Face. L’installation se fait via uv sous Linux avant un chargement avec MemoryVLLM.from_pretrained, un premier lancement téléchargeant environ 25 Go. PersonalizationV4, un corpus synthétique de 149 utilisateurs et 200 conversations chacun, est publié sous licence CC BY 4.0.
Ce que change la mémoire latente limitée à 16 tokens
Memorilla parcourt un stockage documentaire complet et livre au LLM gelé un résumé compact de 16 tokens, une taille fixe quelle que soit la collection. En transformant la collection en 16 vecteurs, l’objectif est de remplacer l’inclusion de documents entiers en contexte pour un Qwen3-8B gelé. Sur FactKG, ils rapportent 84,33% contre 80,43% pour le contexte complet, avec 108 fois moins de tokens de documents. Sur un H100, le système répond en 0,74 s avec 512 documents (environ 128K tokens), alors que le contexte complet s’étire de 0,75 s à 19,9 s, soit 27 fois plus lent dans ce cas ; le module de mémoire lui-même prend environ 2 ms.
Le pipeline en trois étapes et l’entraînement
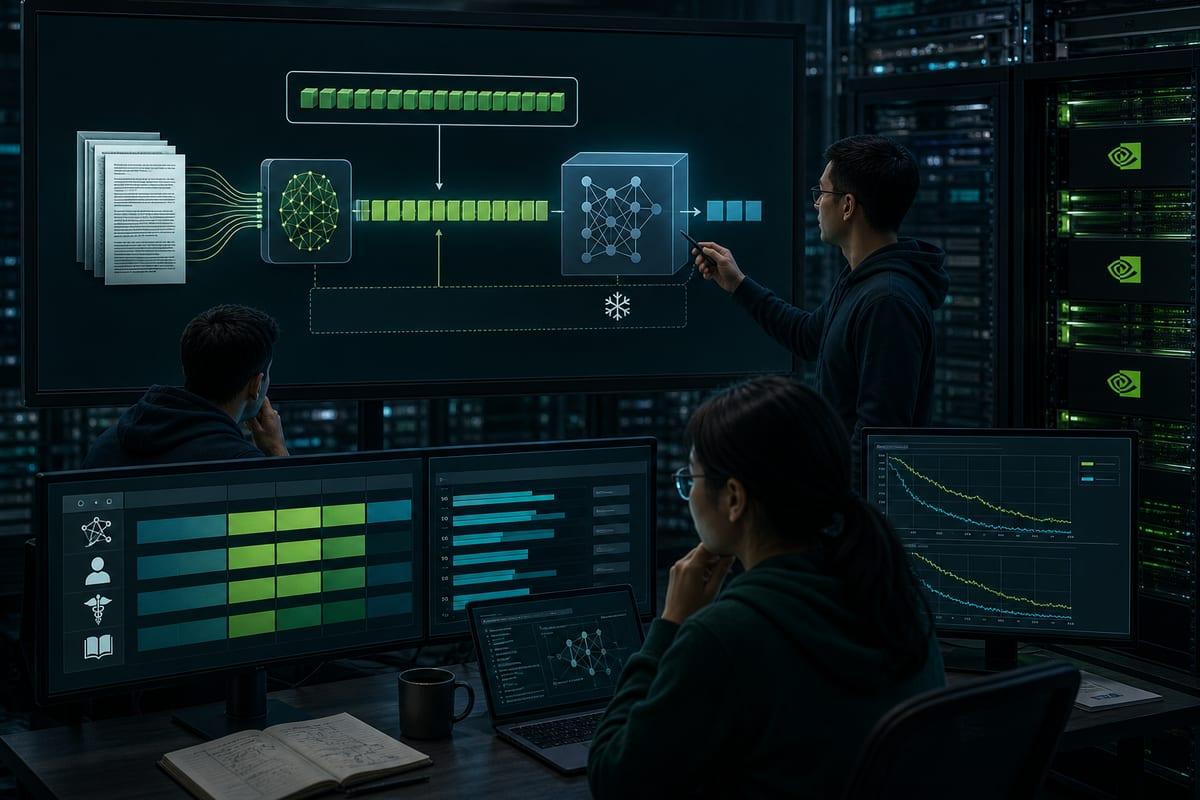
Le traitement suit trois phases. D’abord, un Qwen3-Embedding-4B gelé encode chaque document une fois, sans ré-encodage des anciens lors d’ajouts. Par la suite, seize slots appris se connectent à la question et à la mémoire via deux couches d’attention croisée à huit têtes. À l’étape suivante, ces slots sont transformés dans l’espace d’embedding d’entrée de Qwen3-8B et ajoutés en préfixe à la requête. Seul le module de mémoire fait l’objet d’un entraînement, comprenant 194 123 776 paramètres liés au décodeur 8B. L’entraînement s’organise en trois phases : environ 1,98 million d’exemples de reconstruction de paraphrases issus de Wikipedia, suivis d’environ 1,34 million d’exemples tirés de dix jeux de questions-réponses et de résumés, puis un affinement réalisé sur huit benchmarks. L’ensemble de la recette prend environ 19 heures sur quatre GPU H100.
Vous codez avec l’IA ?
Outils, agents et nouveautés dev IA décryptés, chaque soir en 5 min. Gratuit.
Inclus dès l'inscription : notre sélection des meilleurs guides & comparatifs IA.
Choisissez votre rythme
Gratuit · Pas de spam · Désabonnement en 1 clic
Bilan chiffré : moyennes, gagnants et perdants selon les cas
Au-delà de FactKG, Memorilla atteint 44,60% sur PersonaMem-v2 face à 30,90% pour xRAG et, dans une autre comparaison rapportée, 44,60% contre 27,92% pour le contexte complet. Sur TriviaQA, le score de 57,00 en correspondance exacte dépasse légèrement MemoRAG à 56,60. Sur LaMP-4 et LaMP-7, 18,15 et 48,37 en ROUGE-L sont relevés, les meilleurs scores. En moyenne sur huit benchmarks, Memorilla affiche 49,68 contre 41,92 pour xRAG, 40,75 pour LLMLingua-2 et 38,02 pour Mem0. Les tableaux comparatifs indiquent une consommation moyenne géométrique par requête de 16 tokens de documents pour Memorilla, 78 pour MemoRAG, 42 pour Mem0 et 121 pour xRAG. Les exactitudes sur FactKG se répartissent à 84,33, 80,38, 72,79 et 78,98 respectivement ; sur PersonaMem-v2 à 44,60, 28,76, 27,48 et 30,90 ; sur PubMedQA à 59,00, 67,00, 24,00 et 36,00 ; et sur NarrativeQA en ROUGE-L à 19,31, 20,51, 13,80 et 16,92. La compression culmine quand 16 tokens remplacent 67 385 tokens de documents sur NarrativeQA (réduction rapportée de 4 212x). En contexte agent, huit tokens de mémoire haussent le succès moyen d’un agent Qwen3-4B TextWorld de 18,6% à 24,2%.
Exécution, contraintes matérielles et options d’accélération
Le système cible Linux, des GPU compatibles CUDA et Python 3.11. Le démarrage rapide requiert un GPU de 80 Go, les recettes ayant été menées sur un H100 80 Go, et aucune variante quantifiée n’est fournie. En exécution, une latence de 0,74 s est relevée avec 512 documents sur un H100, quand le contexte complet monte jusqu’à 19,9 s. Un cache de mémoire optionnel pré-calcule les clés et valeurs d’attention : sur un B200, une requête dure 8,1 ms à 1M de documents et 33 ms à 4M, et descend à 5,0 ms à 1M avec torch.compile ; le cache nécessite 80 GiB à 4M de documents. Côté intégration, l’installation se fait via uv et les checkpoints se chargent avec MemoryVLLM.from_pretrained ; chaque point de contrôle doit être associé au décodeur correspondant, et les données personnalisées se présentent en fichiers parquet avec collection_id, question, réponse et documents.