L’API de décision d’OpenAI est désormais accessible à tous les clients, avec des ajouts vocaux et visuels et un accent sur la latence. Des essais chez des partenaires cités indiquent des gains de temps importants, tandis que les classements publics consacrent d’autres acteurs, notamment Liquid et Base Lab.
Les indices privilégient d'autres modèles devant OpenAI
Deux benchmarks publics, l’AIM System One Index et l’Artificial Analysis Decision Index, mettent en avant D1 Ultra de Liquid, publié la semaine précédente, ainsi qu’Elephant-1 de Base Lab. Le dernier modèle Jev de TypeSafe reste bien positionné, avec une septième et une troisième place selon l’index. Le modèle de décision d’OpenAI apparaît plus bas, aux huitième et quatorzième rangs. Par ailleurs, les offres de TypeSafe sont actuellement les plus consultées sur OpenRouter. Un autre test, JevMan, fait jouer PacMan aux modèles de décision, où le dernier Jev domine ; son concepteur, Felix Wunderlich d’Opper AI, explique que le jeu impose un flux continu de décisions rapides, chaque intersection demandant un choix en quelques centaines de millisecondes.
Ouverture générale et options ajoutées par OpenAI
L’API de décision a été annoncée lors de la journée des développeurs du 29 septembre, puis rendue accessible à l’ensemble des clients un jeudi. La version publique ajoute des modalités vocales et visuelles. OpenAI a également travaillé à répartir géographiquement ses ressources d’inférence afin de réduire la latence selon les régions.
Choix techniques : Luna reconfiguré et gains de latence
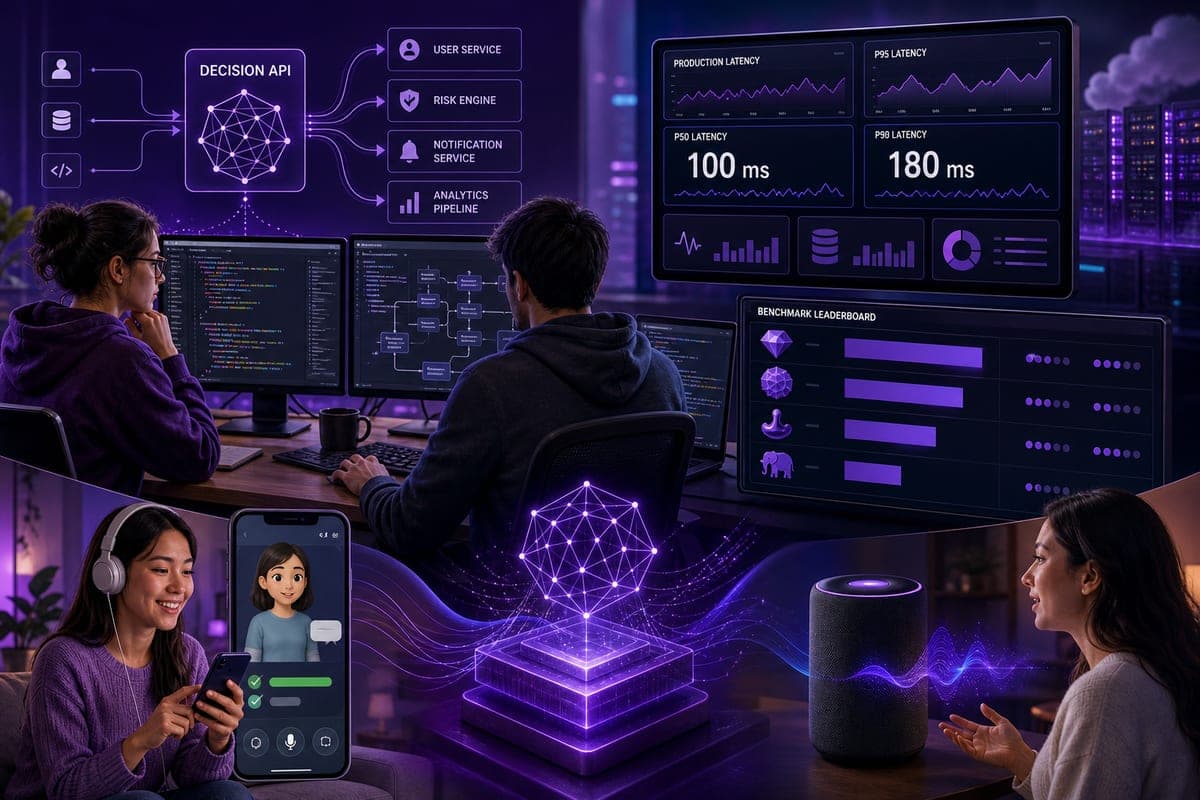
Plutôt que de concevoir un modèle calibré spécifique, OpenAI a reconfiguré ChatGPT Luna pour accélérer l’inférence et abaisser les coûts. Selon Nikunj Handa, cela a ramené les temps de traitement d’un intervalle d’une à trois secondes à 100, 120 et 180 millisecondes. Il précise qu’un entraînement ciblé pourrait suivre, mais que Luna est le moteur actuel. Handa met aussi en avant un atout potentiel en multi-modalité : pour la classification d’images, Luna est décrit comme puissant et mieux calibré, tandis que des clients demandent davantage de flexibilité pour produire des sorties sous forme d’images.
Vous suivez la course aux modèles IA ?
Chaque sortie (GPT, Claude, Gemini, Mistral…) décryptée le soir même, en 5 min. Gratuit.
Inclus dès l'inscription : notre sélection des meilleurs guides & comparatifs IA.
Choisissez votre rythme
Gratuit · Pas de spam · Désabonnement en 1 clic
Premiers usages : remplacements de LLM et chiffres chez Speak
Lors d’essais initiaux avec des clients comme Box, Datadog, Ramp et Speak, des équipes ont employé l’API pour remplacer des LLM d’OpenAI tout en augmentant le débit. Selon Andrew Hsu, CTO de Speak, le délai entre deux actions est passé de 1,4 seconde à 0,13 seconde. Ce produit a aussi été adopté par OpenAI afin d’accroître la réactivité de son assistant vocal Dots.
Un cadre concurrentiel défini mais des critères mouvants
OpenAI rend son API de décision largement disponible sur un marché où TypeSafe, fondée par un ancien chercheur d’un laboratoire de pointe, a atteint 7,6 milliards de dollars de valorisation. Le modèle Jev a popularisé l’approche des super classificateurs, capables de choisir parmi des options et d’indiquer une confiance, et des développeurs rapportent qu’ils remplacent des LLM plus lents et coûteux pour certains flux. Chez OpenAI, Nikunj Handa évoque une multitude de cas d’usage possibles. Les critères d’un « bon » modèle de décision demeurent toutefois variables selon les tâches, entre intelligence, coût, calibration et vitesse. Diogo Almeida, PDG de TypeSafe, se montre prudent vis-à-vis des benchmarks et recommande des tests en contexte, bien que TypeSafe ait publié la semaine précédente ses propres classements avec un nouveau Jev intégrant le support des images et des déclarations intelligentes. Handa vise encore des gains de latence vers 60 millisecondes et anticipe l’émergence d’un grand nombre de cas d’usage à mesure que ces modèles se diffusent.