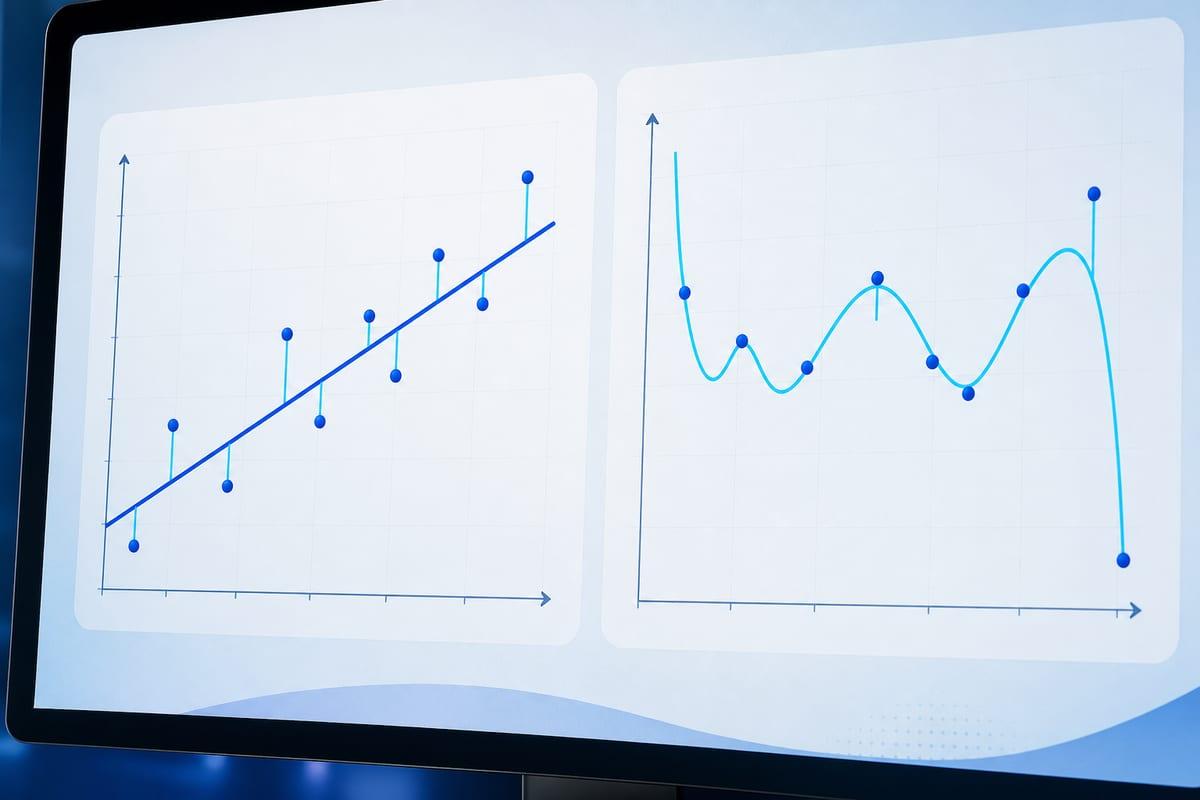
Dans Régression & MLE, remplacer une droite par une courbe de degré 7 abaisse l'erreur affichée de 0,236 à 0,134, tandis que la courbe prend des valeurs extrêmes aux bords du graphique. L'outil permet de comparer l'ajustement aux exemples et les prédictions hors de leur plage.
Les prédictions divergent hors des exemples
Pour une même abscisse de 9,9, la droite fournit 8,461, contre 14,286 pour la courbe. Cette dernière épouse davantage les points disponibles, mais ses valeurs deviennent extrêmes aux extrémités. À cette abscisse, située après le dernier exemple, l'interface signale une extrapolation. Cette alerte relève d'un choix de conception de l'outil, pas d'une capacité de la droite à reconnaître ses limites.
La droite traite des coordonnées, sans connaître ce qu'elles désignent. Dans un exemple associant durée de révision et résultat scolaire, elle attribuerait ainsi 36 sur 10 à 50 heures d'étude. Le calcul resterait conforme au modèle, même si cette note n'a pas de sens.
Les modèles de grande taille peuvent eux aussi appliquer leurs paramètres à des situations où leur réponse perd sa pertinence. Un outil d'IA mobilise les exemples de son apprentissage sans savoir si le cas présenté leur ressemble. Une demande concernant un client atypique, un produit nouveau ou une année inhabituelle peut donc recevoir une réponse aussi assurée en apparence qu'une demande ordinaire, malgré un résultat dénué de sens.
Les traits gris matérialisent les résidus
Les traits gris verticaux matérialisent les résidus, autrement dit les écarts entre les observations et la droite. Pour obtenir l'erreur quadratique moyenne, ou MSE, chaque écart est élevé au carré, puis leur somme est divisée par le nombre d'observations. Le carré évite que des écarts de signes contraires se compensent et pénalise davantage les grandes erreurs. Cette méthode porte le nom de moindres carrés ; la perte est la quantité que l'entraînement cherche à minimiser.
Après activation de la commande Effacer, des clics permettent de constituer un nouvel ensemble d'observations, avec un réajustement à chaque ajout. Pour un point isolé, une infinité de droites conviennent et la MSE vaut 0 ; le logiciel choisit l'horizontale. Deux points suffisent également à obtenir une erreur de 0, puisque la droite les traverse exactement. À l'arrivée d'un troisième point non aligné, l'ajustement parfait devient impossible : les deux paramètres disponibles ne suffisent plus à traverser toutes les observations.
La recherche en IA vous passionne ?
Les papers et avancées qui comptent, expliqués simplement, chaque soir. Gratuit.
Inclus dès l'inscription : notre sélection des meilleurs guides & comparatifs IA.
Choisissez votre rythme
Gratuit · Pas de spam · Désabonnement en 1 clic
Avec trois ou quatre observations, une alerte de surapprentissage peut apparaître. Le logiciel écarte tour à tour chacune d'elles, ajuste la droite sur les autres, puis mesure l'écart sur l'observation exclue. Un ensemble aussi restreint peut donner de mauvais résultats sur le point non utilisé ; l'alerte s'efface généralement avec cinq observations. Un autre exercice compare le déplacement du premier point à celui du cinquième : une observation située à une extrémité exerce davantage d'influence sur la droite qu'une observation centrale.
Deux paramètres résument les observations initiales
Au démarrage, le graphique réunit dix observations, chacune définie par une coordonnée horizontale x et une coordonnée verticale y. Ces couples pourraient associer une durée d'étude à une note, ou la superficie d'un appartement à son prix. La commande Réinitialiser restaure cet ensemble de départ.
La droite constitue ici le modèle, entièrement décrit par sa pente et son ordonnée à l'origine. Son équation initiale, y = 0,687·x + 1,658, contient donc dans ces coefficients ce que l'ajustement a retenu des observations. Chercher ces paramètres en minimisant la MSE correspond à l'entraînement. Déplacer le cinquième point vers le haut fait légèrement pivoter la droite dans sa direction et augmente l'erreur ; les coefficients changent pendant la manipulation.
À chaque déplacement, une formule recalcule directement les paramètres donnant l'erreur minimale. Les grands modèles procèdent plutôt par corrections successives de leurs nombreux paramètres, avec le même objectif de réduction de l'erreur. Prédire consiste ensuite à employer le modèle pour une abscisse absente des exemples : à x = 4, l'interface indique y = 4,407, représenté par un point vert.
Les origines des moindres carrés et de la régression
Adrien-Marie Legendre a publié la méthode des moindres carrés en 1805. En 1809, Carl Friedrich Gauss a déclaré qu'il l'employait depuis 1795.
Le nom de régression remonte, lui, aux recherches de Francis Galton sur la taille humaine en 1886. Il comparait la taille des enfants à la moyenne de celles de leurs deux parents et constatait chez les enfants un écart plus faible à la moyenne de la population. À titre d'illustration, une moyenne parentale supérieure de 6 cm à cette référence correspondait à des enfants la dépassant d'environ 4 cm.
D'après le calcul de Galton, les enfants conservaient environ deux tiers de l'écart parental à la moyenne. Cette tendance à s'en rapprocher a donné son nom à la régression, sans que le terme désigne un retour en arrière.