RoPE, apparu en 2021 avec RoFormer, est devenu la principale méthode de représentation des positions dans les grands modèles de langage modernes. Son principe diffère de celui des vecteurs appris de GPT-2 : l'information de position intervient à l'intérieur du mécanisme d'attention.
RoPE fait tourner les vecteurs de requête et de clé
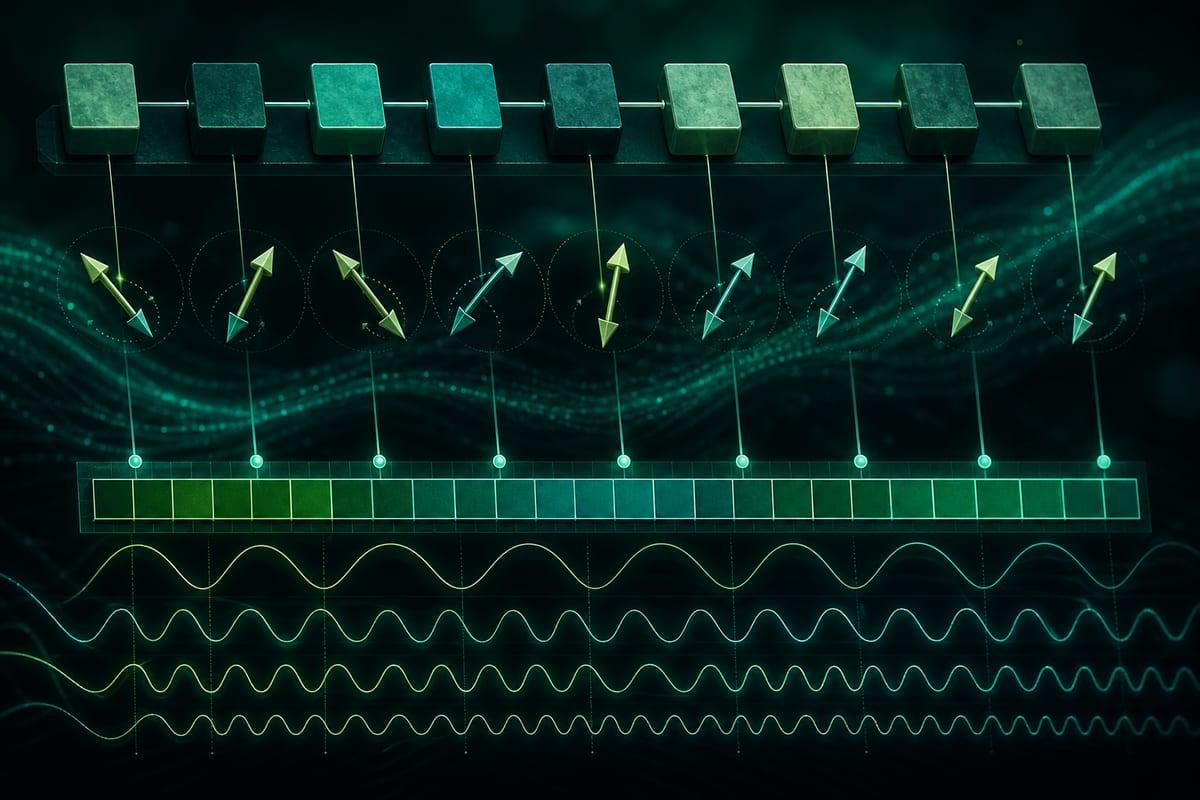
Avec RoPE, les représentations initiales des tokens ne reçoivent pas d'ajout positionnel. Ce sont les vecteurs dits de requête et de clé qui subissent une rotation, déterminée par la place du token dans la séquence.
Cette opération intervient dans chaque couche d'attention. Les méthodes antérieures, elles, apportaient l'information de position au moment de construire la représentation initiale des tokens.
GPT-2 apprend ses positions, le codage sinusoïdal les calcule
Dans GPT-2, chaque emplacement possède son propre vecteur, appris durant l'entraînement selon un principe comparable à celui des représentations des mots. Ce vecteur s'additionne à celui du token : « fox » reçoit ainsi un ajout différent aux positions 3 et 7, et sa représentation diffère pour l'attention. Mais GPT-2 ne possède que 1 024 vecteurs positionnels appris : aucun ne correspond à la position 1 025. Avec cette méthode, la longueur du contexte doit donc être fixée avant l'entraînement.
La recherche en IA vous passionne ?
Les papers et avancées qui comptent, expliqués simplement, chaque soir. Gratuit.
Inclus dès l'inscription : notre sélection des meilleurs guides & comparatifs IA.
Choisissez votre rythme
Gratuit · Pas de spam · Désabonnement en 1 clic
En 2017, le travail initial sur les transformateurs présentait une autre solution : calculer les représentations positionnelles avec des fonctions sinus et cosinus. Aucun paramètre positionnel n'est alors à apprendre. Les différentes paires de caractéristiques suivent des oscillations de fréquences distinctes.
L'attention seule ne repère pas l'ordre
Au centre des transformateurs, l'attention détermine ce qui est pertinent pour un token en examinant les autres tokens. Son calcul utilise des produits scalaires entre vecteurs, sans disposer à lui seul d'une indication sur leur ordre dans la séquence.
L'information positionnelle apporte ce repère manquant. Qu'elle soit apprise, calculée par des fonctions sinusoïdales ou intégrée par rotation, elle permet au modèle de tenir compte de l'ordre des mots et de mieux saisir les nuances linguistiques.