Tu suis la course aux modèles IA ?
Chaque sortie (GPT, Claude, Gemini, Mistral…) décryptée le soir même, en 5 min. Gratuit.
Inclus dès l'inscription : notre sélection des meilleurs guides & comparatifs IA.
Choisis ton rythme
Gratuit · Pas de spam · Désabonnement en 1 clic
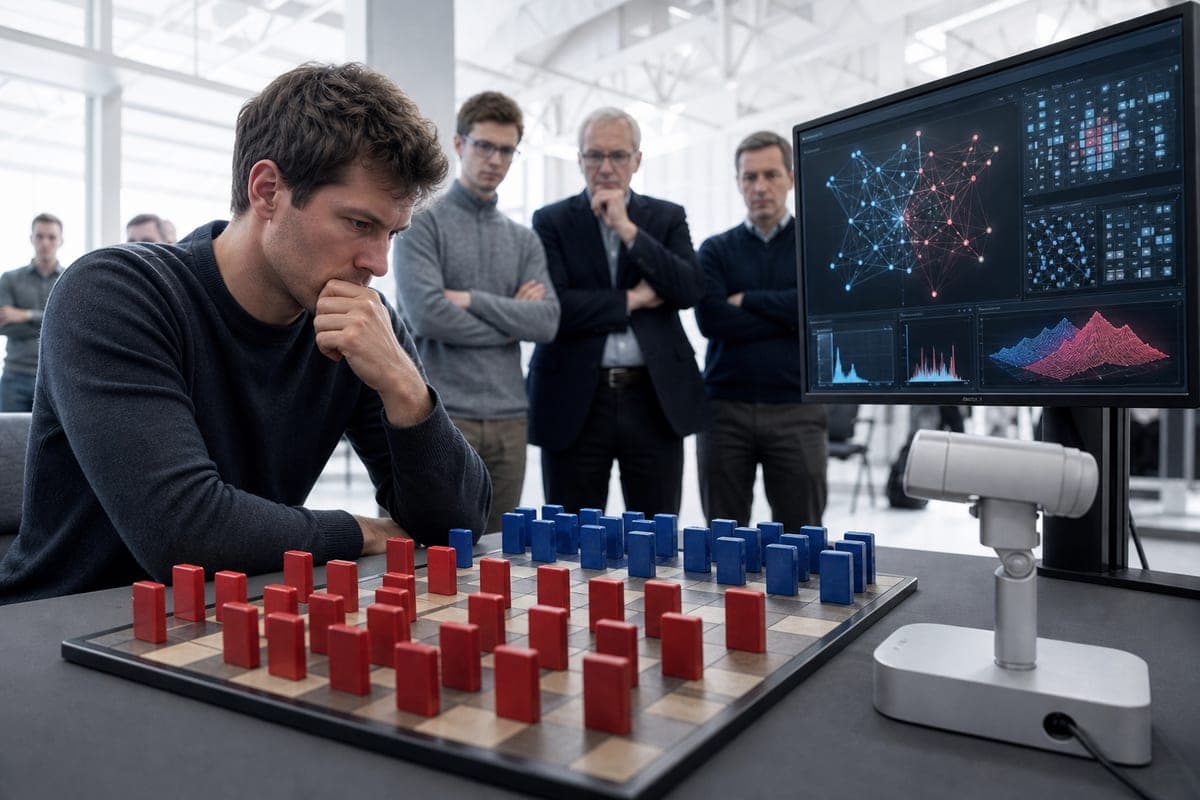
Ataraxos, développée par des chercheurs de Carnegie Mellon, NYU, Stanford et MIT, a battu Pim Niemeijer lors de 20 parties officielles. L’entraînement a coûté moins de 8 000 dollars et une première performance surhumaine à Stratego a été revendiquée. La même méthode s’étend à d’autres jeux à information incomplète, tout en admettant une limite sur la montée en puissance. Le code est publié.
Une portée revendiquée au-delà du jeu, avec une limite assumée
L’abondance d’informations cachées ne constitue plus un verrou pour l’apprentissage par renforcement et la recherche. Ils ajoutent que cette avancée pourrait se traduire dans des décisions stratégiques variées, sous réserve de simulateurs rapides et fidèles, en citant notamment les marchés financiers, les conflits militaires et les négociations. Les chercheurs précisent toutefois une limite : leur recherche ne simule qu’une seule étape d’apprentissage, ce qui empêche d’améliorer indéfiniment la performance en ajoutant du calcul, même s’ils jugent qu’une recherche plus élaborée pourrait atténuer ce point. Le code d’Ataraxos est rendu public. Au-delà de Stratego, la même méthode a servi ailleurs : nouveaux records dans Hanabi, avec deux ordres de grandeur de calcul en moins pour la version à deux joueurs, succès face aux références PerfectDou et DouZero dans Dou dizhu, et quatre séries de 50 manches gagnées dans Stratego Barrage contre des joueurs classés parmi les meilleurs.
Un duel organisé sur trois semaines et un avantage humain d’adaptation
La confrontation avec Pim Niemeijer s’est étalée sur trois semaines, de manière à limiter la fatigue et à lui laisser le temps de se préparer. Ataraxos a remporté 15 victoires, concédé 1 défaite et obtenu 4 égalités. Son adversaire, quadruple champion du monde, quinze fois champion national néerlandais, double champion du monde en ligne et plus de 600 semaines numéro un, est décrit par George Franka comme le joueur le plus accompli du jeu. Niemeijer savait qu’Ataraxos ne s’adapterait pas à son style et a perçu 1 000 dollars, plus des primes par victoire et par match nul. Les 85 % de réussite effective sont qualifiés d’inédits au plus haut niveau, tandis que Max Roelofs rappelle l’étroitesse des marges au sommet. L’asymétrie d’adaptation jouait en faveur de l’humain, et Vincent de Boer y voit un handicap majeur pour l’IA. En marge, lors d’une exposition au championnat du monde 2025, Ataraxos a gagné 38 parties sur 40 contre des joueurs de tournoi. Plusieurs participants décrivent un style difficile à lire, ponctué de bluffs jugés trop risqués, de phases de temporisation mal perçues et d’un sentiment récurrent de « chance » lié au placement des pièces. Les parties contre Niemeijer sont consultables en ligne.
Régularisation et réseau de croyance guident chaque décision
Ataraxos apprend sans données humaines, par auto-jeu, et introduit une contrainte de régularisation pour diversifier placements et coups. La nécessité de la randomisation à Stratego pour éviter la prévisibilité est soulignée. La pression de régularisation diminue au fil de l’entraînement, avec des pas d’apprentissage adaptés : exploration large puis ajustements fins. Les chercheurs expliquent que cette dynamique évite les cycles et phénomènes chaotiques typiques des jeux à information incomplète, comparant la régularisation à une réserve d’énergie qui, si elle est épuisée trop tôt, conduit à des gains rapides mais fragiles. À chaque coup, un réseau de croyance anticipe les pièces adverses, génère des hypothèses d’états, simule des options et déclenche un apprentissage localisé spécifique à la décision. Des travaux antérieurs avaient renoncé à ce type de recherche jugé trop complexe face à la quantité d’informations cachées.
Des moyens limités et une comparaison impossible avec DeepNash
L’entraînement s’est déroulé sur 16 GPU H100 pendant une semaine, complété de quatre jours sur quatre GPU pour le réseau de croyance. Les chercheurs estiment le coût à moins de 8 000 dollars aux prix de 2025 et évaluent leurs besoins à environ 1/500 du calcul, 1/30 des parties d’auto-jeu et 1/100 des exemples d’entraînement par rapport à DeepNash. Ils attribuent ces écarts à un simulateur GPU dédié et à une meilleure efficacité d’échantillonnage, dans un cadre de ressources académiques rappelé par Samuel Sokota. DeepNash, pour sa part, a tourné sur 1 024 nœuds TPU pendant deux à trois mois, et le coût d’Ataraxos est estimé entre 3 et 4,5 millions de dollars en 2025. Il n’a pas été possible d’effectuer une comparaison directe : les chercheurs affirment avoir fourni l’infrastructure, mais DeepMind a répondu que le code de DeepNash n’était plus utilisable. Au championnat du monde 2023, DeepNash a gagné 19 parties sur 28, mais s’est incliné face à la majorité des meilleurs joueurs, dont Niemeijer.
Pourquoi Stratego résiste : 40 pièces cachées et 10^33 états
Chaque joueur aligne 40 pièces masquées et le rang ne se révèle qu’à l’affrontement, la victoire revenant à celui qui capture le drapeau adverse. Les chercheurs estiment le nombre de configurations au-delà de 10^33 et rappellent, via Samuel Sokota, que la valeur d’une action dépend aussi de l’historique dans les jeux à information incomplète. C’est dans ce cadre qu’Ataraxos, développé par une équipe académique, revendique une première performance surhumaine à Stratego et une victoire nette face à Pim Niemeijer en 20 parties officielles.