Tu suis la course aux modèles IA ?
Chaque sortie (GPT, Claude, Gemini, Mistral…) décryptée le soir même, en 5 min. Gratuit.
Inclus dès l'inscription : notre sélection des meilleurs guides & comparatifs IA.
Choisis ton rythme
Gratuit · Pas de spam · Désabonnement en 1 clic
Un spécialiste de l'ajustement de Claude chez Anthropic relie la dégradation perçue du style à des choix d'entraînement récents. Il évoque un arbitrage en faveur des mathématiques et du code, et des explications calibrées pour des modèles d'IA. Opus 5.5 viserait un meilleur équilibre, sans dépasser à coup sûr les performances rédactionnelles d'Opus 4.6.
Opus 5.5 cherche l’équilibre sans détrôner Opus 4.6
Jackson Kernion affirme qu’avec Opus 5.5, Anthropic a trouvé un meilleur équilibre. Il ajoute n’avoir pas été aussi satisfait de l’écriture d’un modèle depuis Opus 4.6. Il précise toutefois qu’Opus 5.5 ne surpasse pas nécessairement le modèle plus ancien. Auparavant, il présentait Opus 4.6 comme le dernier bon modèle d’écriture d’Anthropic.
Des explications formatées pour des LLM, pas pour des humains
Kernion précise que les modèles ont été entraînés à générer des explications techniques à destination d’autres systèmes d’IA, ce qui conduit à des formulations qualifiées de « Claudeish ». Il explique que le modèle a été ajusté pour correspondre à la façon de penser des LLM et qu’il a appris à rédiger en s’adressant à des IA plutôt qu’à des personnes. Selon lui, les LLM disposent d’une mémoire de travail bien plus importante et saisissent les détails à un niveau plus fin. À l’entraînement, il en résulte un style efficace pour les modèles d’IA, mais perçu par les lecteurs comme des décharges d’informations trop denses. Il compare cette situation à un groupe de personnes qui ne communiqueraient qu’entre elles, développant un style difficile à suivre pour les autres.
L’optimisation pour le code impose de compenser côté langage
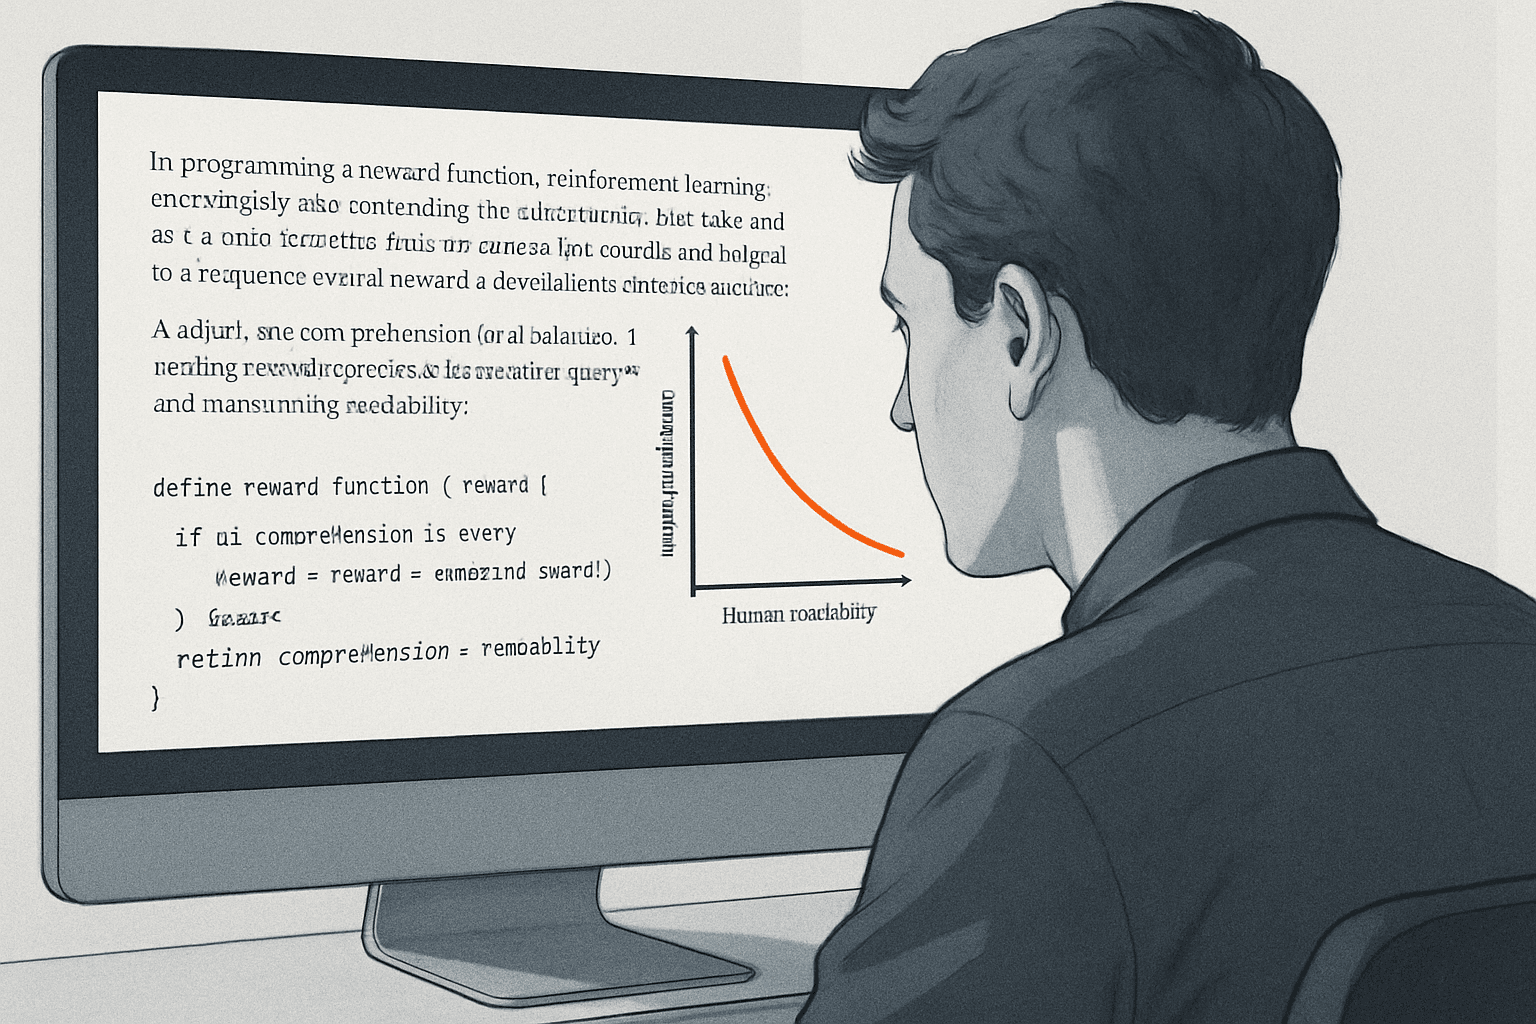
Kernion situe le cœur du problème dans la structure de récompense de l’apprentissage par renforcement, où certaines récompenses favorisent la compréhension par les modèles et d’autres par les humains. Plus l’entraînement cible les mathématiques et le code, plus il faut compenser activement en récompensant des explications simples accessibles aux lecteurs humains. Il relie la dégradation du style écrit à cette optimisation vers les tâches techniques. En parallèle, les performances progressent rapidement en mathématiques, en code et en raisonnement, alors que la qualité de l’écriture a stagné ou empiré.