En 2025, 85 % des développeurs utilisent régulièrement des outils d’intelligence artificielle pour coder ou développer, tandis que 62 % s’appuient sur au moins un assistant de programmation, un agent ou un éditeur augmenté par l’IA. L’IA pour développeurs n’est donc plus une expérimentation réservée à quelques équipes : elle s’intègre dans l’éditeur, les pull requests, les tests et la maintenance quotidienne.
Le gain le plus visible concerne la production de code. Les assistants comme GitHub Copilot, Claude Code, OpenAI Codex ou les environnements intégrant des agents peuvent compléter une fonction, expliquer une base de code, générer un test ou préparer une modification multi-fichiers. Mais l’accélération ne se résume pas au nombre de lignes écrites : la qualité des spécifications, la couverture des tests et la validation humaine déterminent une grande partie du résultat.
Les données disponibles montrent un bénéfice réel, mais variable. Près de neuf développeurs sur dix interrogés en 2025 déclarent économiser au moins une heure par semaine grâce à l’IA, et un développeur sur cinq estime gagner huit heures ou plus. Ces chiffres mesurent un bénéfice déclaré, pas une garantie de productivité pour chaque projet. Une équipe peut écrire plus vite tout en augmentant sa dette technique si elle accepte du code insuffisamment testé ou mal intégré à l’architecture existante.
Ce guide présente une méthode opérationnelle : choisir un assistant selon le contexte, l’utiliser pour la revue et les tests, mesurer les gains sur le cycle complet et limiter les risques. L’objectif n’est pas de remplacer l’ingénierie logicielle, mais de déplacer le temps des tâches répétitives vers la conception, la vérification et les décisions techniques.
Le brief IA que les pros lisent chaque soir
Les 7 actus IA du jour, décryptées en 5 min. Gratuit.
Inclus dès l'inscription : notre sélection des meilleurs guides & comparatifs IA.
Choisis ton rythme
Gratuit · Pas de spam · Désabonnement en 1 clic
01Ce que l’IA change réellement dans le travail quotidien des développeurs
Un assistant de code moderne intervient à plusieurs niveaux. Dans l’éditeur, il propose des complétions et des modifications contextualisées. Dans le chat, il explique une erreur, transforme une fonction ou aide à explorer un dépôt. Avec les agents, il peut enchaîner la lecture de fichiers, la modification du code et l’exécution de commandes, sous réserve des autorisations accordées par l’équipe.
Les usages les plus rentables sont généralement ceux qui disposent d’un résultat vérifiable :
- ▹Générer des tests unitaires à partir d’un comportement attendu.
- ▹Convertir une fonction ou une API vers une nouvelle version.
- ▹Documenter un module existant.
- ▹Rechercher les appels d’une fonction dans un dépôt.
- ▹Produire un premier brouillon de requête SQL ou de code répétitif.
- ▹Résumer une pull request et signaler les fichiers sensibles.
L’IA est moins fiable lorsqu’elle doit déduire seule une règle métier implicite, choisir une architecture engageante ou modifier un système sans tests. Elle peut produire du code syntaxiquement valide mais incompatible avec les contraintes de sécurité, de performance ou de déploiement.
L’enquête JetBrains menée auprès de 24 534 développeurs dans 194 pays indique que 85 % utilisent régulièrement des outils d’IA pour le développement et que 62 % utilisent au moins un assistant, agent ou éditeur de code basé sur l’IA. Elle indique aussi que les développeurs citent des facteurs techniques et non techniques comme déterminants de leur performance : l’outil ne remplace donc ni l’organisation du travail ni la qualité de l’environnement de développement.
La bonne pratique consiste à réserver l’automatisation complète aux tâches bornées, réversibles et testables. Pour les décisions d’architecture, les changements de sécurité et les migrations critiques, l’IA doit rester un copilote soumis à une validation explicite.
02Assistants de code en 2026 : comparer les usages plutôt que les promesses
Le choix d’un assistant dépend moins de son nom que de son intégration au cycle de développement. Un outil intégré à GitHub sera pertinent pour une équipe qui centralise ses pull requests et son dépôt sur cette plateforme. Un agent exécuté dans le terminal conviendra davantage aux développeurs qui travaillent avec des scripts, des tests et des workflows reproductibles.
| Solution ou catégorie | Usage principal | Point fort opérationnel | Mode de facturation identifié |
|---|---|---|---|
| GitHub Copilot | Complétion, chat, revue et agents | Intégration à l’écosystème GitHub | Pro à 10 $ par mois ; Business à 19 $ par utilisateur et par mois ; Enterprise à 39 $ par utilisateur et par mois |
| Agent de code dans le terminal | Modification multi-fichiers et exécution de tâches | Workflow proche des outils CLI et des tests locaux | Dépend du fournisseur et de la consommation du modèle |
| Éditeur de code augmenté par l’IA | Navigation, génération et édition contextualisée | Boucle rapide entre recherche et modification | Dépend de l’éditeur et de l’offre choisie |
| Modèle généraliste avec dépôt fourni en contexte | Explication, conception et débogage | Polyvalence pour les problèmes complexes | Dépend de l’abonnement ou de l’API |
Pour GitHub Copilot, les offres individuelles publiées pour 2026 incluent une formule gratuite, Copilot Pro à 10 $ par mois, Pro+ à 39 $ par mois et Max à 100 $ par mois. Les offres d’organisation indiquées sont Business à 19 $ par utilisateur et par mois et Enterprise à 39 $ par utilisateur et par mois.
Le prix ne suffit pas pour comparer. Mesurez aussi la qualité des suggestions dans votre langage, la conservation du contexte, la compatibilité avec votre IDE, les contrôles de confidentialité, les journaux d’utilisation et les limites liées aux fonctions agentiques. Une équipe devrait commencer par un groupe pilote, avec les mêmes tickets et critères de revue avant et après activation.
03Revue de code et tests : les usages les plus faciles à sécuriser
La revue assistée par IA fonctionne mieux comme première passe que comme approbation automatique. L’assistant peut repérer une condition limite, une duplication, une absence de test ou un changement de comportement apparent. Il ne connaît toutefois pas nécessairement les invariants métier ni les arbitrages acceptés par l’équipe.
Un flux de revue robuste suit quatre étapes :
- ▹Fournir au modèle le ticket, les règles de contribution et les fichiers pertinents.
- ▹Lui demander de distinguer les erreurs certaines, les risques probables et les suggestions optionnelles.
- ▹Exiger une reproduction ou un test pour les défauts signalés.
- ▹Faire valider la pull request par un développeur responsable du domaine.
Pour les tests, l’IA est particulièrement utile pour générer des cas nominaux, des cas limites et des tests de régression à partir d’un bug documenté. La demande doit préciser le framework, les fixtures disponibles, les effets de bord attendus et la commande de vérification. Une instruction vague comme « ajoute des tests » produit souvent des tests superficiels qui suivent l’implémentation au lieu de vérifier le comportement.
Les tests générés doivent être exécutés dans le pipeline, puis relus. Un test qui passe n’est pas automatiquement pertinent : il peut ne jamais exercer le cas important, accepter une sortie incorrecte ou reproduire le même défaut logique que le code testé. Les indicateurs utiles sont la couverture des branches, le taux de régression, le nombre de défauts détectés avant production et le temps de correction après revue.
L’IA peut également résumer une pull request, proposer une checklist ou classer les fichiers à risque. Ces usages réduisent le temps de lecture sans donner à l’outil le pouvoir de fusionner seul des changements sensibles.
04Dette technique : accélérer sans transformer le code généré en passif
La dette technique augmente lorsque les décisions rapides créent un coût futur supérieur au bénéfice immédiat. L’IA peut la réduire en documentant un module, en identifiant du code mort, en modernisant une API ou en préparant une refactorisation progressive. Elle peut aussi l’aggraver si elle ajoute des abstractions inutiles, du code dupliqué ou des dépendances mal maîtrisées.
Avant toute intervention, il faut définir une cible mesurable : réduire la complexité d’un module, supprimer une dépendance, diminuer le temps d’exécution d’une requête ou augmenter la couverture d’une zone critique. Le prompt doit demander une modification limitée, expliquer les contraintes et interdire les changements non nécessaires.
Une méthode de travail efficace consiste à :
- ▹Cartographier les dépendances et les points d’entrée avant modification.
- ▹Demander un plan de refactorisation séparé du patch.
- ▹Découper le changement en petites pull requests réversibles.
- ▹Ajouter ou renforcer les tests avant la transformation.
- ▹Mesurer les performances et les erreurs avant et après.
- ▹Vérifier les dépendances, licences et secrets exposés.
L’assistant peut accélérer l’analyse d’un vieux dépôt, mais il ne doit pas être l’unique source de vérité sur son fonctionnement. Les commentaires historiques, les contrats d’API, les métriques de production et les décisions d’architecture restent indispensables.
Pour suivre l’effet sur la dette, combinez des mesures techniques et opérationnelles : âge moyen des tickets de maintenance, volume de code dupliqué, complexité cyclomatique, défauts récurrents, temps de revue et fréquence des incidents. Une baisse du temps de génération ne constitue pas un gain si le temps de correction et de revue augmente ensuite.
05Mesurer les gains de l’IA avec des indicateurs d’ingénierie
Les déclarations de productivité sont utiles pour détecter une tendance, mais elles ne remplacent pas une mesure sur le dépôt. L’enquête JetBrains 2025 rapporte que près de neuf développeurs sur dix économisent au moins une heure par semaine et qu’un sur cinq économise huit heures ou plus. Ces résultats peuvent servir de repère, pas d’objectif universel.
Un programme de mesure doit comparer une période de référence avec une période d’utilisation, sur des tâches comparables. Les indicateurs à suivre sont :
- ▹Temps entre le début d’un ticket et sa première version revue.
- ▹Délai entre l’ouverture et la fusion d’une pull request.
- ▹Nombre de cycles de revue par changement.
- ▹Taux d’échec du pipeline et fréquence des corrections après fusion.
- ▹Défauts détectés en production.
- ▹Couverture et mutation testing sur les zones ciblées.
- ▹Temps consacré à la documentation et à la maintenance.
- ▹Coût mensuel des licences et de la consommation de modèles.
Le niveau individuel ne suffit pas. Un développeur peut produire davantage de code, tandis que l’équipe accumule davantage de corrections. Le bon niveau d’analyse est donc le cycle complet : idée, ticket, implémentation, revue, test, déploiement et maintenance.
Pour chaque cas d’usage, définissez une hypothèse. Exemple : « La génération de tests réduit de 20 % le délai de préparation d’une pull request sans augmenter les défauts post-déploiement. » Mesurez ensuite sur plusieurs semaines, comparez les résultats à un groupe ou à une période témoin et recueillez des exemples qualitatifs.
Le retour sur investissement doit intégrer le prix de l’outil, le temps de formation, la revue supplémentaire et le coût des erreurs. Un assistant peu cher mais mal adapté au dépôt peut coûter davantage qu’une solution plus onéreuse qui réduit réellement les délais et les régressions.
06Déployer une IA de développement avec des garde-fous concrets
Un déploiement réussi commence par une politique claire. Elle doit préciser les dépôts autorisés, les données interdites, les règles de validation, les responsabilités humaines et les conditions d’utilisation des agents. Les secrets, clés privées, données personnelles et informations client ne doivent pas être transmis à un service sans contrôle contractuel et technique approprié.
Commencez par deux ou trois cas d’usage à faible risque : documentation, génération de tests et résumé de pull requests. Évitez de commencer par la modification autonome de code de production ou par des migrations critiques. Le pilote doit réunir des développeurs de niveaux différents et couvrir plusieurs langages utilisés par l’organisation.
Avant la généralisation, vérifiez :
- ▹L’authentification et la gestion des droits de l’IDE à la production.
- ▹La journalisation des actions effectuées par les agents.
- ▹L’exécution automatique des tests et des contrôles de sécurité.
- ▹La possibilité d’annuler un changement et de restaurer un état connu.
- ▹La documentation des données envoyées au fournisseur.
- ▹La conservation d’une revue humaine pour les changements sensibles.
GitHub Copilot a adopté en 2026 une logique de crédits IA pour certaines fonctions consommant des modèles, tandis que les complétions et suggestions de prochaine modification restent indiquées comme illimitées dans les offres payantes présentées par plusieurs sources spécialisées. Cela rend le suivi de consommation important lorsque les équipes utilisent des agents ou des fonctions de revue à grande échelle.
La règle directrice est simple : l’IA peut proposer, expliquer et préparer ; les tests, les politiques de sécurité et les responsables techniques décident si le changement peut être livré.
Articles récents liés
Mis à jour en continu · 12 articles
IA ouverte : jusqu’à 50 % des modèles menacés
• Près de 50 % des modèles d’IA ouverts pourraient disparaître selon des estimations • Les offres propriétaires progress…
Mistral propose Large 4 à Ecosia après la rupture du partenariat
• Ecosia met fin à son partenariat avec Mistral, invoquant des performances jugées insuffisantes et des doutes sur la so…
Mistral investit 3 Md€ dans le calcul et lance Large 4
• Mistral a levé 3 milliards d'euros en septembre pour investir dans la capacité de calcul • Le 6 octobre, Mistral a lan…
IA : Argon, Haiku 5.5 et Large 4 entre accès limité et coût
• Google réserve Gemini 4 Argon à des équipes cybersécurité via Fairwind • Mistral Large 4 est accessible en aperçu publ…
Mistral Large 4 en préversion, poids ouverts le 26 octobre
• Mistral Large 4 est disponible en préversion via API, avec publication des poids prévue le 26 octobre • Le modèle comb…
Mistral AI lance ML4 en open-weight, priorité cybersécurité
• Mistral AI présente ML4, un modèle multimodal accessible en open-weight • Entraînement sur 4 000 GPU en Europe, public…
Claude Haiku 5.5 testé comme assistant UI « junior »
• Un auteur prépare un test de design d'UI avec Claude Haiku 5.5 via Claude Code pour Desktop • Le protocole inclut un p…
Claude Code : Boris Cherny recommande des prompts simples
• Boris Cherny, créateur de Claude Code, recommande des prompts axés sur l'objectif, l'effort et la vérification • Un ex…
OpenAI lance une bêta, Claude arrive sur Google, écart IA de 3%
• L'écart en IA entre les États-Unis et la Chine atteint 3 %, avec DeepSeek V4.1 Flash en tête des benchmarks de codage …
Mistral aligne modèle, calcul et clients pour tenir son rang
• Large 4 présenté en préversion, publication des poids prévue le 27 octobre • Mistral a utilisé environ 4 000 GPU Nvidi…
Google mise sur des hubs locaux pour sourcer les startups IA
• Darren Mowry (Google) observe une opportunité de marché inédite en Europe de l'Ouest • Les fondateurs européens privil…
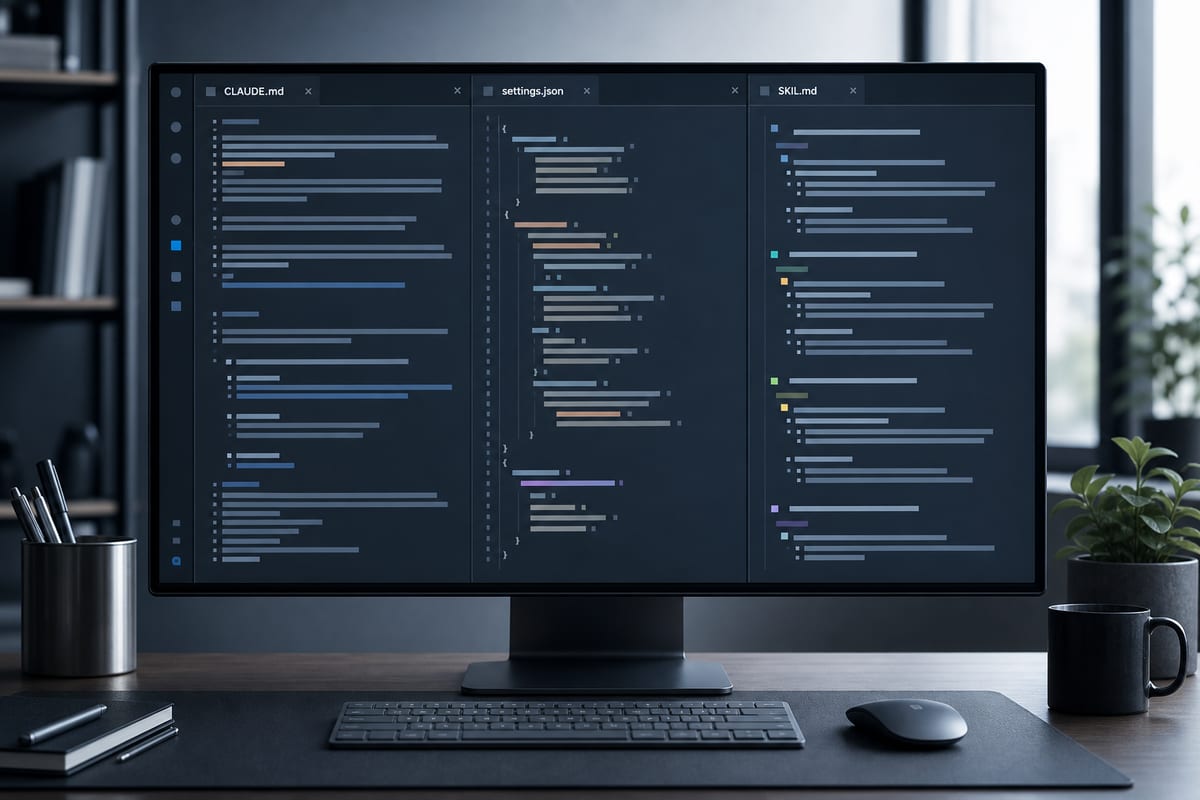
Claude Code : trois fichiers pour un usage plus fiable
• Une checklist de configuration rapide de 15 minutes est recommandée pour éviter les erreurs, dont le gonflement de CLA…
Questions fréquentes
Quel est le meilleur assistant IA pour les développeurs en 2026 ?+
Combien coûte GitHub Copilot en 2026 ?+
L’IA fait-elle vraiment gagner du temps aux développeurs ?+
Peut-on laisser une IA faire la revue de code seule ?+
Comment utiliser l’IA pour réduire la dette technique ?+
Quels indicateurs suivre pour mesurer l’impact de l’IA sur une équipe de développement ?+
Recevez les prochains guides par email
Un nouveau guide IA enrichi chaque jour, et l'essentiel de l'actu chaque soir.
Lu au bureau chez